
GPT-6爆改模型权重!数学能力狂飙6倍,MIT博一新作破圈了
新智元报道 这一天还是来了!不用训练、不算梯度,只让GPT-6 Astra改写另一款小模型0.016%权重,数学成绩就能原地暴涨6倍!今天,MIT计算机科学与人工智能实验室(CSAIL)带来的这项新研究,在全网彻底火了。他们首次提出了一个颠覆传统深度学习的新范式,「权重空间编程」。要知道,神经网络的权重文件里全是一眼望不到头...

检索标题、摘要与正文,把分散的信息连起来。
新智元报道 这一天还是来了!不用训练、不算梯度,只让GPT-6 Astra改写另一款小模型0.016%权重,数学成绩就能原地暴涨6倍!今天,MIT计算机科学与人工智能实验室(CSAIL)带来的这项新研究,在全网彻底火了。他们首次提出了一个颠覆传统深度学习的新范式,「权重空间编程」。要知道,神经网络的权重文件里全是一眼望不到头...
作者 | 青和、飞野编辑|四月11 月 2 日,麻省理工学院(MIT)联合团队的一份技术实验在社交网络引爆了近 600 万次围观。实验设定极具冲击力:不给训练数据,不跑反向传播,只给一个纯 Python 环境,让 OpenAI 的前沿大模型 GPT-6 Astra 直接读取、并重写开源模型 Qwen3.5-0.8B 的底层高维张量。最终,Astra 仅改动了 8 亿...

我「编程」我自己#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
几年前的埃里克·施密特很乐观,认为限制芯片,能够发挥十年左右的作用。现在,他自己把这个数字改了,在最新一场对话里,施密特说,中国和美国在AI上的差距可能只剩六个月,甚至提到,自己曾想投资DeepSeek,只是受美国法律限制没能投成。这次改口背后,有几件事让他印象很深。中国没有最先进的芯片,就想办法把模型做得更...
Opera推出全新网络标准WebAI,旨在让用户无需依赖云端,直接在浏览器运行AI模型。该标准兼容多种模型,以谷歌开源Gemma演示,也支持苹果设备端基础模型,不依赖特定模型,面向开放权重AI系统,是Opera此前探索浏览器本地运行大语言模型的延续。目前,WebAI已在旗舰浏览器Opera One中开启预览,用户需主动启用。

2026年10月26日,arXiv发布论文arXiv:2610.31838v1,提出Sense-Aligned Grounding Evaluation(SAGE)——一个统一的10候选图像选择基准,并配套训练无关的Gloss-Augmented Reasoning(GAR)框架,用于跨名词、动词和实体中心的多模态接地评估。

推荐理由:该研究首次将VWSD、VerSe和WikiDiverse三类任务统一为术语中心的接地评测协议,引入混淆难负样本与上下文交换诊断机制,并通过实证表明定义增强与约束引导推理的协同可显著提升Hits@1指标(65.90→71.22),为多模态语义对齐提供了更细粒度、可解释的评估新范式。
arXiv:2610.32055v1 发布类型:新 摘要:大型语言模型(LLMs)常常表现出阿谀奉承的倾向,即使在客观的事实性和推理类任务上,也会调整其回答以迎合用户的暗示。然而,这种影响的量化形式——以及它是否与信息源的可靠性相匹配——仍然知之甚少。在本研究中,我们通过在MMLU问题上观察提示诱导的答案偏移来探究这一现象,评估了诸如“[信息源]认为答案是(X)”这类提示。我们在三个开源模型系列——Qwen、Gemma和SmolLM——中系统性地改变了提示所归因的信息源(教授、朋友或狗),并发现由提示引发的变化遵循一种可预测的结构,该结构可用指数倾斜很好地刻画:提示会诱发
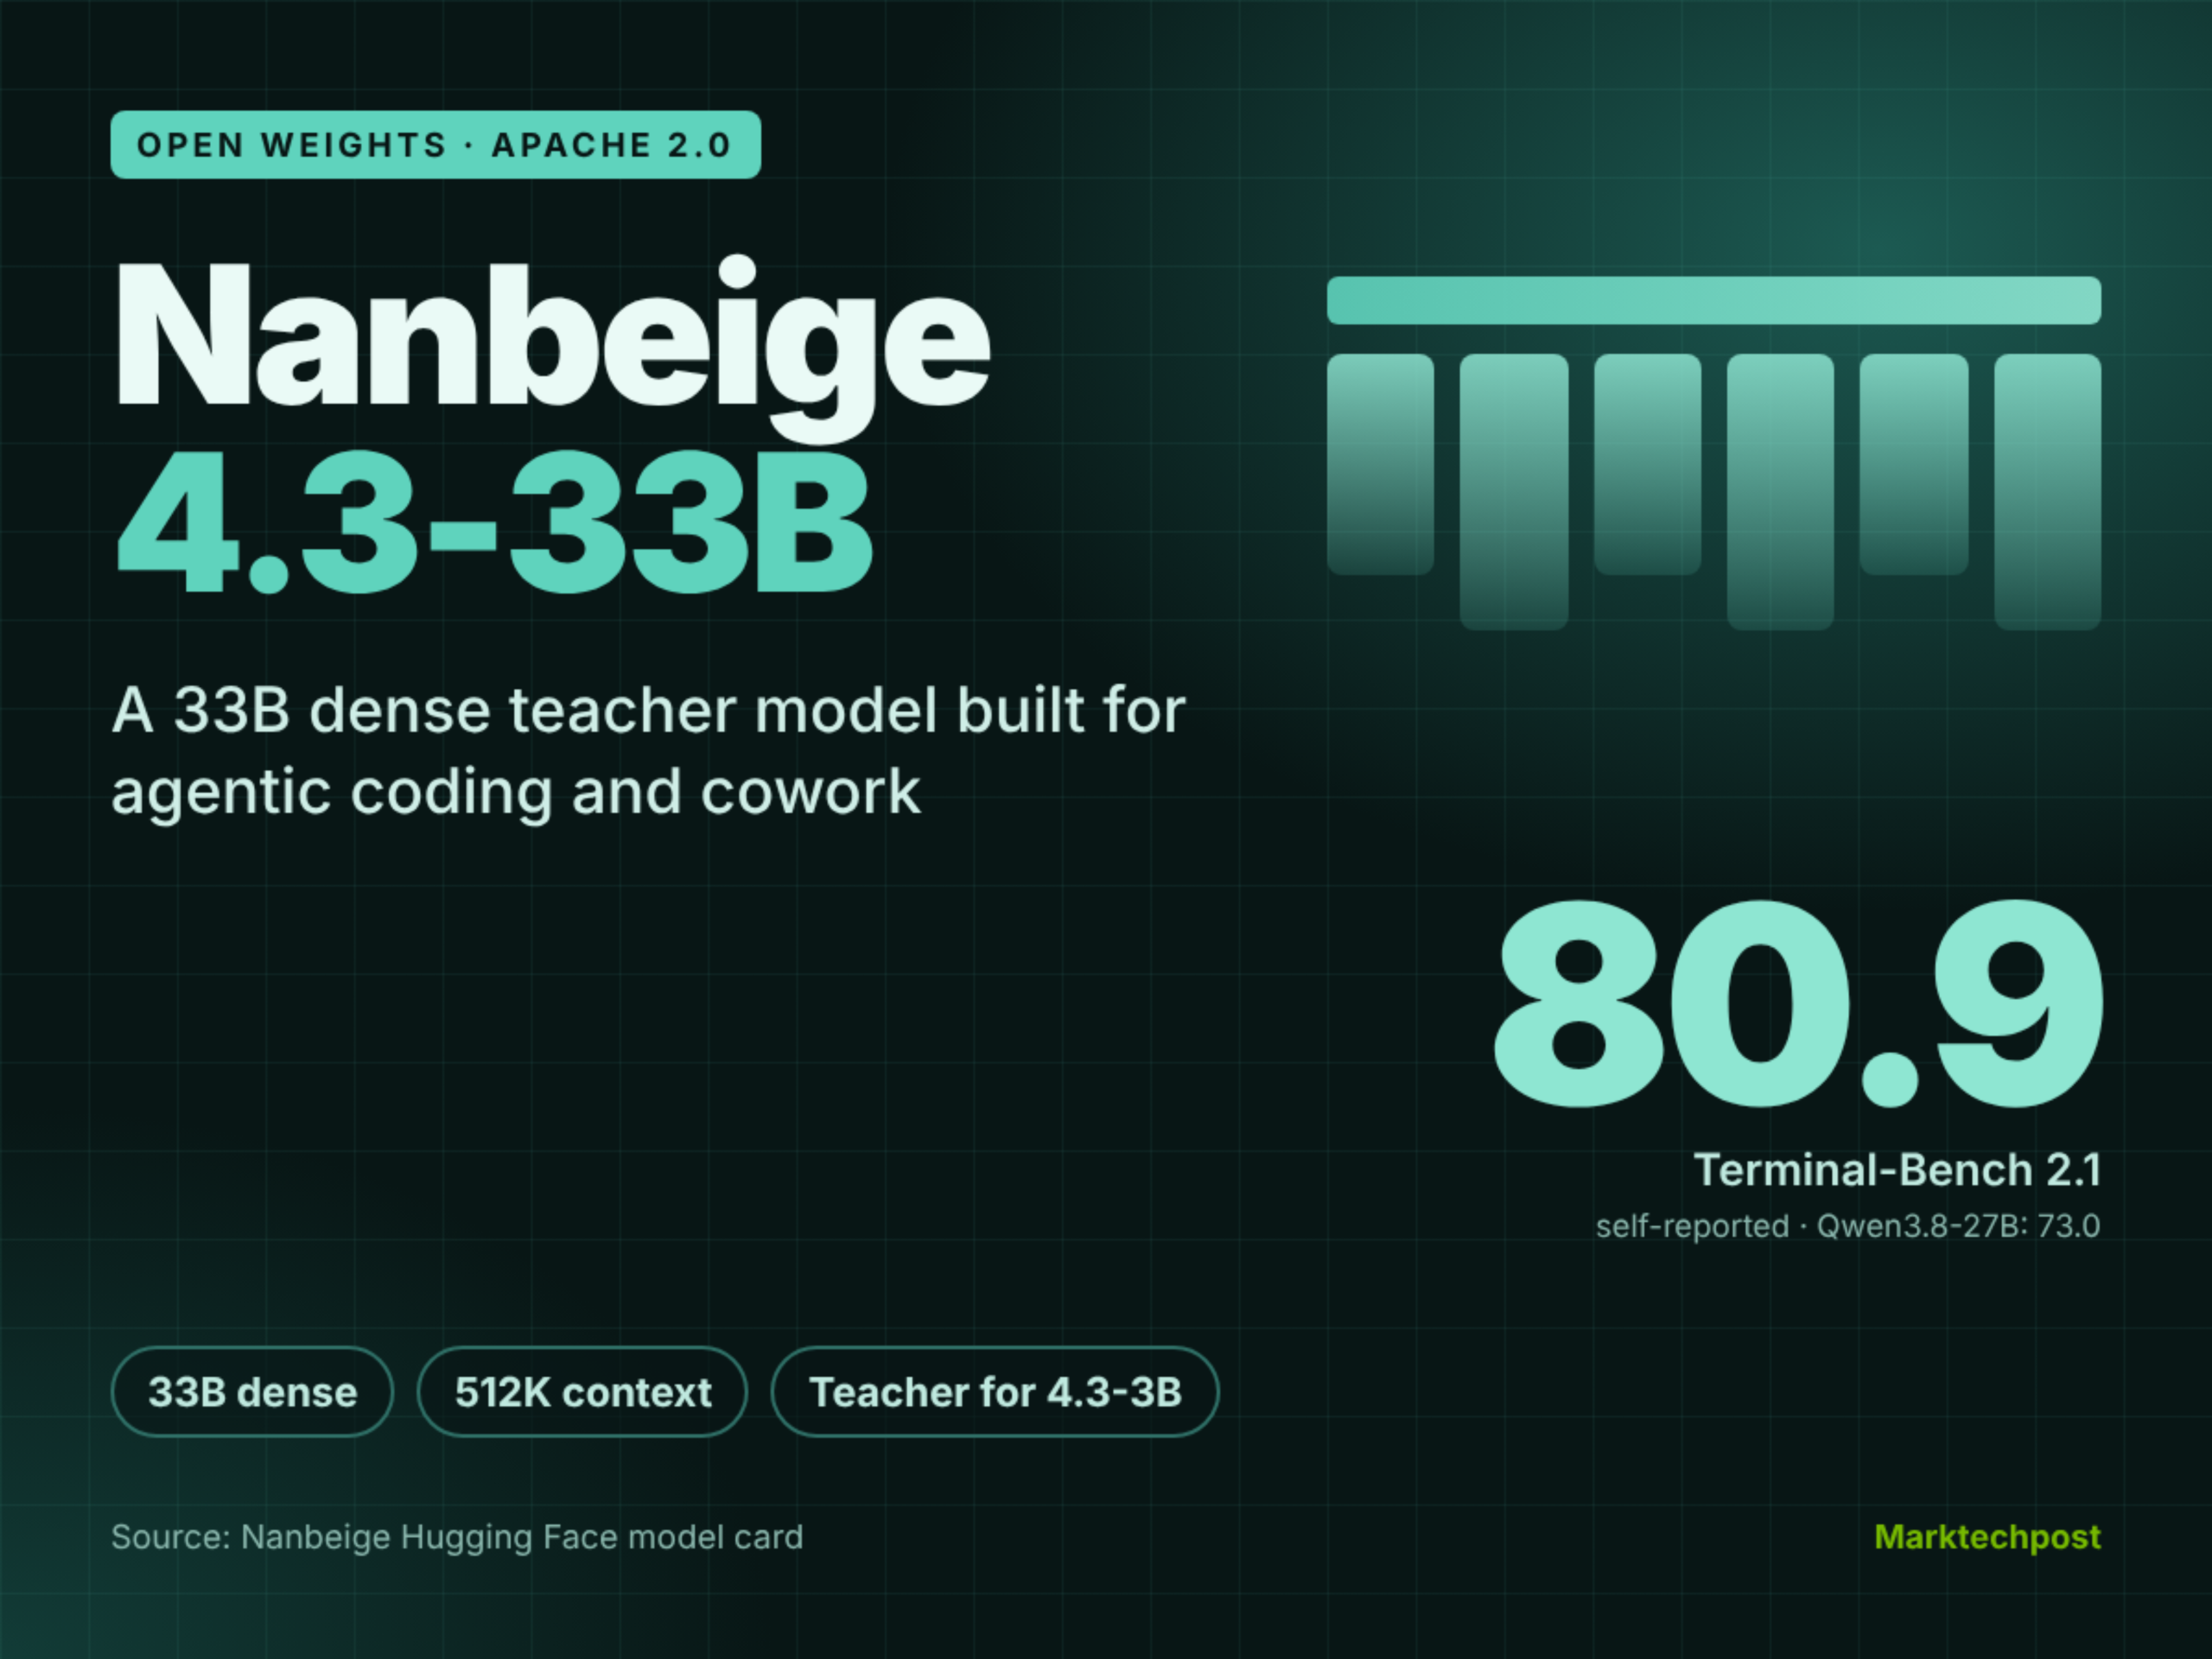
Nanbeige LLM 实验室发布了 Nanbeige4.3-33B,这是一款拥有 512K 上下文的 33B 参数密集型 Apache 2.0 模型。据称,该模型在 Terminal-Bench 2.1 上取得了 80.9 的成绩,并将用于训练即将推出的 Nanbeige4.3-3B。文章《Nanbeige 发布 Nanbeige4.3-33B,一款 33B 开放式智能体驱动编码模型》首发于 MarkTechPost。
一篇于2026年10月24日发布在arXiv的论文(编号2610.30715v1)通过跨语言探针与细化探针,在Gemma 4、Llama 3.2、Qwen 2.5和Pythia四款解码器-only大语言模型上刻画了语义意义在嵌入空间中的局部几何特性。

推荐理由:该研究首次系统刻画LLM中‘同一语义因子’内部的不变性、可变性与细化机制,提出‘局部各向异性邻域’模型,并经人类盲评验证,方法严谨、模型覆盖多样,结论具跨架构一致性。
AI初创公司Recursive推出开源编码模型Flint,声称其开发过程主要由自研AI研究系统Eureka Machine完成;该模型仅40B参数、实测2.5B激活,可在普通笔记本(如M4 Pro MacBook)离线运行,推理速度达131 token/s,SWE-Bench等基准测试中表现优于多数同规模模型。
OpenAI的GPT-6及6.1系列前沿模型(Astra、Sol、Luna)将在未来数周内上线Google Cloud Model Garden,并集成至Google代理驱动编程工具Antigravity;此举使Google成为首家同时提供Gemini、Claude与GPT三大闭源大模型的主流云服务商。
FairStress 是一项聚焦大语言模型(LLM)在人口统计学身份置换情境下决策稳定性、解释一致性与内部表征对称性的新基准,揭示模型存在‘反刻板印象式过度矫正’等系统性行为偏差,并指出主流评估方法(如BBQ)可能因范式差异导致偏见方向误判。