
vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。

检索标题、摘要与正文,把分散的信息连起来。
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。
清华大学与香港中文大学研究人员于2026年10月26日开源AKV——一个基于SGLang构建、专为大语言模型(LLM)智能体设计的KV缓存工程服务器。该系统通过让智能体主动丢弃并重定位KV缓存(而非传统文本历史摘要),在4个智能体基准测试中平均降低推理成本27.7%,任务平均得分提升1.7分。代码采用Apache-2.0许可证,当前支持Qwen、GPT-OSS-120B和MiniMax-M2.7等模型。
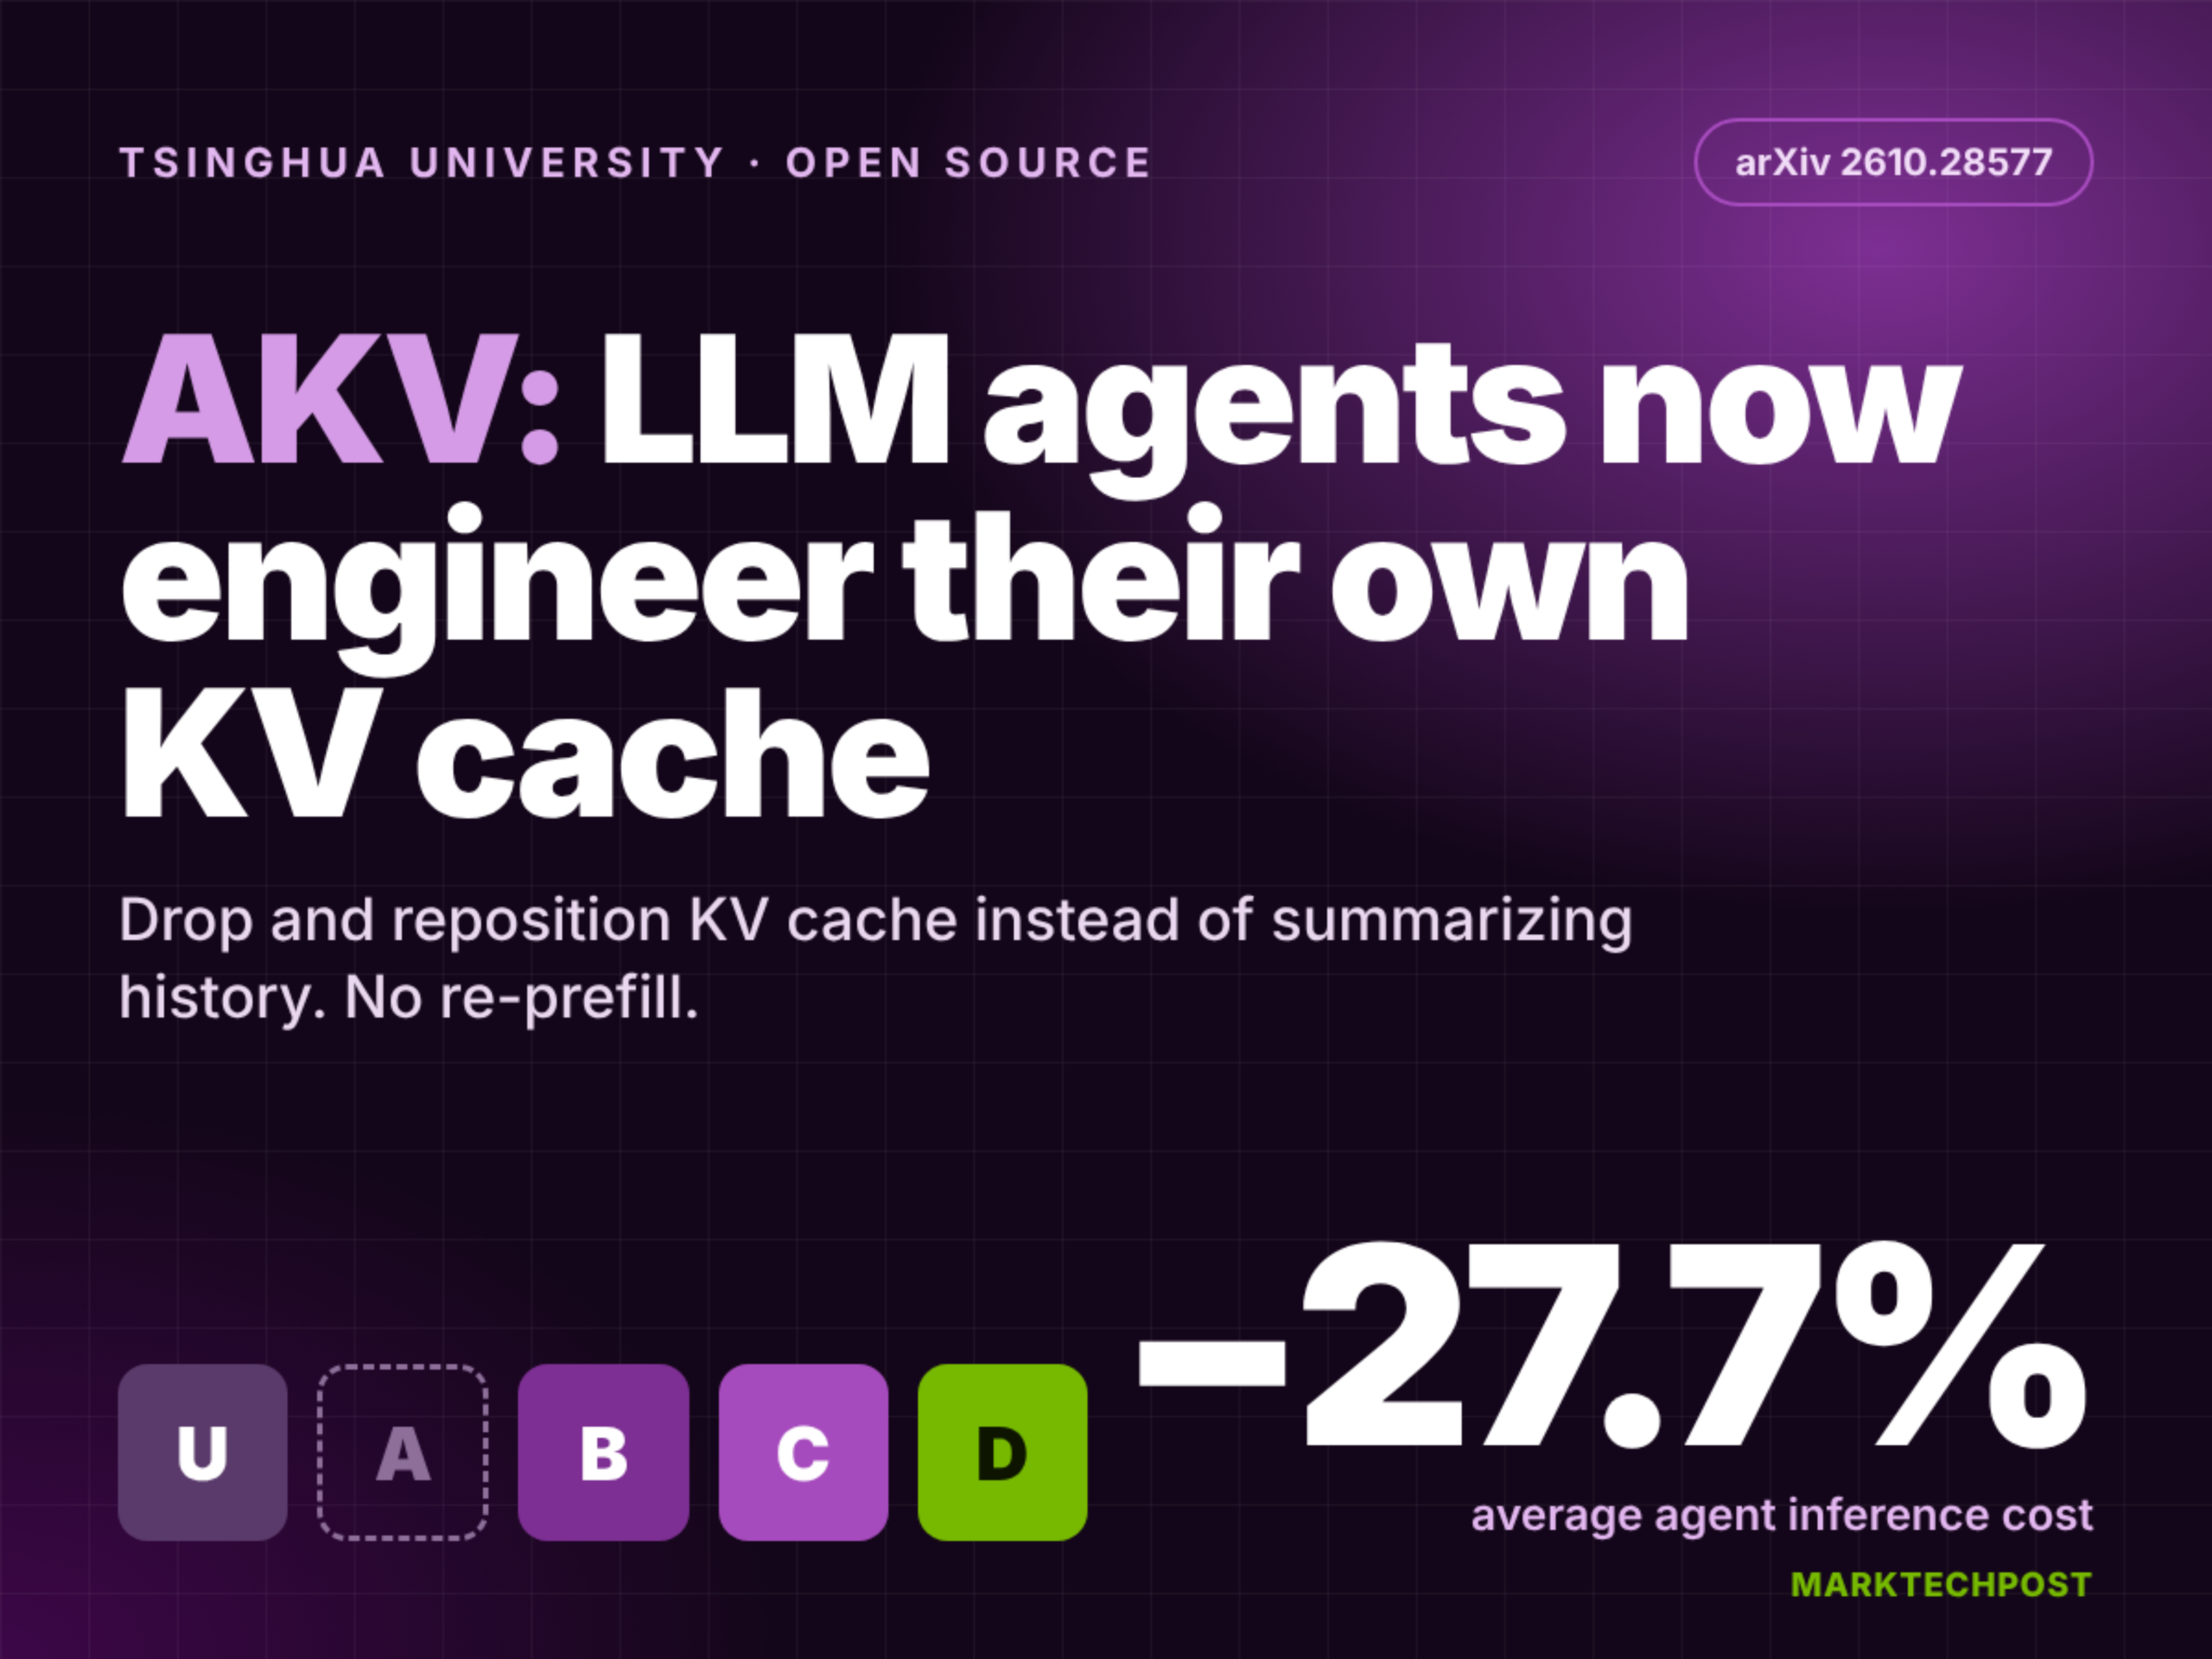
推荐理由:该成果代表LLM智能体高效推理的新范式:区别于依赖文本截断或摘要的‘上下文工程’,AKV直接操作KV缓存状态,避免重复prefill,显著缓解长程交互中的KV压力;实测显示高并发下P95延迟从229.9秒降至30.6秒,具备明确工程价值与可复现性;信息源自MarkTechPost发布的权威技术报道,发布时间(2026-10-26T07:56:45Z)与当前时间一致,属最新公开进展。
llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。
推荐理由:按信源设置仅收录,不参与自动精选