
从芯片到技能,英伟达与韩国拓展主权AI合作
英伟达与韩国科学技术信息通信部(MSIT)正在扩大双方在全国主权人工智能生态系统中的合作,涵盖从AI半导体和数据中心基础设施到人才、初创企业、模型、智能体及安全等各个领域。此次合作为韩国NPU和XPU企业探索参与英伟达NVLink Fusion生态系统奠定了基础,并包括[…]
检索标题、摘要与正文,把分散的信息连起来。
英伟达与韩国科学技术信息通信部(MSIT)正在扩大双方在全国主权人工智能生态系统中的合作,涵盖从AI半导体和数据中心基础设施到人才、初创企业、模型、智能体及安全等各个领域。此次合作为韩国NPU和XPU企业探索参与英伟达NVLink Fusion生态系统奠定了基础,并包括[…]
中国AI公司正在尝试走出一条与硅谷不同的道路。MiniMax创始人、董事长兼CEO闫俊杰(IO)在首次英文播客访谈中表示,公司将坚持开源,直到实现通用人工智能(AGI);而实现盈利的关键,不是提高模型价格,而是通过技术创新持续压低推理成本。在他看来,美国AI生态依靠巨额资本和算力资源推动模型能力突破,中国公司则必须在...
Anthropic CEO达里奥·阿莫迪。图片经由AI处理文丨苏扬编辑丨徐青阳 AI公司正在变成大型基础设施买家。Anthropic的扩张路径,已经从训练模型、争夺企业客户,延伸到建设数据中心、采购芯片和协调电力资源。为了获得足够的计算能力,这家公司开始直接介入过去主要由云服务商和基础设施运营商承担的工作。美国当地时间11月2日,Anthropic向美国证券交易委员会提交更新后的招股书。文件补充了2026年第三季度相关财务数据,并披露长期采购和租赁安排。文件显示,算力成为Anthropic扩张过程中最重要的成本项。为了满足Claude模型训练和企业客户调用需求,该公司不仅与亚马逊、谷歌、微软等...

arXiv:2610.37906v1 发布类型:新 摘要:脉冲储备计算将固定递归储备池的训练效率与事件驱动推理的能量效率相结合,其中计算由稀疏脉冲触发,而非在每个时间步都进行密集运算。然而,现有的脉冲储备池几乎完全依赖于漏积分-发放(LIF)神经元,其低通特性限制了它们区分不同时间频率所编码信息的能力。我们提出了HRF-Res,一种液态状态机,其中LIF神经元被异质的谐波谐振-发放(HRF)神经元群体所取代。这些神经元具有内在的振荡动力学,并能选择性地响应输入频率,从而使储备池能够捕捉频
通过开源工具和开源 PDK,从工作负载规范到 GDS 版图布局,对 AI 智能体进行评估,以衡量其完成芯片设计工作流的能力。文章《隆重推出 Build-A-Chip-Bench:从工作负载规范到 GDS》首发于 Semiconductor Engineering。
Simplismart表示,其年化收入增速在六个月内增长了14倍,其中美国市场贡献了超过一半的收入。
对带宽的空前需求促使人们通过从根本上重新构想光互连路线图,将光学技术更紧密地集成到硅基芯片上。文章《imec报告:面向人工智能时代的光互连技术 scaling》首发于 Semiconductor Engineering。
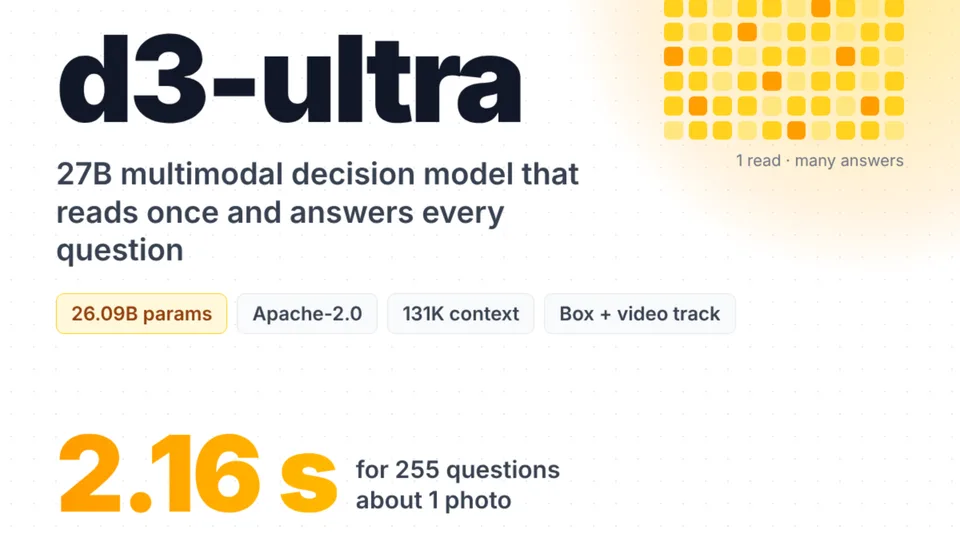
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。
在准备上市之际,Anthropic提交的S-1文件使生成式AI对甲烷的依赖暴露无遗。“在获取电力供应以及具备充足电力保障的数据中心选址方面,竞争十分激烈。”在周一提交给美国证券交易委员会的文件中,Anthropic承认,数据中心正日益依赖“天然气”[…]

麻省理工学院社区的各界代表齐聚一堂,就数据中心、超级污染物、农业与教育等议题展开了讨论。
今天,我们来了解一下华擎面向工作站推出的高端Radeon AI推理卡——Creator Radeon AI Pro R9700。这款显卡配备32GB内存,售价1700美元,是为工作站添置本地AI推理能力的高性价比之选。文章《华擎Creator Radeon AI Pro R9700评测:AMD风格的工作站推理》首发于ServeTheHome。
AI工厂是迄今为止技术最为复杂的运营环境之一。数十万块GPU、NVIDIA Spectrum-X以太网……
在数千块GPU上训练大规模AI模型是一项高风险的运维工作,必须内置监控与自动化机制,以优化集群的韧性……
我们在2026年OCP峰会上深入了解了Aivres NVIDIA Vera、Vera Rubin以及Blackwell Ultra系列平台。文章《Aivres NVIDIA Vera Rubin与HGX B300亮相OCP峰会》首发于ServeTheHome。
AWS 宣布 SageMaker AI 无服务器模型定制功能新增「训练会话(Training Sessions)」,即日起全面可用。用户可自主编写后训练逻辑(如自定义损失函数、奖励信号、多轮强化学习),而 GPU 分配、分布式执行、容错恢复与检查点存储均由平台自动处理。
Amazon SageMaker发布训练会话(Training Sessions)API,支持用户以纯Python脚本实现SFT、RLHF、GRPO、KTO等自定义大模型训练逻辑,GPU资源调度、容错、分布式执行及检查点管理均由服务托管。
本文为Hugging Face与Amazon联合发布的技术博客系列首篇,系统介绍如何在AWS Trainium AI加速芯片上使用TorchNeuron进行PyTorch模型推理性能分析,涵盖Neuron后端集成原理、torch.profiler配置方法、NeuronConfig与NeuronProfiler工具使用、Neuron Explorer可视化追踪,并以RMSNorm为例对比三种实现(朴素PyTorch、torch.rms_norm内置融合、torch.compile自动融合)的设备耗时差异。
i14推出30.28亿参数的Laplace 3B模型,采用门控线性注意力(GLA)替代Softmax注意力,其推理时每序列递归状态恒为29.5 MB,与上下文长度无关;该模型在单台AWS trn2.48xlarge(16颗Trainium2芯片)上完成训练与服务验证,训练吞吐达12万token/秒,服务吞吐11544 output token/秒(1280并发序列),所有性能数据均为i14与AWS GenAIIC团队内部实测结果。
Hugging Face联合AWS推出TorchNeuron——PyTorch原生Trainium后端,自2026年10月20日起开放公测。该技术使Transformers、Diffusers等主流库无需修改即可直接运行于Trainium芯片,显著提升文本生成与图像生成模型的易用性与兼容性。