
从芯片到技能,英伟达与韩国拓展主权AI合作
英伟达与韩国科学技术信息通信部(MSIT)正在扩大双方在全国主权人工智能生态系统中的合作,涵盖从AI半导体和数据中心基础设施到人才、初创企业、模型、智能体及安全等各个领域。此次合作为韩国NPU和XPU企业探索参与英伟达NVLink Fusion生态系统奠定了基础,并包括[…]
检索标题、摘要与正文,把分散的信息连起来。
英伟达与韩国科学技术信息通信部(MSIT)正在扩大双方在全国主权人工智能生态系统中的合作,涵盖从AI半导体和数据中心基础设施到人才、初创企业、模型、智能体及安全等各个领域。此次合作为韩国NPU和XPU企业探索参与英伟达NVLink Fusion生态系统奠定了基础,并包括[…]
曝特努斯要求加快 AI 研发,推动 Siri 主动处理任务 苹果称超 10 万款应用已适配 iPhone Duo 英伟达 1140 万美元货物被盗 Anthrop....

对带宽的空前需求促使人们通过从根本上重新构想光互连路线图,将光学技术更紧密地集成到硅基芯片上。文章《imec报告:面向人工智能时代的光互连技术 scaling》首发于 Semiconductor Engineering。
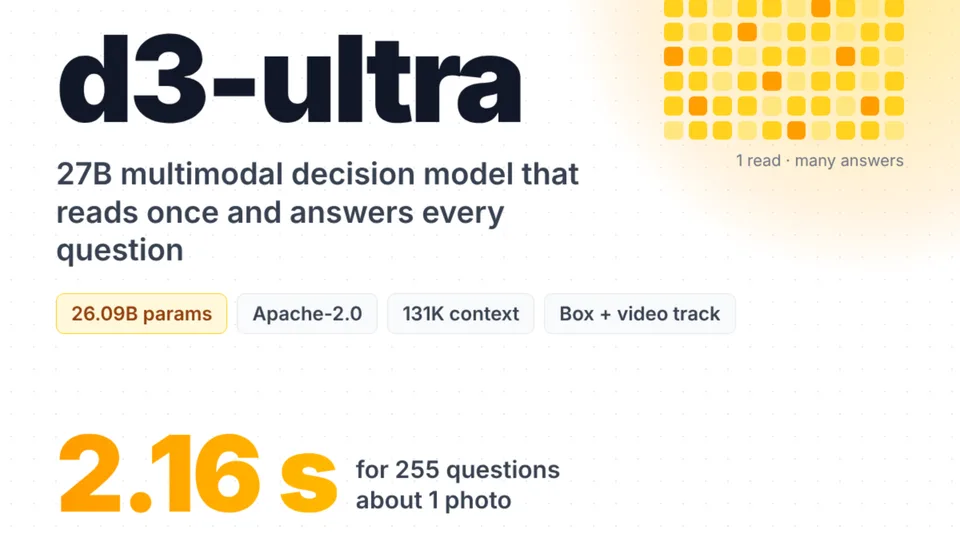
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。
arXiv:2610.33501v1 发布类型:新 提要:大型语言模型(LLM)的推理服务依赖于批处理以提升推理吞吐量,但键值(KV)缓存会随序列长度增长,从而限制了GPU上的并发度。通过CPU卸载,可以利用主机内存扩展KV缓存容量,然而现有系统在很大程度上仍受GPU瓶颈制约:只有当GPU调度器能够提供合适的重叠机会时,CPU驻留的请求才能取得进展。因此,主机内存与CPU计算无法作为独立的推理资源发挥作用,导致负载下CPU端进度波动加剧,并使尾部词间延迟(ITL)显著增加。我们提出了DualPace,一种将主机转变为独立调度解码引擎的LLM推理运行时。DualPace在两个引擎之间划分了调度权:GPU引擎
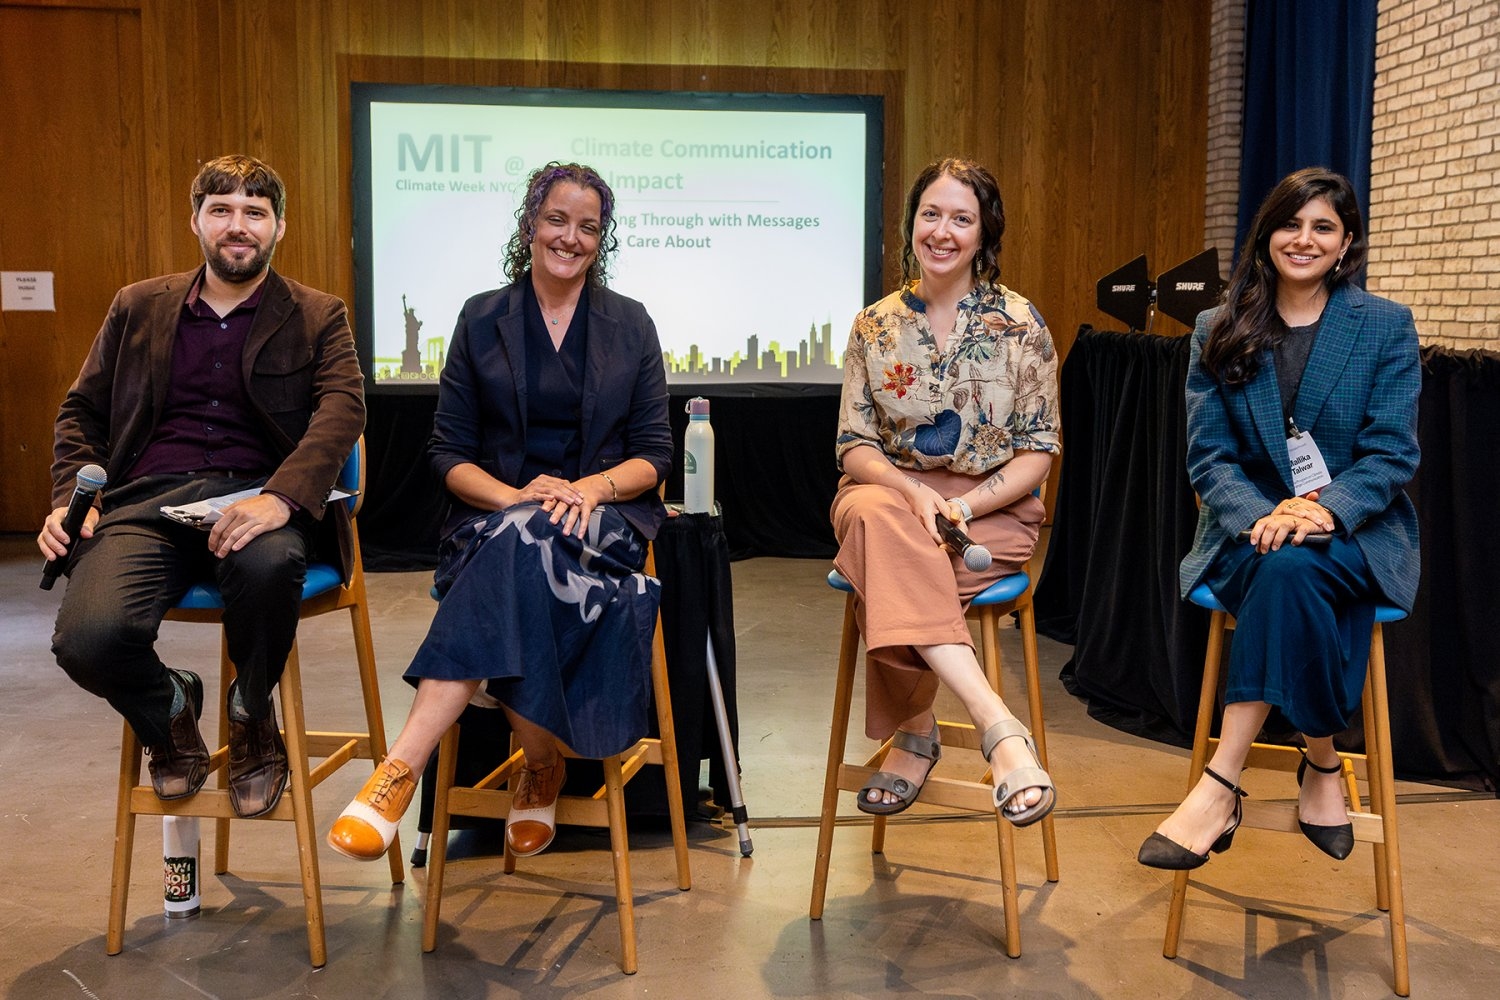
麻省理工学院社区的各界代表齐聚一堂,就数据中心、超级污染物、农业与教育等议题展开了讨论。
八年前,芯片制造商美满电子科技公司决定在纳米制程领域实现跨越式发展,此后其发展轨迹一路稳步向上。在半导体制造领域,纳米制程代号所指的并非晶体管的确切物理尺寸,而是各代芯片制造技术,即所谓的工艺节点。先进的工艺节点通常能够提升晶体管密度,并带来性能上的改进……文章《美满电子在人工智能需求推动下,早期的芯片制造豪赌终获回报》首发于SiliconANGLE。
苹果终结二十年触控抵制,首款触屏OLED MacBook Pro定档发布,成为特努斯接任CEO后首个硬件答卷;Meta自由现金流转为-21亿美元,7600亿美元行业资本支出迎盈亏平衡审判;谷歌以1070兆瓦虚拟电厂重构数据中心供能,特斯拉自研AI地图弃用谷歌;Anthropic被指静默削弱Claude Opus 5.5逆向能力;亚马逊、Meta、OpenAI以50美元级AI硬件切入可穿戴赛道。
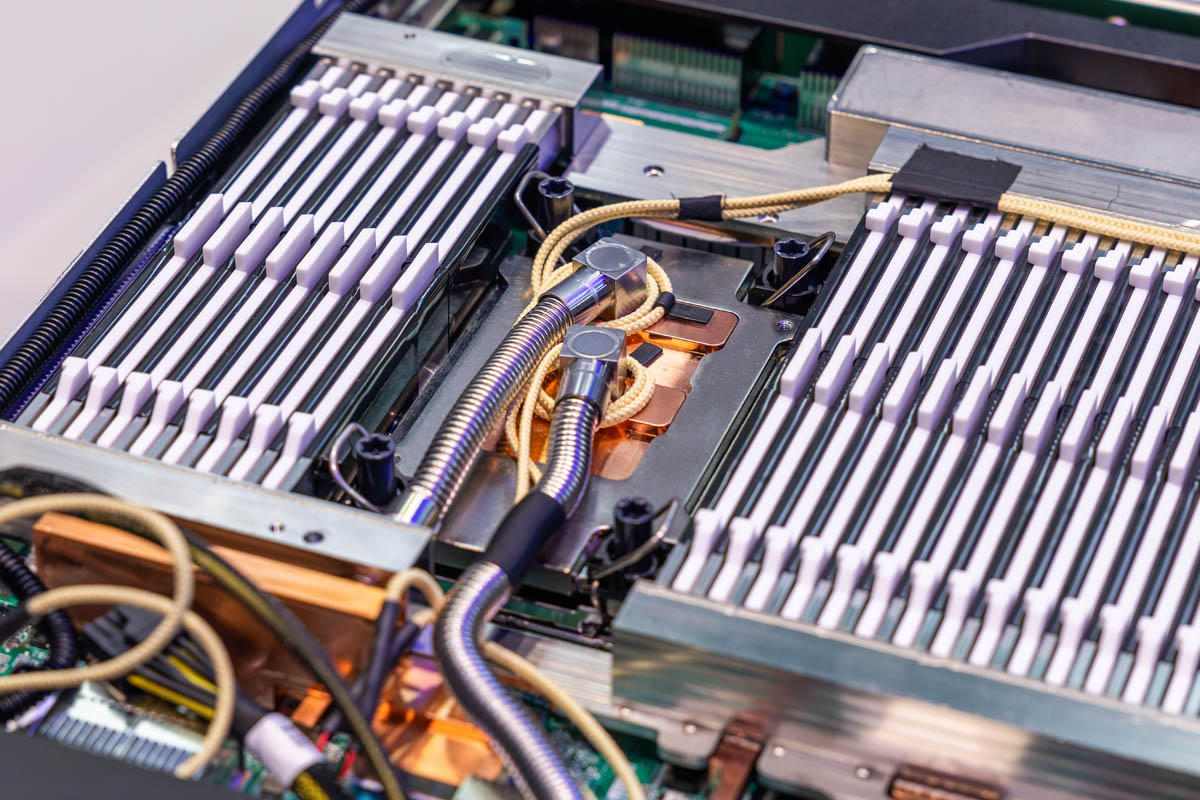
我们在2026年OCP峰会上深入了解了Aivres NVIDIA Vera、Vera Rubin以及Blackwell Ultra系列平台。文章《Aivres NVIDIA Vera Rubin与HGX B300亮相OCP峰会》首发于ServeTheHome。
这段影像看起来还不错,只要你不追求艺术性、灵感或人文关怀。

欧洲零售商正依托NVIDIA加速的开放大模型与物理AI技术,在数字商品发现、智能仓储仿真、虚拟试穿及研发加速等场景实现规模化落地。Shopify、Zooplus、L’Oréal、Otto Group等企业通过Nemotron系列模型、Omniverse数字孪生、ALCHEMI分子模拟等工具,显著降低推理成本、提升搜索准确率、缩短研发周期,并验证了转化率与销售增长效果。