
敢和英伟达现场PK的国产GPU,我是服的
金磊 发自 上海 量子位 | 公众号 QbitAI 我愿称之为,国产芯片界的真勇士。 事情是这样的。 一家国产芯片公司,竟敢把自家的GPU和英伟达H200,直....
检索标题、摘要与正文,把分散的信息连起来。
金磊 发自 上海 量子位 | 公众号 QbitAI 我愿称之为,国产芯片界的真勇士。 事情是这样的。 一家国产芯片公司,竟敢把自家的GPU和英伟达H200,直....
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。

arXiv:2610.34907v1 发布类型:新 摘要:在NVIDIA Hopper架构中推出的张量内存加速器(TMA),已在生产环境中的GPU内核中得到广泛应用,但其使用却表现出明显的选择性:CUTLASS、FlashAttention-3和FlashInfer等领域的资深内核开发者仅对内核中的部分张量操作数采用TMA,而对其余操作数则退回到cp.async、直接全局加载或分布式共享内存(DSM)等方式。厂商文档虽已说明了该API,近期的微基准测试也单独刻画了TMA的吞吐性能,但这些研究均未能解答从业者实际面临的疑问:在内核中遇到某个内存操作数时,究竟是否应使用TMA?若使用,又该搭配还是不搭配集群多播?我们通过一项基于工作负载的实证研究,在H100平台上填补了这一空白。我们系统地梳理了TMA、多
麻省理工学院社区的各界代表齐聚一堂,就数据中心、超级污染物、农业与教育等议题展开了讨论。
清华大学与香港中文大学研究人员于2026年10月26日开源AKV——一个基于SGLang构建、专为大语言模型(LLM)智能体设计的KV缓存工程服务器。该系统通过让智能体主动丢弃并重定位KV缓存(而非传统文本历史摘要),在4个智能体基准测试中平均降低推理成本27.7%,任务平均得分提升1.7分。代码采用Apache-2.0许可证,当前支持Qwen、GPT-OSS-120B和MiniMax-M2.7等模型。
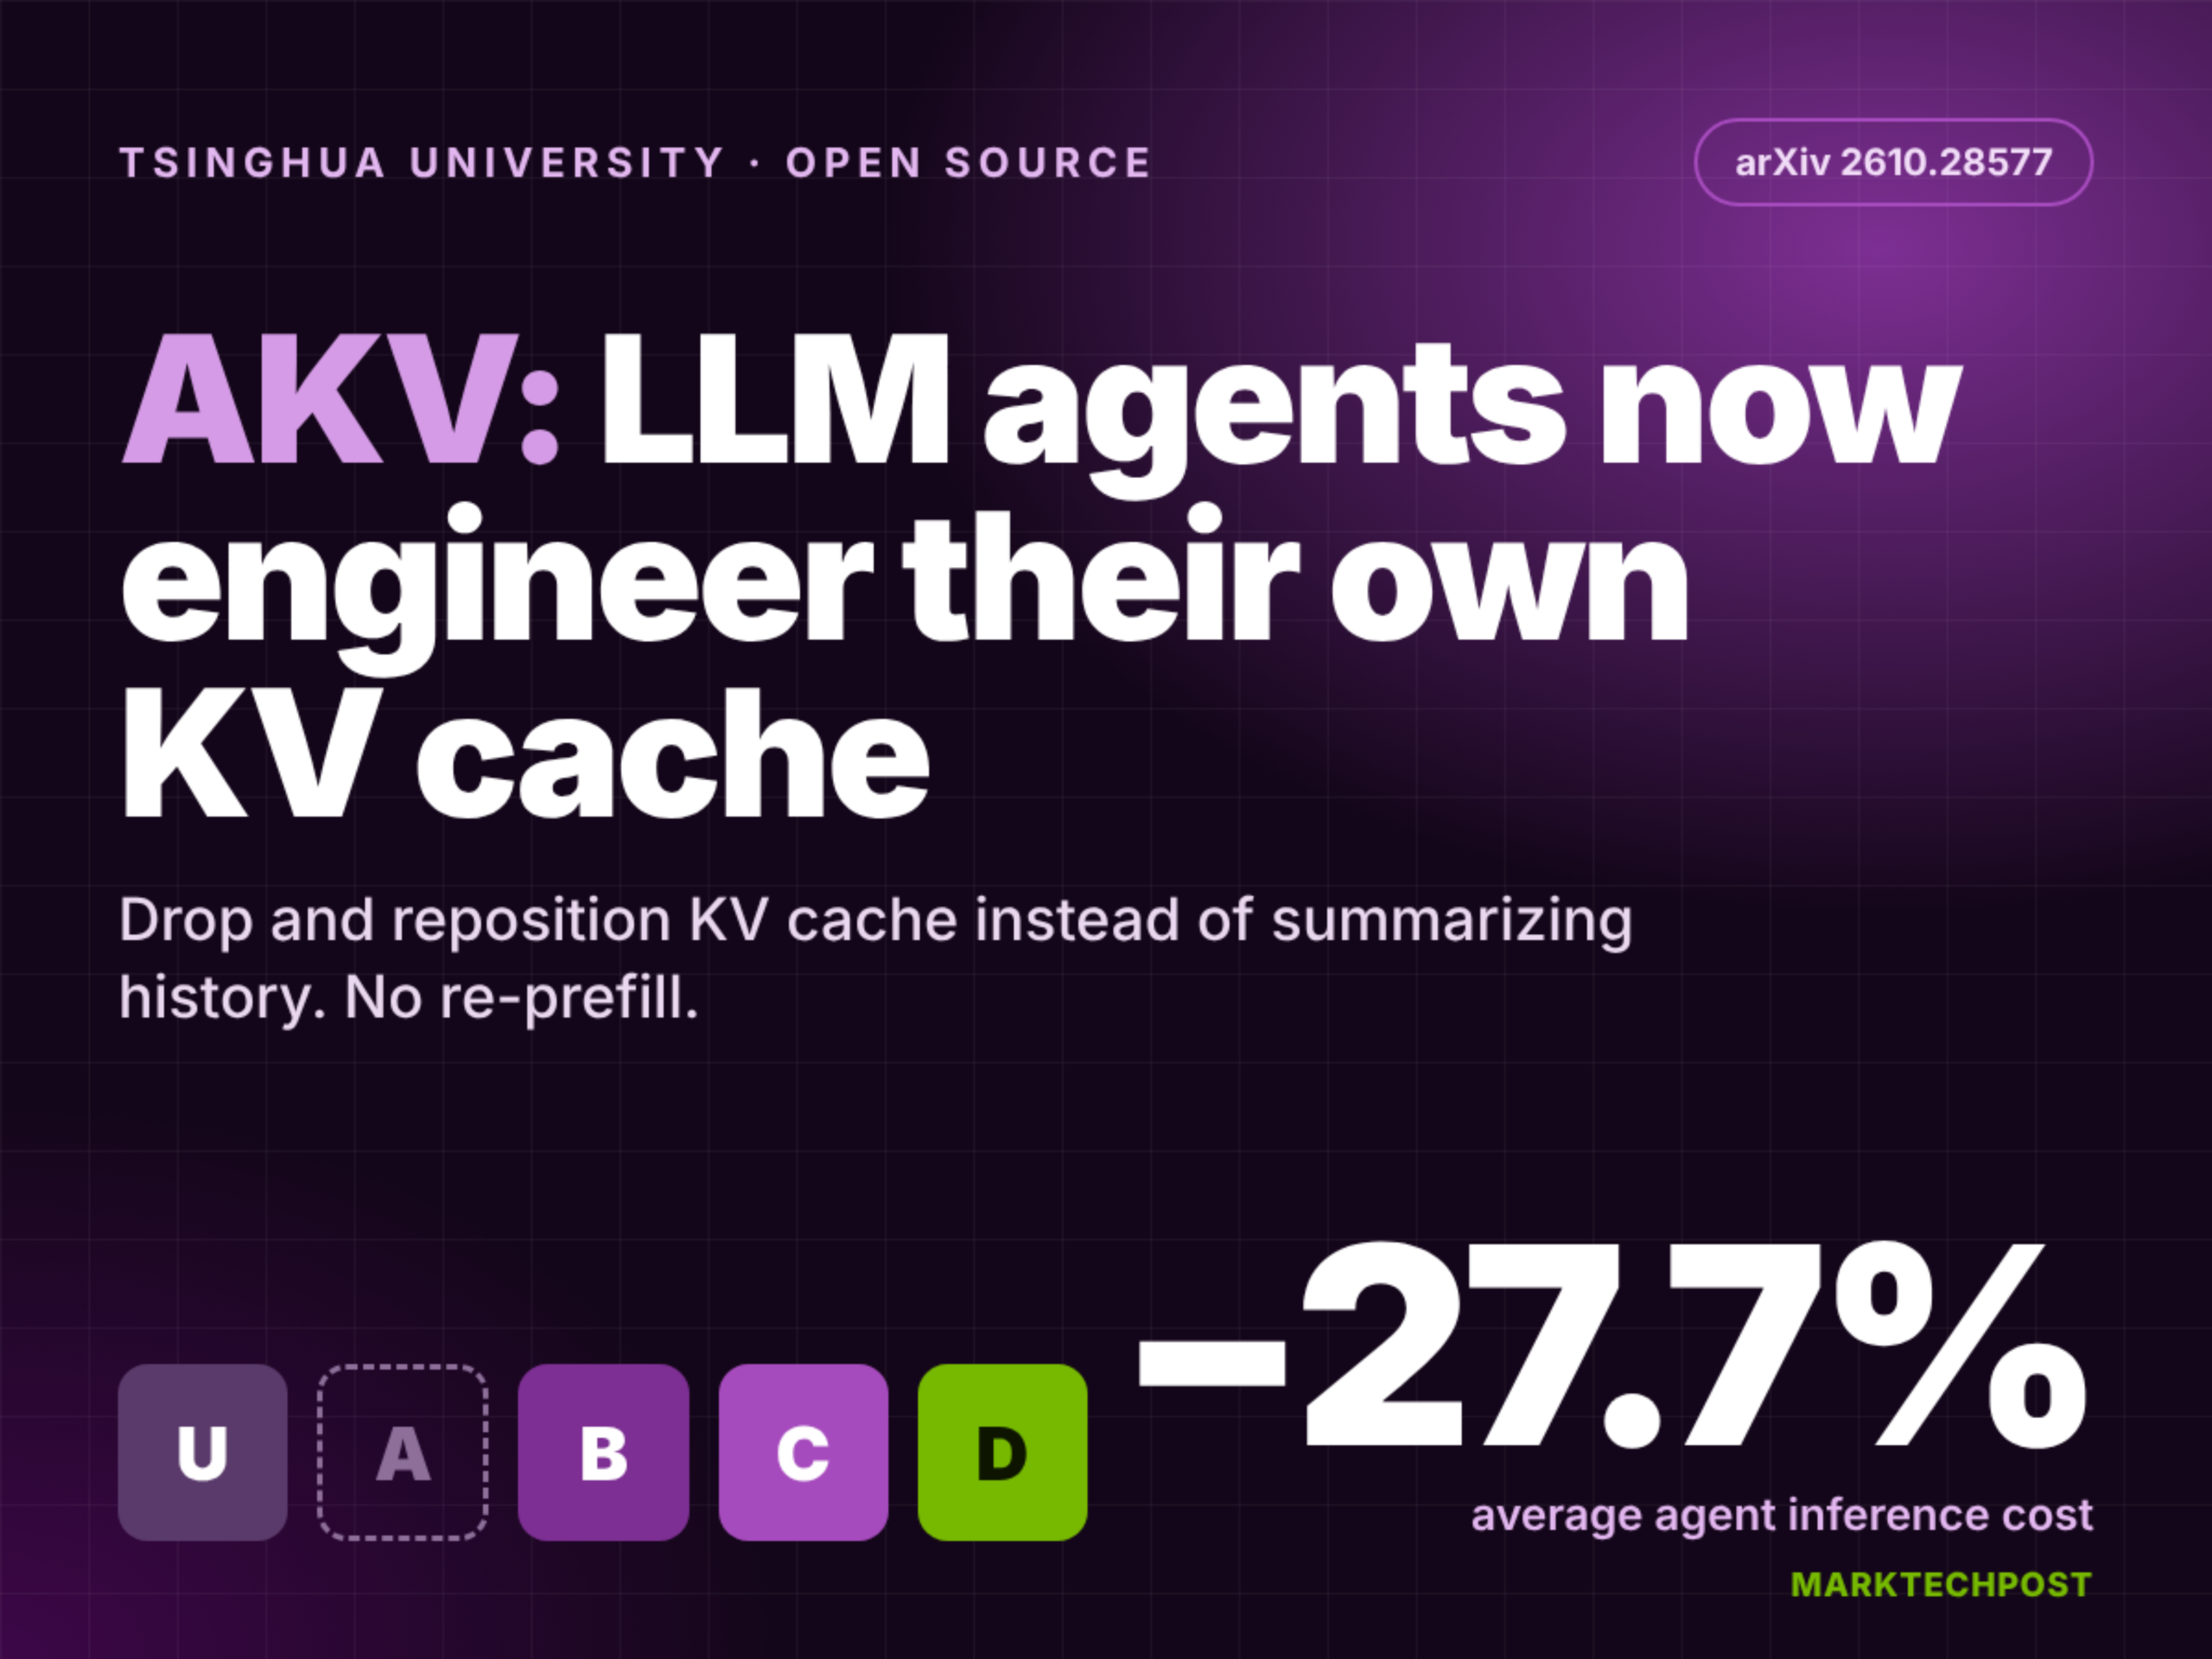
推荐理由:该成果代表LLM智能体高效推理的新范式:区别于依赖文本截断或摘要的‘上下文工程’,AKV直接操作KV缓存状态,避免重复prefill,显著缓解长程交互中的KV压力;实测显示高并发下P95延迟从229.9秒降至30.6秒,具备明确工程价值与可复现性;信息源自MarkTechPost发布的权威技术报道,发布时间(2026-10-26T07:56:45Z)与当前时间一致,属最新公开进展。
这段影像看起来还不错,只要你不追求艺术性、灵感或人文关怀。

llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。
推荐理由:按信源设置仅收录,不参与自动精选
i14推出30.28亿参数的Laplace 3B模型,采用门控线性注意力(GLA)替代Softmax注意力,其推理时每序列递归状态恒为29.5 MB,与上下文长度无关;该模型在单台AWS trn2.48xlarge(16颗Trainium2芯片)上完成训练与服务验证,训练吞吐达12万token/秒,服务吞吐11544 output token/秒(1280并发序列),所有性能数据均为i14与AWS GenAIIC团队内部实测结果。