
NVIDIA RTX Spark 为游戏中的神经渲染与人工智能角色提供动力
NVIDIA RTX Spark 是一款面向 AI 开发、创作与游戏的全新 Windows PC 平台,适用于轻薄型笔记本电脑和紧凑型台式机。该平台由 NVIDIA Blackwell RTX 提供算力支持……
检索标题、摘要与正文,把分散的信息连起来。
NVIDIA RTX Spark 是一款面向 AI 开发、创作与游戏的全新 Windows PC 平台,适用于轻薄型笔记本电脑和紧凑型台式机。该平台由 NVIDIA Blackwell RTX 提供算力支持……
Simplismart表示,其年化收入增速在六个月内增长了14倍,其中美国市场贡献了超过一半的收入。
10月27日,乐奇Rokid推出AI眼镜Rokid Glasses 2、全彩AI眼镜Rokid Color和交互戒指Rokid Ring
指数落地+ETF授权,港股AI与半导体迎来新的配置工具与资金入口.
2026年长沙·1024程序员日活动期间,CEIC消费电子创新大会与CSDN在深圳联手打造了一场属于开发者的硬核技术盛宴。正如CEIC组委会常务副主任杨涛在接受采访时所言:“消费电子领域所有的体验创新,归根到底都是由于我们的程序员代码敲出来的。”在当前的技术拐点下,从单纯的手写代码,到利用智能体(Agent)和丰富的端侧AP...
据《The Verge》2026年10月27日报道,美国各地社区因数据中心大规模建设及其配套基建成本激增而爆发广泛反对,该议题已深度介入多场国会及州长竞选。科技资本加速入场,由马克·安德森与格雷格·布罗克曼支持的超级政治行动委员会“Leading the Future”一年内已投入4500万美元;Anthropic支持的“Public First Action”亦参与其中。
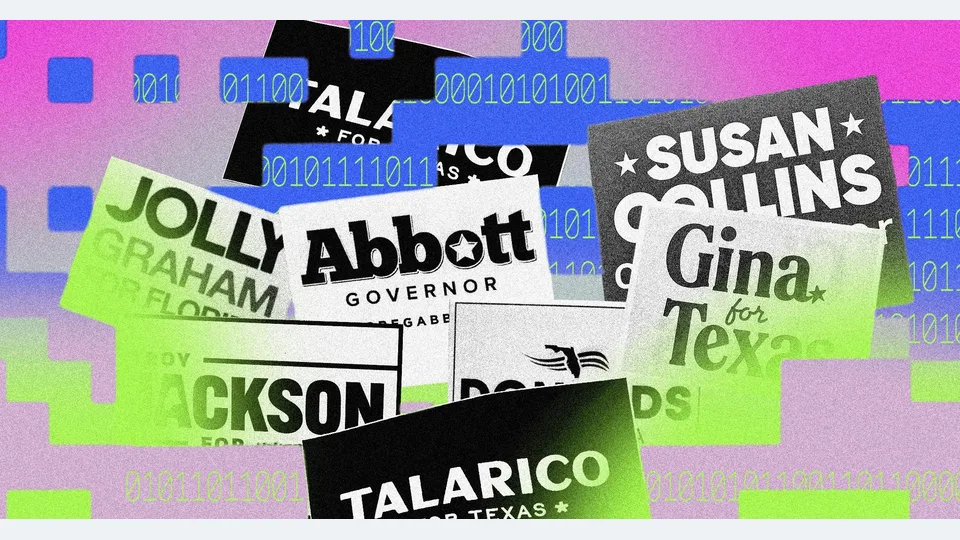
推荐理由:材料来源明确(The Verge)、发布时间与当前系统时间一致(2026-10-27),内容聚焦可验证的公共政策与选举动态,包含具体主体、金额、时间节点及组织关系,符合时效性与事实锚定要求。
对带宽的空前需求促使人们通过从根本上重新构想光互连路线图,将光学技术更紧密地集成到硅基芯片上。文章《imec报告:面向人工智能时代的光互连技术 scaling》首发于 Semiconductor Engineering。
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。

arXiv:2610.34907v1 发布类型:新 摘要:在NVIDIA Hopper架构中推出的张量内存加速器(TMA),已在生产环境中的GPU内核中得到广泛应用,但其使用却表现出明显的选择性:CUTLASS、FlashAttention-3和FlashInfer等领域的资深内核开发者,仅对内核中的部分张量操作数采用TMA,而对其余操作数则退回到cp.async、直接全局加载或分布式共享内存(DSM)等方式。厂商文档虽已阐述了该API,近期的微基准测试也单独刻画了TMA的吞吐性能,但这些研究均未能解答从业者实际面临的疑问:在内核中遇到某个内存操作数时,究竟是否应使用TMA?若使用,又该搭配还是不搭配集群多播?我们通过一项基于工作负载的实证研究,在H100平台上填补了这一空白。我们系统地梳理了TMA、多
arXiv:2610.33275v1 发布类型:新 摘要:计算型笔记本会在整个会话期间独占一块GPU,然而GPU仅在单元格执行时进行计算,其余时间则处于空闲状态。无服务器执行模式可以在各单元格之间释放GPU资源,但在新的工作节点上重建累积的笔记本状态会对每个GPU单元格带来显著的开销。本文提出了一种面向交互式笔记本的无服务器GPU平台——LooseLeaf。LooseLeaf能够推导出每个单元格的状态及其导入闭包,即该单元格所需的最小变量与软件包集合。我们在5,000个真实世界笔记本上的分析表明,这些闭包规模很小,且用户对单元格的编辑操作只需数秒即可完成准备。LooseLeaf会在用户编辑单元格的同时,基于这些闭包为GPU工作节点做好准备。执行结束后,该工作节点…

arXiv:2610.33475v1 发布类型:新 摘要:基础大型语言模型(LLM)在云数据中心的广泛部署,标志着从无状态深度学习向分布式、内存密集型生成式工作负载的根本性范式转变。然而,在严格的服务水平目标(SLO)下为大规模基础模型提供服务,会暴露出关键的物理与系统瓶颈。这些挑战包括持续存在的高带宽内存(HBM)墙、计算密集型预填充与内存带宽受限的解码之间的运行不对称、键值(KV)缓存的爆炸式增长、代价高昂的无服务器冷启动,以及硬件可靠性方面的漏洞。现有的文献综述仍局限于各层次的孤立视角,未能将底层加速器的虚拟化与集群……
arXiv:2610.34911v1 发布类型:新 摘要:高性能计算的范畴已扩展至涵盖多种形态的机器学习任务。图神经网络(GNN)日益受到青睐,其应用正不断拓展至各个领域。随着图数据规模的持续增长,包括节点数量、边的数量以及嵌入维度的不断提升,诸如DGL和PyG等标准化库应运而生,旨在简化GNN的计算过程。这些库允许以高层次的抽象方式描述计算流程,从而显著提升开发者的生产效率。然而,随着处理器核心数的迅速增加以及多核架构的演进,这些库往往表现出较差的可扩展性,并且无法实
arXiv:2610.33501v1 发布类型:新 提要:大型语言模型(LLM)的推理服务依赖于批处理以提升推理吞吐量,但键值(KV)缓存会随序列长度增长,从而限制了GPU上的并发度。通过CPU卸载,可以利用主机内存扩展KV缓存容量,然而现有系统在很大程度上仍受GPU瓶颈制约:只有当GPU调度器能够提供合适的重叠机会时,CPU驻留的请求才能取得进展。因此,主机内存与CPU计算无法作为独立的推理资源发挥作用,导致负载下CPU端进度波动加剧,并使尾部词间延迟(ITL)显著增加。我们提出了DualPace,一种将主机转变为独立调度解码引擎的LLM推理运行时。DualPace在两个引擎之间划分了调度权:GPU引擎
在准备上市之际,Anthropic提交的S-1文件使生成式AI对甲烷的依赖暴露无遗。“在获取电力供应以及具备充足电力保障的数据中心选址方面,竞争十分激烈。”在周一提交给美国证券交易委员会的文件中,Anthropic承认,数据中心正日益依赖“天然气”[…]

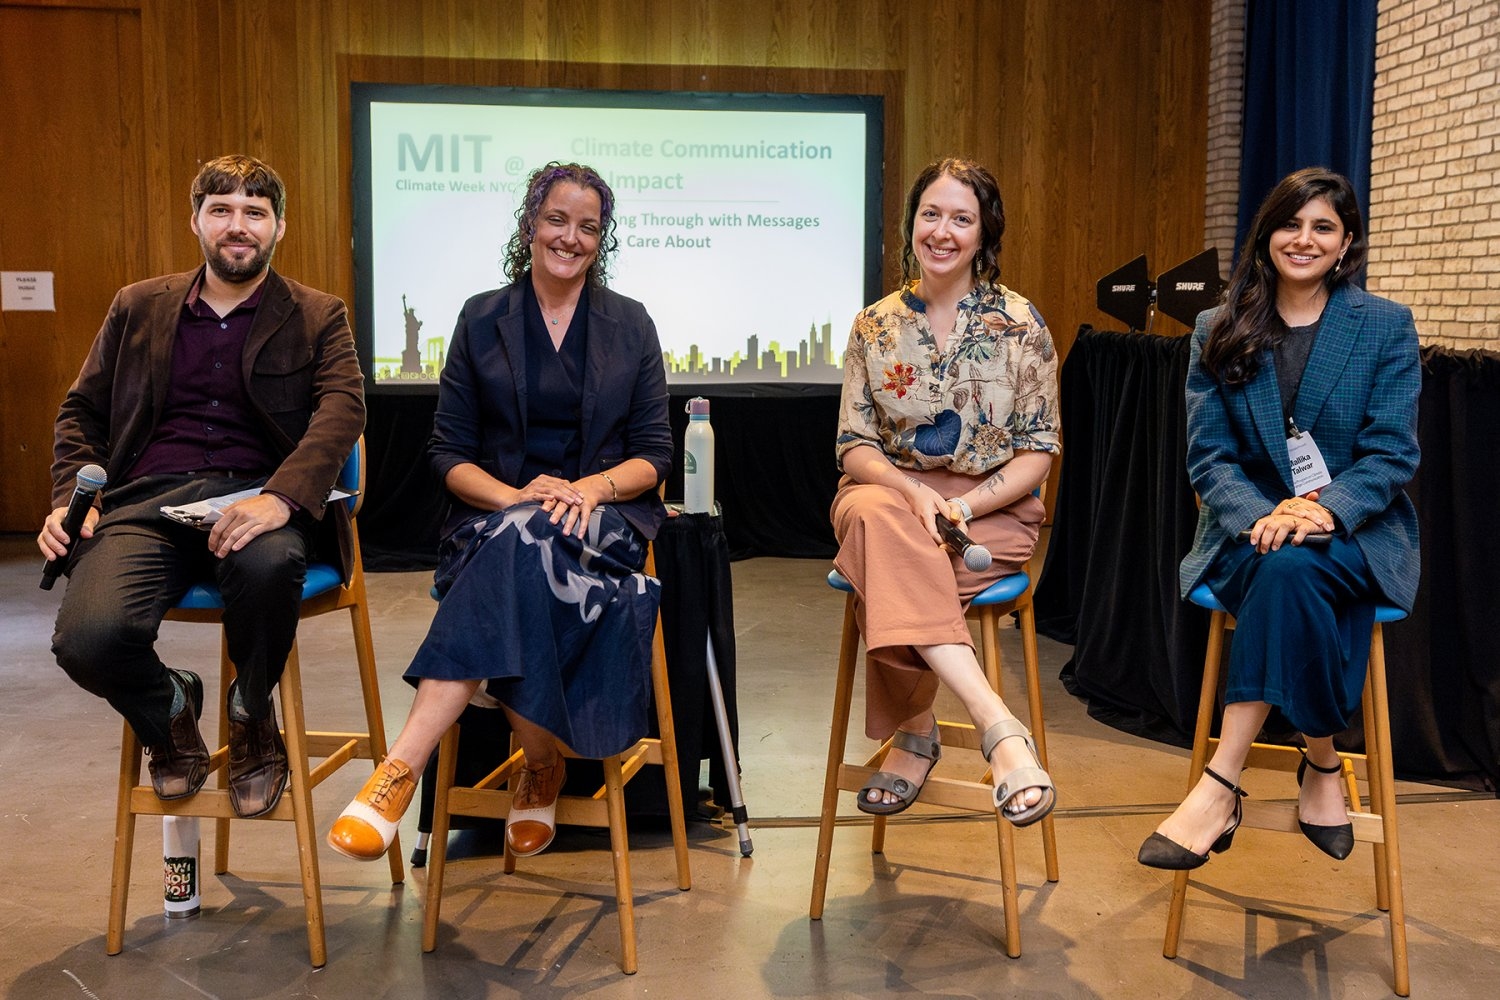
麻省理工学院社区的各界代表齐聚一堂,就数据中心、超级污染物、农业与教育等议题展开了讨论。
今天,我们来了解一下华擎面向工作站推出的高端Radeon AI推理卡——Creator Radeon AI Pro R9700。这款显卡配备32GB内存,售价1700美元,是为工作站添置本地AI推理能力的高性价比之选。文章《华擎Creator Radeon AI Pro R9700评测:AMD风格的工作站推理》首发于ServeTheHome。
SpaceX在周一提交的一份监管文件中披露,已锁定约400亿美元的融资承诺,用于支付人工智能芯片及相关数据中心设备的费用。SpaceX在一份声明中称,这是有史以来“规模最大的GPU融资承诺”。
AI工厂是迄今为止技术最为复杂的运营环境之一。数十万块GPU、NVIDIA Spectrum-X以太网……
八年前,芯片制造商美满电子科技公司决定在纳米制程领域实现跨越式发展,此后其发展轨迹一路稳步向上。在半导体制造领域,纳米制程代号所指的并非晶体管的确切物理尺寸,而是各代芯片制造技术,即所谓的工艺节点。先进的工艺节点通常能够提升晶体管密度,并带来性能上的改进……文章《美满电子在人工智能需求推动下,早期的芯片制造豪赌终获回报》首发于SiliconANGLE。
在数千块GPU上训练大规模AI模型是一项高风险的运维工作,必须内置监控与自动化机制,以优化集群的韧性……