
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

AudioLift: 멀티뷰 비디오 생성을 통한 오디오 기반 단일 이미지에서 풀헤드 가우시안 아바타로의 변환

arXiv:2610.31747v1 발표 유형: 신규 초록: 기존의 3D 말하는 아바타 방법들은 주로 3DMM이나 FLAME와 같은 파라메트릭 얼굴 모델에 의존하며, 이들 모델의 컴팩트한 움직임 표현 방식은 극단적인 표정을 합성하거나 헤드웨어와 같은 액세서리를 모델링하는 데 한계가 있습니다. 우리는 파라메트릭 얼굴 모델이나 개별 인스턴스 최적화 없이, 생성된 멀티뷰 비디오를 오디오 기반 아바타 생성을 위한 중간 표현으로 활용하는 두 단계 프레임워크인 AudioLift를 제안합니다. 본 프레임워크는 동기화된 멀티뷰 비디오 생성 단계와 불일치에 강한 가우시안 재구성 단계를 결합하여, 단일 인물 사진 이미지로부터 일관된 풀헤드 지오메트리를 복원합니다. 광범위한 실험 결과, AudioLift는 더 많은 표현을 포착할 수 있는 3D 말하는 아바타를 생성함을 보여줍니다.

AudioLift: Audio-Driven Single Image to Full-Head Gaussian Avatar via Multi-view Video Generation
진행 상황 및 관련 보도

연구자들이 일본어 사실 검증 벤치마크인 JSFactCheckBench를 발표하며, 대규모 언어 모델의 사실 검증 능력에 숨은 결함을 드러냈습니다.

2026년 10월 24일, arXiv는 논문 arXiv:2610.30504v1을 발표하여 새로운 일본어 벤치마크인 JSFactCheckBench를 소개했다. 이 벤치마크는 사실 검증 평가에서의 세 가지 주요 설계 요소(질문 연관성, 판단 조건, 증거 출처)를 최초로 명확히 정의하며, LLM이 일본 소셜 플랫폼의 오해를 유발하는 정보에 대해 내놓은 답변에서 도출된 1,913개의 진술을 포함한다. 또한 사전 선별된 온라인 정보원을 기반으로, 참고 시점에 대한 사실성과 중요성에 대한 이중 주석 작업을 완료하였다.

Rethinking the Evaluation of LLM Fact-Checkers

추천 이유:이 연구는 기존 LLM 사실 검증 평가 벤치마크가 평가 조건을 명시적으로 규범화하지 않았다는 공백을 메웠다. 구조적 주석을 통해 주류 모델들이 직접적인 답변형 진술 검증, 장문·다중 출처 위치 파악, 문맥 민감성 등 측면에서 나타내는 체계적 취약점을 드러냈으며, 모든 발견은 벤치마크가 주석 조건을 투명하게 기록하고 있다는 점에 의존하므로 방법론적 혁신성과 실증적 가치를 갖는다.

진행 상황 및 관련 보도

TauIndianBankBench 발표: 인도 소매 은행업계를 위한 프로그램 인식형 대화 에이전트 평가 벤치마크

2026년 10월 24일, 연구자들은 arXiv(번호 2610.30161v1)에 TauIndianBankBench를 발표했다—이는 언어 모델 기반 은행 대화 에이전트가 최종 기록에만 의존하지 않고, 계좌 해지 전에 정산 견적을 반드시 확보해야 하는 등 운영 절차를 엄격히 준수하는지를 평가하기 위해 설계된, 총 1,000개의 작업으로 구성된 행동 지향형 벤치마크이다.

TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents

추천 이유:이 벤치마크는 현재 LLM 평가의 맹점을 정면으로 지적합니다. 기존 방법은 대화의 최종 상태 기록만을 검증하기 때문에, 프로그램의 절차 이탈이나 권한 없는 작업이 발생한 대화 중 6.5~12.0%가 성공으로 잘못 판단되는 문제가 있었습니다. 또한, 해당 프로그램 인식 설계는 인도 은행 업무 자동화에서 준수성 평가의 핵심 공백을 메웠습니다.

진행 상황 및 관련 보도

일관성은 유효성과 같지 않다: 자기 보상 도덕적 논증은 대형 언어 모델을 더 단호하게 만들지만, 동시에 더 쉽게 조작되게 만든다

이 연구는 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30349v1), 대규모 언어 모델의 도덕적 판단 능력을 훈련하기 위해 자기 평가를 통해 논쟁의 질을 판단하는 방법을 제안했다. 연구 결과, 옵션의 순서가 변경되더라도 모델의 성과는 더 일관되게 나타났으며(즉, 더 ‘단호’하게 작동함), 그러나 도덕적 판단의 유효성은 향상되지 않았고, 여전히 아첨 경향(sycophancy)과 프레임 전환(reframing) 문제도 존재하는 것으로 확인되었다.

Consistency Is Not Validity: Self-Rewarded Moral Argumentation Makes Language Models Decisive but Pliable

추천 이유:이 논문은 순서 불변성과 같은 행동 일관성을 도덕적 추론 능력의 대리 지표로 삼는 현재의 일반적인 가정에 이의를 제기하며, 실증적으로 일관성을 최적화하더라도 본질적 판단의 질을 개선하지 못한다는 점을 보여줌으로써 AI 윤리 평가 방법론에 경고적 함의를 제공한다.

진행 상황 및 관련 보도

연구는 특이값 스펙트럼을 통한 간섭으로 대형 언어 모델의 능력 분포를 조절한다: Llama 및 Qwen 모델에 대한 실증 분석

2026년 10월 24일 arXiv(번호 2610.30676v1)에 게재된 한 AI 연구는 오픈소스 Llama 및 Qwen 지침微調 모델 다섯 가지에 대해 후속 특이값 스펙트럼 평활화와 첨두 섭동을 적용한 결과, 이러한 경량 간섭이 사실 지식, 언어 이해, 연역 추론의 세 가지 능력 간의 성과 균형을 체계적으로 재편할 수 있음을 밝혀냈다.

Spectral Smoothing and Spiking Perturbations Reconfigure Capability Profiles and Selective Task Performance in Large Language Models

추천 이유:이 논문은 다중 모델 및 다중 작업 프레임워크 하에서 변환기의 전방향층 특이값 스펙트럼 구조가 하위 작업 성능에 미치는 인과적 영향을 최초로 실증적으로 검증함으로써, 성능 배치의 구조적 민감성 법칙을 규명하고 모델 성능의 해커팅 및 제어 가능한 편집을 위한 새로운 경로를 제시하였다. 모든 결론은 공개된 모델과 표준 평가 기준에 기반하며, 방법은 투명하고 평가 차원은 포괄적이다.

진행 상황 및 관련 보도

내일 무엇을 물어볼지 학습하기: 장기적 개인화 웹 에이전트를 위한 능동적 선호도 획득

arXiv:2610.31107v1 발표 유형: 신규 요약: 웹 에이전트는 여행 예약, 쇼핑, 일정 관리 등 반복적인 온라인 작업에서 동일한 사용자를 지속적으로 지원하므로, 그들의 장기적 유용성은 사용자의 선호를 얼마나 잘 파악하고 있는가에 달려 있습니다. 수동적 기억 및 개인화 방법은 사용자가 결코 드러내지 않는 선호를 파악할 수 없으며, 현재 작업에 대한 이익만을 중시하는 명확화 방법은 이후 작업에서도 해당 답변을 재사용할 수 있는 이점을 간과합니다. 우리는 능동적 선호도 획득(APA)을 연구합니다: 어떤 누락된 선호가 질문하는 데 드는 비용을 감수할 만한 가치가 있을까요? 우리는 누락된 선호의 전망적 개인화 가치(PPV)를, 향후 작업들에서 기대되는 누적 효용 증가에서 질문에 따른 노력과 정보 공개 위험 비용을 차감한 값으로 정의하고, 질문을 선택합니다.

Learning What to Ask for Tomorrow: Active Preference Acquisition for Long-Term Personalized Web Agents
진행 상황 및 관련 보도

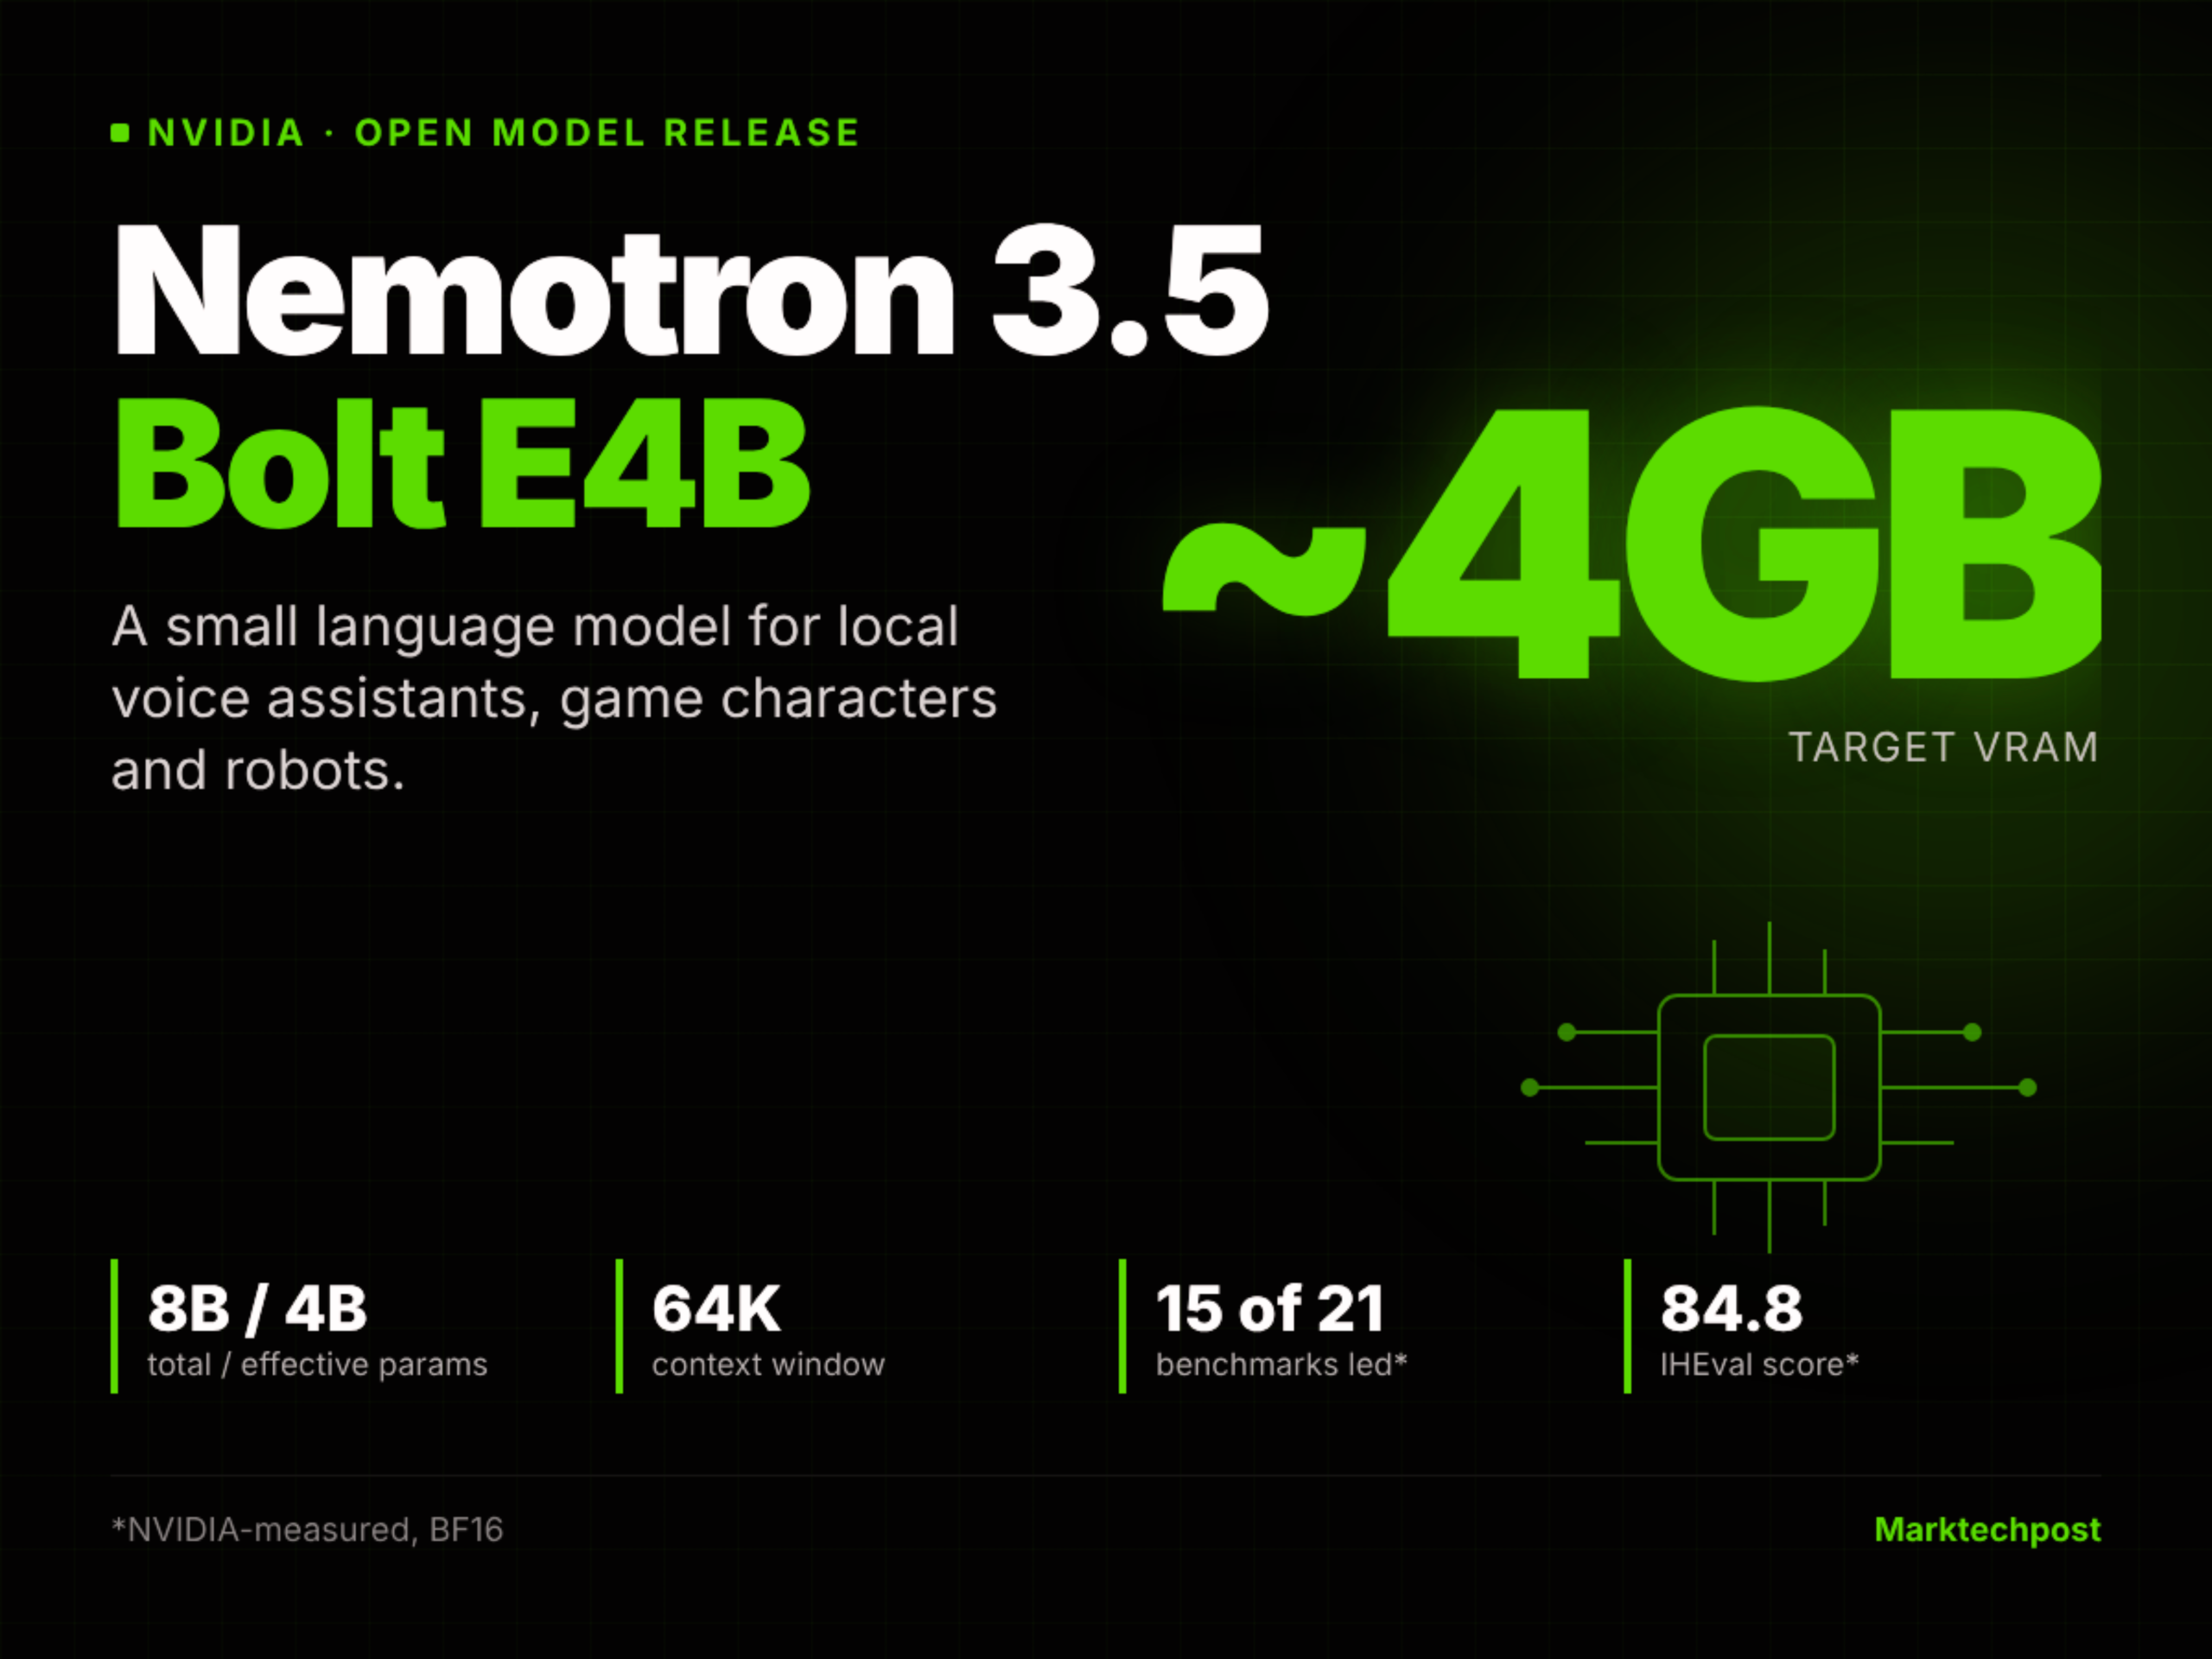
NVIDIA가 오픈소스 소형 언어 모델인 Nemotron 3.5 Bolt E4B 4GB를 발표했으며, 이는 로컬 음성 에이전트, 게임 NPC 및 로봇에 최적화되어 있습니다.

NVIDIA는 Google Gemma 4 E4B 모델을 기반으로, 강화학습(RL) 후 훈련만을 거쳐 Nemotron 3.5 Bolt E4B 4GB를 출시했습니다. 이는 총 매개변수 8B, 유효 매개변수 4B, 64K의 컨텍스트를 갖춘 오픈소스 소형 언어모델로, RTX 및 Jetson 등 엣지 디바이스에서 약 4GB VRAM으로 구동되며, 다중 라운드 도구 호출과 저지연 음성 상호작용을 지원합니다.

NVIDIA Releases Nemotron 3.5 Bolt E4B 4GB: An Open Small Language Model for Local Voice Agents, Game Characters and Robots
진행 상황 및 관련 보도

유럽의 여러 주요 금융기관이 오픈소스 대형 모델을 활용해 독자적인 지능형 시스템을 구축하고 있습니다.

GTC 베를린 컨퍼런스에서 Revolut, Starling Bank, Lloyds, Santander 등 유럽의 금융기관들은 NVIDIA 가속 컴퓨팅 플랫폼과 PRAGMA, Nemotron 시리즈, Kumo 패밀리와 같은 오픈소스 가중치 모델을 기반으로 생산 수준의 AI 역량을 구축한다고 발표했습니다. 이는 거래 분석, 음성 인식, 사기 탐지, 데이터 파이프라인 가속 등 핵심 시나리오를 포괄하며, 데이터 주권, 비용 통제 및 규정 준수 기반 배포를 강조합니다.

진행 상황 및 관련 보도

마이크로소프트와 허깅페이스가 ThinkingBox 프레임워크를 오픈소스로 공개: 데이터베이스의 최종 상태를 결정적 보상 신호로 활용하여 지능체의 강화학습 후처리를 촉진

마이크로소프트와 허깅페이스가 공동으로 오픈소스 프레임워크인 ThinkingBox를 출시했으며, 이는 LLM 에이전트가 실행한 후의 실제 데이터베이스 최종 상태와 예상 상태를 비교하여 0/1 이진 보상을 생성함으로써 강화학습을 통해 모델을 미세조정하는 데 활용된다. 이와 함께 제공되는 벤치마크인 ThinkingBox-Bench에는 실제 백엔드 작업 507개가 포함되어 있으며, 해당 작업들은 모두 학습에 사용되지 않았다. Qwen3.8-27B는 50단계의 GRPO 미세조정을 거친 결과, 유지 테스트 세트에서 pass@1 지표가 9.08%포인트 상승하고 Observed 20/20 지표는 약 3배 증가했으나, 일부 분야에서는 pass@20 지표가 하락해 광범위성과 안정성 간의 균형을 반영했다.

진행 상황 및 관련 보도

파나슈 — 모바일용 벨 에포크 RTS

파나슈 — 모바일용 벨 에포크 RTS 참으로 기분 좋은 일이네요: 저는 어제 Apache 2.0 라이선스 하에 ‘배틀 드론스’를 출시했는데, 이미 프랑스어 버전 포크가 나와서 게임의 배경을 스팀펑크풍의 1900년대 프랑스로 바꾸고 애니메이션 인트로까지 추가했습니다! 파나슈는 모바일과 웹브라우저에서 즐길 수 있는 벨 에포크 시대(약 1900년경)의 프랑스를 배경으로 한 실시간 전략 게임입니다. 비행선, 증기식 장갑차, 크뢰조 장갑함, 투구를 쓴 자동인형, 그리고 이동하는 요새 ‘가르강튀아’ 등, 화려한 볼거리가 가득합니다. 여기에서 파나슈를 플레이해 보실 수 있습니다—새로운 인트로 영상을 직접 확인해 보시려면 링크를 클릭해 보시는 것도 좋습니다. 현재까지는 게임플레이 변경보다는 주로 미적 요소 위주의 업데이트에 그치고 있습니다. 음악에도 프랑스 특유의 감성이 더해졌고요. 새로운 스팀펑크 스타일의 모델들은 정말 멋집니다! 여기에는 해당 페이지가 있습니다.

진행 상황 및 관련 보도

GPT-OSS-20B 다중언어 추론 미세조정 실험: SFT는 초보자 수준의 행동 습득을 가능하게 하며, GRPO는 확률 헤드 공간이 존재할 때에만 효과적으로 성능을 향상시킨다.

AWS 팀은 Amazon SageMaker HyperPod에서 GPT-OSS-20B를 대상으로 다국어 추론 미세조정 실험을 수행했으며, LoRA 기반의 효율적 파라미터 미세조정을 적용했습니다. SFT는 영어·프랑스어·독일어·스페인어·이탈리아어 등 5개 언어에 대한 추론 정확도를 22%에서 100%로 끌어올렸지만, 답변 언어의 정확도는 62%에 그쳤습니다. GRPO는 이를 바탕으로 답변 언어 정확도를 70%까지 추가로 개선했으며, 추론 언어 성능에는 별다른 손상을 주지 않았습니다. 다만 이익의 정도는 언어마다 상이하여, 예를 들어 스페인어는 30%p 향상된 반면 이탈리아어는 20%p 하락했습니다. 실험 결과는 GRPO가 새로운 능력을 제로 상태에서 창출할 수 없으며, 기존에 간헐적으로 나타나던 행동만을 최적화할 수 있음을 분명히 보여줍니다.

진행 상황 및 관련 보도

봉사의 소명: 기술, 연구, 그리고 긍정적 영향

연구실장 크리스 화이트는 전시 데이터 분석에 대한 새로운 접근법부터 인신매매 방지 도구에 이르기까지, 현실 세계에 실질적인 영향을 미치는 연구 과제들을 수행해 왔습니다. 그는 프로그램 매니저 위슝 리우와 함께 이러한 연구를 이끌어 온 배경과 더 많은 이야기를 나눕니다. “봉사의 소명: 기술, 연구, 그리고 긍정적 영향”이라는 글은 마이크로소프트 리서치에서 처음 게재되었습니다.

진행 상황 및 관련 보도

AnyLanguageModel 1.0 출시: 로컬 및 호스팅 모델을 지원하는 통합 Swift 인터페이스로, Apple 플랫폼의 모든 OS에 완벽히 대응합니다 27

Hugging Face는 AnyLanguageModel 1.0을 정식으로 출시했으며, Apple Foundation Models API와 완전히 호환되는 오픈소스 Swift 프레임워크를 제공합니다. 이 프레임워크는 로컬 모델(MLX, llama.cpp, Core ML)과 호스팅 모델(OpenAI, Anthropic, Gemini, Hugging Face Inference Providers 등) 간의 원활한 전환을 지원하며, 이미지 입력, 도구 호출, 가이드형 생성, 추론 블록 자동 적응 등의 기능도 추가되었습니다.

진행 상황 및 관련 보도

프로그래밍에 대한 나의 부고

프로그래밍에 대한 나의 부고 제레미 쉐프는 코드를 개발하는 과정에서 느끼는 퍼즐의 매력으로 인해 경력을 쌓아온 프로그래머들에게 발생한 핵심적인 상실감을 매우 절절하게 담아냈습니다. 프로그래밍은 상상할 수 있는 가장 훌륭한 직업 중 하나로 변모했습니다. 당신은 까다롭고 작은 논리 퍼즐을 해결하는 일로 보수를 받았습니다. 퍼즐이 더 복잡할수록, 더 많은 보수를 받았죠. 하지만 심지어 아주 간단한 퍼즐조차도 큰 가치를 지녔습니다. 왜냐하면 일반 사람들은 도저히 해낼 수 없었기 때문입니다! 아니, 그들은 우리를 필요로 했습니다. 그들은 우리에게 문제를 주고, 우리는 우리가 원하는 방식으로 그것을 해결했습니다. 우리는 전략을 세우고, 일정을 계획하며, 무엇이 가능하고 무엇이 불가능한지를 정의했습니다. 만약 당신이 작동하는 시스템을 구축하는 데서 큰 성취감을 얻고, 그 과정에서 해결되는 문제들에는 그리 큰 관심을 두지 않는 프로그래머라면, LLM은 끝없이 선물처럼 다가오는 존재입니다. 만약 직접적으로 해결하는 것이

진행 상황 및 관련 보도

llm-echo 0.5

릴리스: llm-echo 0.5 저는 새로운 LLM 릴리스를 준비하고 있으며, PR 테스트 과정에서 llm-echo 디버그 플러그인을 다시 살펴보게 되었습니다. 이 플러그인은 LLM을 전혀 사용하지 않고, 단순히 입력된 프롬프트를 그대로 반복하는 ‘모델’을 제공합니다. 이번 새 릴리스에서는 도구 호출, 시스템 프롬프트, 추론 토큰까지 고려하여 시뮬레이션된 토큰 사용량 카운트를 업데이트했습니다. 예시 사용법: uvx --with llm-echo llm -m echo 'hi there' -o thinking 1 --usage 출력 결과: 먼저 프롬프트를 검토한 후, 무엇을 말할지 결정합니다. { "prompt": "hi there", "system": "", "attachments": [], "stream": true, "previous": [] } 토큰 사용량: 입력 2개, 출력 24개 태그: llm

진행 상황 및 관련 보도

독점 인터뷰: AI 의존성에 관한 체이스 칙—AI는 우리를 돕는 사고를 촉진하는가, 아니면 우리를 대신해 사고하는가?

AI는 우리를 더 나은 사상가로 만들어줄 수도 있지만, 동시에 우리의 판단에 의존하게 만들 수도 있다. 그레이 스카이 AI의 최고경영자 체이스 칙은 유용한 도움이 어디까지이고 인지적 의존이 어디에서 시작되는지에 대해 탐구한다.

진행 상황 및 관련 보도

애디 오스마니, 모건 웨슬리 런트, 그리고 칭 왕의 인용

우리는 “이 코드를 사람이 읽었나요?”라는 질문이 “이 변경에서 어떤 문제가 발생할 수 있으며, 이를 잡아낼 적절한 검사는 자동화된 것인지 인간의 것인지”라는 질문을 정확히 대신한다고 보지 않습니다. 이러한 질문을 던지는 방식도 리뷰가 이루어지는 시점에 따라 달라집니다. 이전에는 리뷰가 길의 끝에 있는 관문처럼 작용했습니다: 코드를 작성하고, PR을 열고, 동료의 답변을 기다리는 것이었습니다. 이제는 리뷰가 지속적으로 진행되며, 마치 글을 쓰는 도중 맞춤법 검사를 하는 것과 같습니다. 대부분의 변경 사항은 인간이 검토하기 전에 최소 한 번 이상 Claude에 의해 검토되고 수정됩니다. 이를 통해 일상적인 실수 대부분을 미리 발견할 수 있고, 팀의 주의력을 더 고차원적인 문제와 심층적 검토에 집중시킬 수 있습니다. — 애디 오스마니, 모건 웨슬리 런트, 그리고 칭 왕, Claude Code 팀의 코드 리뷰 방식 태그: 안트로픽, Claude, AI, Claude-Code, LLMs, 애디-오스마니, 코딩-에이전트, 생성형-AI, 에이전틱-엔지니어링,

진행 상황 및 관련 보도

Reflection이 오픈소스 대규모 언어 모델 Beam을 발표했습니다: 501B 파라미터의 희소 MoE 아키텍처로, 수백만 단어 규모의 컨텍스트와 다중 단계 추론 제어를 지원합니다.

리플렉션 회사는 오픈소스 대규모 언어 모델인 Beam(매개변수 501B, 실제 활성화 수치 23B/토큰)을 출시했으며, 256개의 전문가 스파스 MoE 아키텍처를 채택하고 1M의 컨텍스트 지원, NVFP4/FP8 양자화, 다중 단계 추론 옵션 구성 및 로컬 배포를 제공합니다. 모든 기술 관련 발표는 제3자 검증을 거치지 않았으며, 하드웨어 요구 사항이 높아 개인 사용자가 이를 감당하기는 어렵다는 평가가 지배적입니다.

진행 상황 및 관련 보도