
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

인도네시아 임상 영양 Q&A 기준인 IndoNutriQA가 공식 출시되었습니다.

2026년 10월 24일, 연구팀은 arXiv에 논문(번호 2610.31256v1)을 발표하며 인도네시아어 임상 영양 분야를 위한 최초의 전문가 주석 기반 질문응답 평가 벤치마크인 IndoNutriQA를 공개했습니다. 이 벤치마크는 실제 임상 보고서에서 도출된 911쌍의 질문-응답 쌍을 포함하며, 학습이 아닌 평가에 중점을 두고 있으며 생성형, 추출형 및 검색 강화형 질문응답 과제를 지원합니다.

IndoNutriQA: An Indonesian Clinical Nutrition Question Answering Benchmark

추천 이유:이 벤치마크는 저자원 언어(특히 인도네시아어)를 대상으로 한 임상 영양 NLP 분야의 고품질 공개 평가 데이터 부족이라는 공백을 메우며, 구조화된 메타데이터가 완비되고 질문 유형이 영양 간호 프로세스(NCP)를 엄격히 준수하며, 전문가 검증과 다중 모델 벤치마크를 완료하여 명확한 연구적 정위와 방법론적 엄밀성을 갖추고 있습니다.
진행 상황 및 관련 보도

연구는 LLM이 생성한 합성 설문조사 응답자 커버리지를 평가하는 새로운 지표 RCG를 제안했다.

이 논문은 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30900v1), 대규모 언어 모델(LLM)이 생성한 합성 설문 응답자가 실제 인간 응답자를 완전한 응답 프로파일 공간에서 얼마나 잘 포괄하는지를 측정하기 위한 새로운 평가 지표인 ‘응답자 포괄 격차’(RCG)를 제안한다.

Silicon Samples Match the Answers but Not the Respondents

추천 이유:기존 평가 방법은 단일 문항의 정답 분포나 문항 간 상관성에만 주목할 뿐, LLM이 생성한 응답자가 실제 모집단에서 실제로 존재하는 정답 조합을 재현했는지 여부를 식별할 수 없다. RCG는 최초로 전체 응답 프로파일을 기반으로 커버리지 격차를 정량화하였으며, 두 가지 미국 사회조사 데이터를 통해 모든 테스트 대상 LLM에서 유의미한 미커버리지 인구가 존재하고, 이들이 단순한 변동성 표본 추출 기준선 및 가우스 코플라 모델보다 성능이 저조함을 실증적으로 확인했다.

진행 상황 및 관련 보도

연구에 따르면 다국어 평가에서 ‘대규모 모델이 심판 역할을 하는’ 효과는 심판 모델의 선택에 크게 의존하는 것으로 나타났다.

2026년 10월 24일 arXiv에 게재된 다국어 실증 연구에 따르면, 현재 주류를 이루는 프롬프트 전략(예: 사고 체인, 역할 설정)은 LLM-as-a-Judge 환경에서 모델 간 및 언어 간 이전성이 결여되어 있으며, 심판 모델의 선택이 프롬프트 전략 자체보다 훨씬 더 큰 영향을 미치며, 심지어 전략의 효과가 서로 다른 심판 모델 간에서 방향성이 뒤바뀌는 현상까지 나타난다고 밝혀졌다.

Prompting Strategy Effects Depend on the Judge: A Multilingual Study of LLM-as-a-Judge Robustness

추천 이유:이 연구는 최초로 9가지 힌트 전략, 4개의 오픈소스 평가 모델, 27개 언어 및 13개 데이터셋 간의 상호작용 효과를 체계적으로 측정했으며, 인공 검증을 거친 100만 건 이상의 점대점 평가 결과를 도출해 영어 중심의 힌트 연구와 고정 템플릿 기반 다국어 연구 사이의 중요한 공백을 메웠다.

진행 상황 및 관련 보도

IFC-MCQ: 건축 정보 모델링을 위한 LLM 에이전트 기반 자동 다지선다형 문제 벤치마크 생성 방법

연구자는 2026년 10월 24일 arXiv에 IFC-MCQ 방법을 발표했으며, 이는 건축·엔지니어링·건설(AEC) 분야에서 대형 언어 모델(LLM) 기반의 Industry Foundation Classes(IFC) 데이터 검색 시스템을 위해 정확한 점수 부여가 가능한 객관식 문제 벤치마크를 자동으로 생성하는 것을 목표로 한다.

IFC-MCQ: Automatically Generating Multiple-Choice Benchmarks for Evaluating LLM Agents on IFC Data Retrieval

추천 이유:이 연구는 IFC와 같은 전문적인 구조화된 데이터에 대해 LLM을 평가하는 데 있어 난이도와 비용 부담이라는 핵심 과제에 정면으로 도전하며, IFC 파일을 대상으로 한 최초의 자동화된 다지선다형 질문 생성 프레임워크를 제안합니다. 이 프레임워크는 15개 범주와 36개 하위 범주를 포괄하며, 재현 가능하고 확장 가능한 에이전트 성능 평가를 지원합니다.

진행 상황 및 관련 보도

FusionEval 발표: 대규모 언어 모델 통합을 위한 새로운 벤치마크 테스트

2026년 10월 24일, 연구자들은 arXiv에 논문 arXiv:2610.30162v1을 발표하여, 대규모 언어 모델의 통합 방법 평가를 위해 설계된 최초의 통합 벤치마크인 FusionEval을 제안했다. 이 벤치마크는 추론 체인 길이, 도구 호출 등 취약한 부분을 포괄하며, 학습 기반 및 학습 불필요형 통합 방법 간의 비교도 지원한다.

FusionEval: Benchmarking Model Fusion for Large Language Models

추천 이유:이 벤치마크는 기존 평가에서 장기 체인 추론과 도구 활용에 대한 포괄성이 부족한 점을 보완하며, 평균 성능과 최악의 성능 간의 명확한 구분을 제공하고, Qwen3/Llama 기반의 재현 가능한 전문가 풀, GPU 메모리 및 실행 시간을 포함한 다차원 지표, 그리고 오픈소스 코드를 제공하여 강력한 실무 지침성을 갖추고 있습니다.

진행 상황 및 관련 보도

WikiOriginQA 출시: 위키백과 다국어 버전의 생성 시점을 기반으로 자동으로 구축된 문화적 편향 평가 질문·답변 데이터셋

연구팀은 2026년 10월 24일 arXiv에 논문(번호 2610.30677v1)을 게재하여, 각 언어별 위키백과 버전의 생성일을 활용해 지식의 기원을 객관적으로 표시함으로써 문화적 편향 평가의 확장성을 높이는 것을 목표로 하는, 완전 자동으로 구축된 질문-응답 데이터셋인 WikiOriginQA를 소개했습니다.

WikiOriginQA: Automated Construction of a QA Dataset with Knowledge Origins for Analyzing Cultural Bias

추천 이유:이 연구는 인공 라벨링 없이도 다국어를 아우르며 문화 지식의 기원 추적 데이터를 대규모로 생성할 수 있는 방법을 제안하고, 실험을 통해 대형 언어 모델이 영어권 문화 관련 문제에서 체계적인 성능 우위를 보임을 입증함으로써, 문화 편향의 정량적 분석을 위한 새로운 도구를 제공합니다.

진행 상황 및 관련 보도

연구는 코딩 에이전트 벤치마크에서의 ‘규범-오프체인 오라클 갭’ 문제를 밝혀냈다.

2026년 10월 24일 arXiv에 게재된 한 논문은 현재 주류 코딩 지능 에이전트 벤치마크(예: SWE-Milestone)에 ‘규격–오라클 격차’가 존재한다고 지적한다. 즉, 과제의 자연어 설명에는 테스트에 필요한 핵심 구현 세부사항(예: 상수 이름, 모듈 경로, 정확한 오류 메시지 등)이 포함되어 있지 않아, 평가 결과가 실제로는 상위 코드를 얼마나 재현하는지에 대한 능력을 측정할 뿐이며 진정한 이해와 추론 능력을 반영하지 못한다는 것이다.

What the Specification Did Not Say: Specification-Oracle Gaps in Test-Graded Coding-Agent Benchmarks

추천 이유:이 연구는 해당 유형의 편향을 최초로 형식적으로 정의하고, 다섯 가지 언어를 포괄하는 정적 감사 도구를 구축하여 정확도 89.2%, 재현율 92.9%를 달성했으며, SWE-Milestone에서 25개의 마일스톤 작업에 추론할 수 없는 암시적 의존성이 존재함을 실증적으로 밝혀냈습니다. 이는 실패율을 크게 높였으며(80.6% 대 48.4%), 현재 순위표가 ‘명칭 복사’형 에이전트를 체계적으로 선호할 수 있음을 드러냅니다. 연구 결과는 감사 도구와 수정 자료를 오픈소스로 공개하여 방법론적 및 실무적 측면에서 모두 높은 가치를 지닙니다.

진행 상황 및 관련 보도

내일 무엇을 물어볼지 학습하기: 장기적 개인화 웹 에이전트를 위한 능동적 선호도 획득

arXiv:2610.31107v1 발표 유형: 신규 요약: 웹 에이전트는 여행 예약, 쇼핑, 일정 관리 등 반복적인 온라인 작업에서 동일한 사용자를 지속적으로 지원하므로, 그들의 장기적 유용성은 사용자의 선호를 얼마나 잘 파악하고 있는가에 달려 있습니다. 수동적 기억 및 개인화 방법은 사용자가 결코 드러내지 않는 선호를 파악할 수 없으며, 현재 작업에 대한 이익만을 중시하는 명확화 방법은 이후 작업에서도 해당 답변을 재사용할 수 있는 이점을 간과합니다. 우리는 능동적 선호도 획득(APA)을 연구합니다: 어떤 누락된 선호가 질문하는 데 드는 비용을 감수할 만한 가치가 있을까요? 우리는 누락된 선호의 전망적 개인화 가치(PPV)를, 향후 작업들에서 기대되는 누적 효용 증가에서 질문에 따른 노력과 정보 공개 위험 비용을 차감한 값으로 정의하고, 질문을 선택합니다.

Learning What to Ask for Tomorrow: Active Preference Acquisition for Long-Term Personalized Web Agents
진행 상황 및 관련 보도

연구에 따르면 오픈소스 대규모 모델에서는 구조화 추출 과정에서 목록 채우기 현상이 널리 나타난다.

2026년 10월 24일 arXiv에 게재된 한 실증 연구(논문 번호 2610.30997v1)에 따르면, JSON 추출 스키마에서 목록의 최소 항목 수를 설정했지만 문서의 실제 내용이 이를 충족하지 못하는 경우, 여덟 가지 오픈소스 가중치 모델 모두가 해당 최소값을 제약 조건이 아닌 생성 목표로 간주하여, 결과적으로 출력 목록의 길이가 실제 개수를 초과하는 비율이 55.4%에 달했다(기준선은 34.5%); 보충 항목은 원문에서 주로 가져오며, 약 절반은 출처 일관성 검사를 통과했다; 일반적인 완화 전략의 효과는 제한적이다.

Padding to k: A Minimum Count in the Schema Makes Open-Weight Models Pad Their Extraction Lists

추천 이유:이 연구는 사전 등록된 연구 설계를 채택하여, 558개의 실제 문서와 아홉 개의 주석화된 데이터셋을 대상으로 여덟 가지 오픈소스 모델과 여섯 가지 클라우드 기반 서비스 모델을 체계적으로 평가하였다. 연구 방법은 엄격하며, 데이터는 공개되어 있으며(코드와 결과물은 GitHub에 게시됨), 구조화된 정보 추출에서 간과되기 쉽지만 하위 작업의 신뢰성에 큰 영향을 미치는 핵심적인 결함—스키마에 의해 유도되는 비충실한 채우기 행동—을 규명하였다.

진행 상황 및 관련 보도

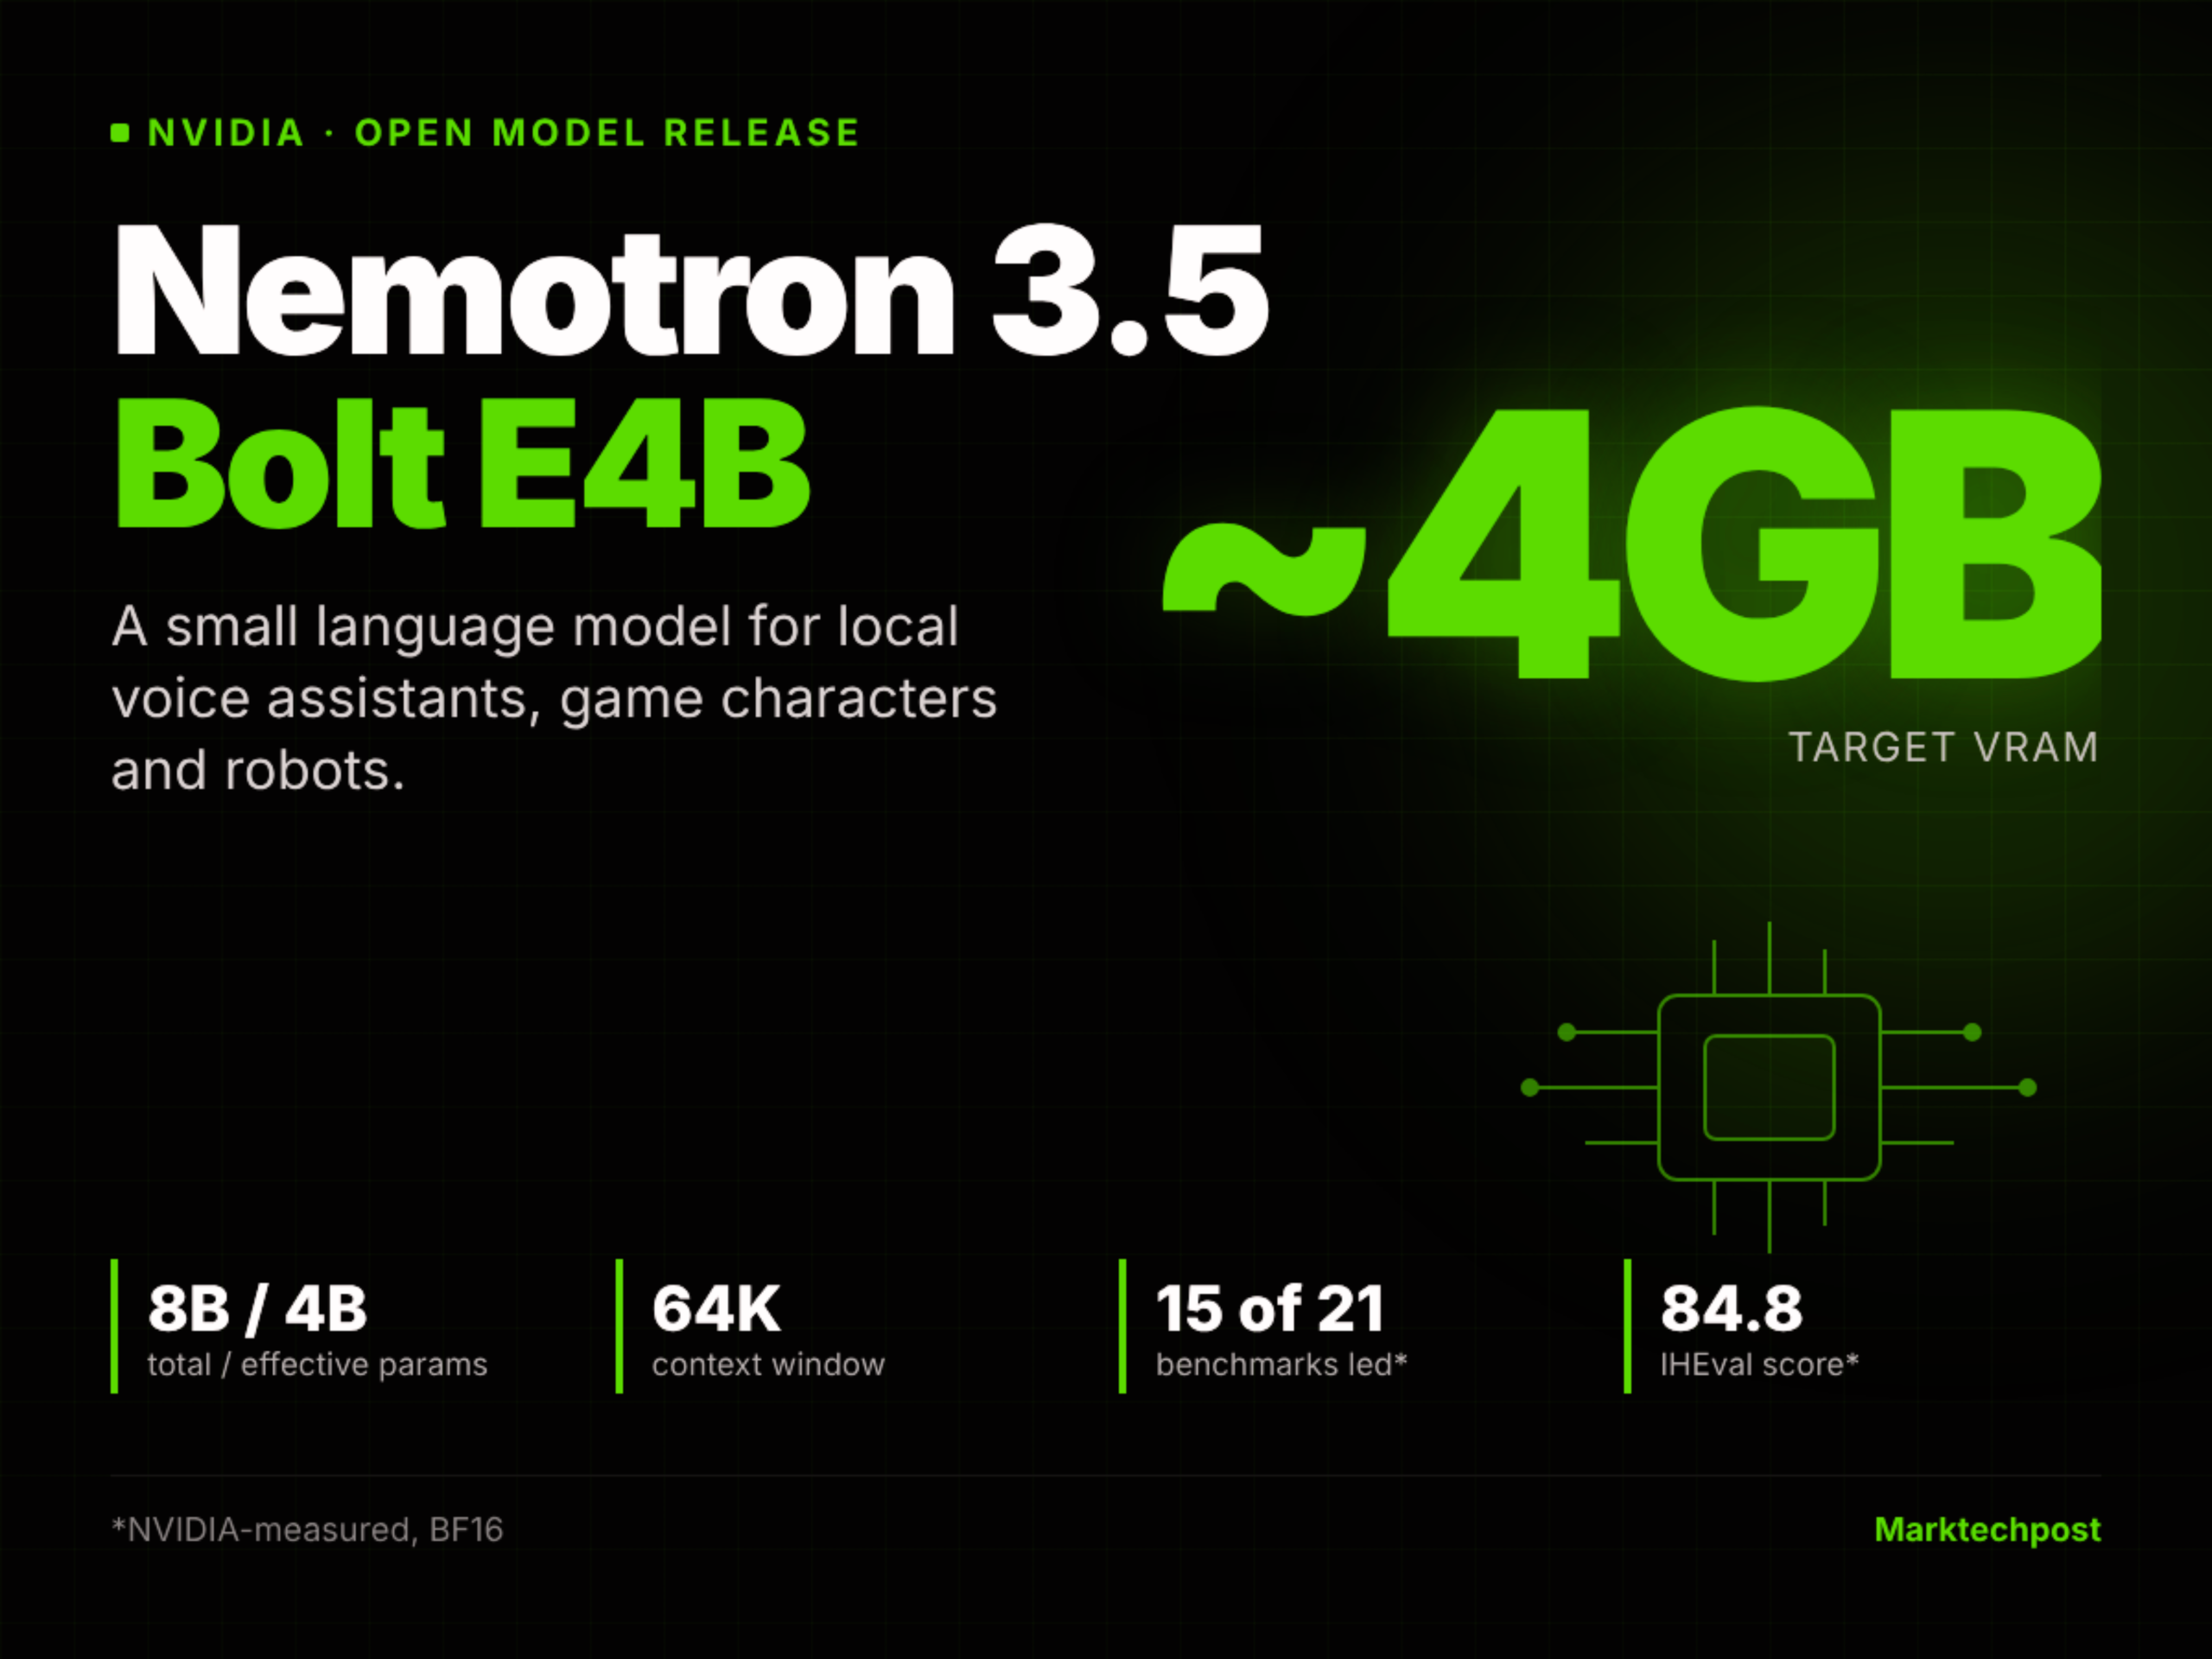
NVIDIA가 오픈소스 소형 언어 모델인 Nemotron 3.5 Bolt E4B 4GB를 발표했으며, 이는 로컬 음성 에이전트, 게임 NPC 및 로봇에 최적화되어 있습니다.

NVIDIA는 Google Gemma 4 E4B 모델을 기반으로, 강화학습(RL) 후 훈련만을 거쳐 Nemotron 3.5 Bolt E4B 4GB를 출시했습니다. 이는 총 매개변수 8B, 유효 매개변수 4B, 64K의 컨텍스트를 갖춘 오픈소스 소형 언어모델로, RTX 및 Jetson 등 엣지 디바이스에서 약 4GB VRAM으로 구동되며, 다중 라운드 도구 호출과 저지연 음성 상호작용을 지원합니다.

NVIDIA Releases Nemotron 3.5 Bolt E4B 4GB: An Open Small Language Model for Local Voice Agents, Game Characters and Robots
진행 상황 및 관련 보도

IBM은 Granite 시계열 통합 예측 모델을 발표했습니다: 네 가지 모델을 미세조정 없이 결합하여 안정적인 기본 예측 솔루션을 제공합니다.

IBM 리서치는 오픈소스인 Granite Timeseries Ensemble(v1)을 출시했으며, PatchTST-FM-r1/r2, FlowState 및 Tiny Time Mixers 등 네 가지 사전훈련 아키텍처를 통합해 제로 편향(zero-shot) 미세조정 없이도 확률적 앙상블 예측을 지원합니다. 기본적으로 동등한 가중치의 확률적 앙상블(Probabilistic Ensemble)을 채택하며, 사분위 범위 기반 적응형 가중치(IQR Ensemble) 옵션도 제공합니다. GIFT-Eval 벤치마크(2026-10-20 기준 스냅샷)에서 점예측 오차(MASE=0.683)는 최고의 단일 모델보다 약간 우수하며, 전반적인 로버스트성이 크게 향상되었습니다.

진행 상황 및 관련 보도

AI 에이전트 환각 탐지의 다중 레이어 방법: 생산 환경을 위한 실용적 프레임워크

본 문서는 AI 에이전트가 실제 워크플로에서 발생하는 환각의 네 가지 전형적 유형(사실성, 맥락성, 허구성, 자기모순)을 체계적으로 정리하고, 단일 점수에 의존하기보다 신뢰도 검사, 출처 검증, 자기 일관성 평가, 의미 엔트로피 분석 및 인간-기계 협업 임계값 등 다차원적 검사 방식을 병행해야 한다고 제안한다. 또한 이러한 검사는 워크플로의 폐쇄 루프에 내장되어 관측성, 오류 처리 및 인력 검토 경로와 깊이 통합되어야 함을 강조한다.

진행 상황 및 관련 보도

마이크로소프트와 허깅페이스가 ThinkingBox 프레임워크를 오픈소스로 공개: 데이터베이스의 최종 상태를 결정적 보상 신호로 활용하여 지능체의 강화학습 후처리를 촉진

마이크로소프트와 허깅페이스가 공동으로 오픈소스 프레임워크인 ThinkingBox를 출시했으며, 이는 LLM 에이전트가 실행한 후의 실제 데이터베이스 최종 상태와 예상 상태를 비교하여 0/1 이진 보상을 생성함으로써 강화학습을 통해 모델을 미세조정하는 데 활용된다. 이와 함께 제공되는 벤치마크인 ThinkingBox-Bench에는 실제 백엔드 작업 507개가 포함되어 있으며, 해당 작업들은 모두 학습에 사용되지 않았다. Qwen3.8-27B는 50단계의 GRPO 미세조정을 거친 결과, 유지 테스트 세트에서 pass@1 지표가 9.08%포인트 상승하고 Observed 20/20 지표는 약 3배 증가했으나, 일부 분야에서는 pass@20 지표가 하락해 광범위성과 안정성 간의 균형을 반영했다.

진행 상황 및 관련 보도

NVIDIA가 Kumo Forecast를 발표했습니다: 사전 훈련된 시계열 표현, 과거 패턴 검색 및 해석 가능성을 통합한 다변량 예측 모델

NVIDIA는 오픈소스 시계열 예측 모델인 Kumo Forecast(구 NV-Tesseract Forecasting)를 출시했습니다. 이 모델은 MOMENT-1-large Transformer 아키텍처를 기반으로 하며, 직접 예측과 도메인 인식 표현 및 검색(DARR)의 두 가지 경로 추론을 지원하고, 모델 구조를 수정할 필요 없이 내장된 해석 가능성 프레임워크를 탑재하고 있습니다.

진행 상황 및 관련 보도

i14, Laplace 3B 선형 주의 메커니즘 모델 발표: AWS Trainium2와 네이티브 PyTorch를 기반으로 한 고정 상태 메모리 추론 구현

i14는 30.28억 개의 파라미터를 갖는 Laplace 3B 모델을 출시했으며, Softmax 주의 메커니즘을 대체해 게이트 제어 선형 주의(GLA)를 채택했습니다. 이 모델은 추론 시 각 시퀀스의 재귀 상태 크기가 항상 29.5 MB로, 컨텍스트 길이와 무관합니다. 해당 모델은 AWS trn2.48xlarge 인스턴스 한 대(Trainium2 칩 16개 탑재)에서 훈련 및 서비스 검증을 완료했으며, 훈련 처리량은 초당 12만 토큰에 달하고, 서비스 처리량은 초당 11,544 출력 토큰(동시 실행 시퀀스 수 1,280)입니다. 모든 성능 데이터는 i14와 AWS GenAIIC 팀의 내부 실측 결과입니다.

진행 상황 및 관련 보도

미스트랄, Voxtral 3 음성 지능형 에이전트 SDK 출시: 50여 개 언어의 실시간 음성 상호작용과 감성형 TTS 지원

Mistral은 2026년 10월 26일 이전에 Voxtral 3를 출시할 예정이며, 이는 다국어 실시간 음성 상호작용을 위한 엔드투엔드 SDK 및 모델 패밀리로, ASR(화자 분리 기능 포함), 추론 계층, TTS 등 세 가지 주요 모듈을 포괄합니다. 데이터 주권과 모듈식 배포를 강조하지만, 모든 성능 관련 주장은 제조사 자체 테스트에 근거한 것으로, 독립적인 제3자 검증은 이루어지지 않았습니다.

진행 상황 및 관련 보도

IMF 방콕 회의 연설이 큰 화제를 불러일으켰다: 전 OpenAI 및 Anthropic 공동 설립자는 ‘특이점이 이미 시작됐다’고 밝혔다.

2026년 10월 17일, 전 OpenAI 직원이자 Anthropic의 공동 설립자는 IMF 방콕 회의에서 연설을 통해 “기술적 특이점이 이미 시작되었다”고 주장했으며, 그 근거로 AI 시스템이 수학, 생물학, 물리학 및 로봇공학 등 분야에서 자율적인 연구 역량을 보여왔다고 밝혔다. 인용된 데이터(예: TheoPhysEval 98% 점수, Humanity’s Last Exam 67.7%로 상승)는 모두 해당 인물과 관련 기관에서 제공한 것으로, 제3자의 검증은 이루어지지 않았다. 이 연설에서는 AI가 주도하는 과학 패러다임의 변화와 경제적 영향을 강조하면서, 동시에 이러한 판단은 주관적 입장에 불과하며 과학적 합의에 따른 것이 아니라고 명확히 밝혔다.

진행 상황 및 관련 보도