
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

문맥 내 의존성 파싱을 위한 POS 서명 시연 검색

arXiv:2610.31966v1 발표 유형: 신규 요약: 문맥 내 학습을 위한 시연은 종종 의미적 유사성을 기준으로 검색되며, 이는 구조화된 예측에서의 관련성을 제대로 대표하지 못할 수 있습니다. 우리는 Universal Dependencies 파싱을 위한 시연 선택 방식을 연구하며, 품사 통계를 가중치로 표현하고 라벨링된 교육 세트에서 길이가 호환되는 골드 라벨 해석 사례 3개를 검색하는 POS 서명 정책을 적용합니다. 우리는 미세조정 없이 두 개의 오픈 웨이트 언어 모델을 UD 영어 웹 트리뱅크 테스트 세트의 총 2,077개 문장에 대해 평가하며, 해당 정책을 샷 및 형식이 일치하는 고정 및 의미적 3샷 기반과 비교하고, 또한 제로샷, 사고 체인, 비평-정제 시스템과도 비교합니다. POS 서명 검색은 가장 높은 라벨링 성과를 달성합니다.

진행 상황 및 관련 보도

뮤온의 전처리는 언제, 어떻게 이루어지는가? 구조화된 기울기 노이즈의 역할

arXiv:2610.31728v1 발표 유형: 신규 초록: 뮤온은 대규모 언어 모델 학습에서 인기 있는 최적화 방법으로 자리잡았지만, 그 이론적 토대는 아직 잘 이해되지 않고 있다. 본 연구에서는 기울기 노이즈의 기하학적 특성이 뮤온의 전처리 효과를 어떻게 형성하는지 분석한다. 먼저, 고전적인 등방성 노이즈 가정 하에서는 뮤온이 학습률의 재조정 외에는 추가적인 가속 효과를 제공하지 않음을 이론적·실험적으로 보여준다. 이를 계기로 우리는 이질적인 작업 빈도를 갖는 연상 기억 시스템에서 미니배치 샘플링에 의해 발생하는 구조화된 노이즈를 탐구하기로 한다. 두 가지 작업에 대해 정확한 균형 임계점을 규명하고, 이를 다중 작업으로 확장하여 작업 커버리지와 기울기 신뢰성이 학습을 어떻게 공동으로 조절하는지 밝힌다. 우리의 분석에 따르면, 뮤온은 다음과 같은 효과를 완화할 수 있음을 보여준다.

When and How Does Muon Precondition? The Role of Structured Gradient Noise
진행 상황 및 관련 보도

추측적 디퓨전은 두 가지 절충의 이야기입니다

arXiv:2610.31819v1 발표 유형: 신규 초록: 추측적 디코딩은 더 빠르고 낮은 품질의 초안 모델로부터 샘플링을 수행함으로써 자동회귀형 대규모 언어 모델(LLM)의 추론 속도를 가속화하는 기법입니다. 전통적으로, 추측적 디코딩의 근본적인 특성은 검증자 분포에 대해 무손실이라는 점으로, 품질을 희생하지 않고 속도를 보장한다는 것입니다. 이는 최근 개발된 디퓨전 LLM(dLLM)과는 달리, 덜 많은 디퓨전 작업으로 출력의 품질을 저하시킴으로써 상당한 속도 향상을 달성할 수 있다는 점에서 차별됩니다. 디퓨전 모델은 토큰을 병렬로 생성하여 자동회귀 모델보다 더 빠르게 샘플링할 수 있기 때문에, 추측적 디퓨전에서 초안 모델로서 강력한 후보로 간주됩니다. 널리

진행 상황 및 관련 보도

DriveMind: 폐쇄 루프 자율주행을 위한 마음의 진화형 신념 추적

arXiv:2610.32069v1 발표 유형: 신규 초록: 최근 다중 모달 대규모 언어 모델(MLLM)은 단일 모델 내에서 교통 상황을 인지하고 이를 바탕으로 추론하며 주행 행동을 제안할 수 있습니다. 그러나 기존의 MLLM 기반 주행 시스템은 매 프레임마다 처음부터 다시 추론을 수행하고 단 하나의 설명에만 의존하여, 이전의 상황에 대한 여러 가설을 버리게 됩니다. 상황이 모호할 경우, 에이전트는 잘못된 해석에 고정되어 증거가 축적되기 전에 그에 따라 행동하게 됩니다. 본 논문에서는 DriveMind를 제안합니다. 이는 MLLM 기반 주행 프레임워크로, 상황에 대한 여러 가지 가설을 동시에 유지하면서 새로운 프레임이 도착할 때마다 각 가설의 가중치를 업데이트합니다. 입자 필터링에서 영감을 받은 DriveMind는 각 가설을 VLM을 통해 전파하고, 현재 관찰과 비교하여 점수를 매긴 뒤 재표본화하여 m

진행 상황 및 관련 보도

LLM의 분포적 정합성과 그 일반화 특성

arXiv:2610.31687v1 공지 유형: 신규 요약: 대규모 언어 모델은 설문조사와 같은 목적으로 인간 행동을 시뮬레이션하고 탐구하는 데 점점 더 많이 활용되고 있습니다. 이러한 응용에서 핵심적인 성질은 출력이 분포적 정합성을 만족한다는 점입니다. 즉, 모델의 출력 분포가 특정 기준(이 경우 인간) 분포와 일치해야 합니다. 분포적 정합성을 달성하는 데 있어 큰 장애물은 소규모 학습 데이터로부터의 일반화입니다. 본 연구에서는 (1) LLM을 어떻게 분포적으로 정합시킬 수 있는지, 그리고 (2) 정합된 LLM이 미처 보지 못한 샘플들 및 관련 없는 주제와 과제들로까지 어떻게 일반화될 수 있는지를 탐구합니다. 두 개의 대규모 벤치마크를 사용하여, LLM이 실제로 분포적 정합성을 달성할 수 있으며 동일한 도메인 내의 미처 보지 못한 질문들에 대해서도 일반화 가능하다는 사실을 확인했습니다. 주제 간 일반화는 각 주제 간의 관계에 따라 달라집니다(예:

진행 상황 및 관련 보도

LazyFlash: 가속화된 장문 컨텍스트 미세조정을 위한 전방 밀집·후방 희소 주의

arXiv:2610.31911v1 발표 유형: 신규 초록: 대규모 언어 모델(LLMs)이 점점 더 긴 시퀀스를 처리함에 따라, 주의 메커니즘은 주요 계산 병목으로 부각되고 있습니다. 희소 주의는 대부분 추론 단계에 초점을 맞추지만, 여전히 많은 방법들이 밀집형으로 학습되거나 희소 학습을 지원하지 못하며, 추가적인 복잡성으로 인해 희소성이 실제 월클럭 속도 향상으로 이어지기 어려워져 결국 실무에서는 밀집형 주의가 널리 사용되고 있습니다. 본 논문에서는 주의 학습이 후방 패스에 의해 주로 결정된다는 관찰에 기반한 전방 밀집·후방 희소 주의 방식인 LazyFlash를 제안합니다. LazyFlash는 전방 패스를 정확히 밀집형으로 유지하여, 학습된 모델이 vLLM과 같은 기존 시스템에서 아무런 변경 없이 서비스할 수 있는 표준 밀집형 모델로 남도록 합니다. 후방 패스에 대해서는 LazyFlash는 그라디언트-a를 제안합니다.

진행 상황 및 관련 보도

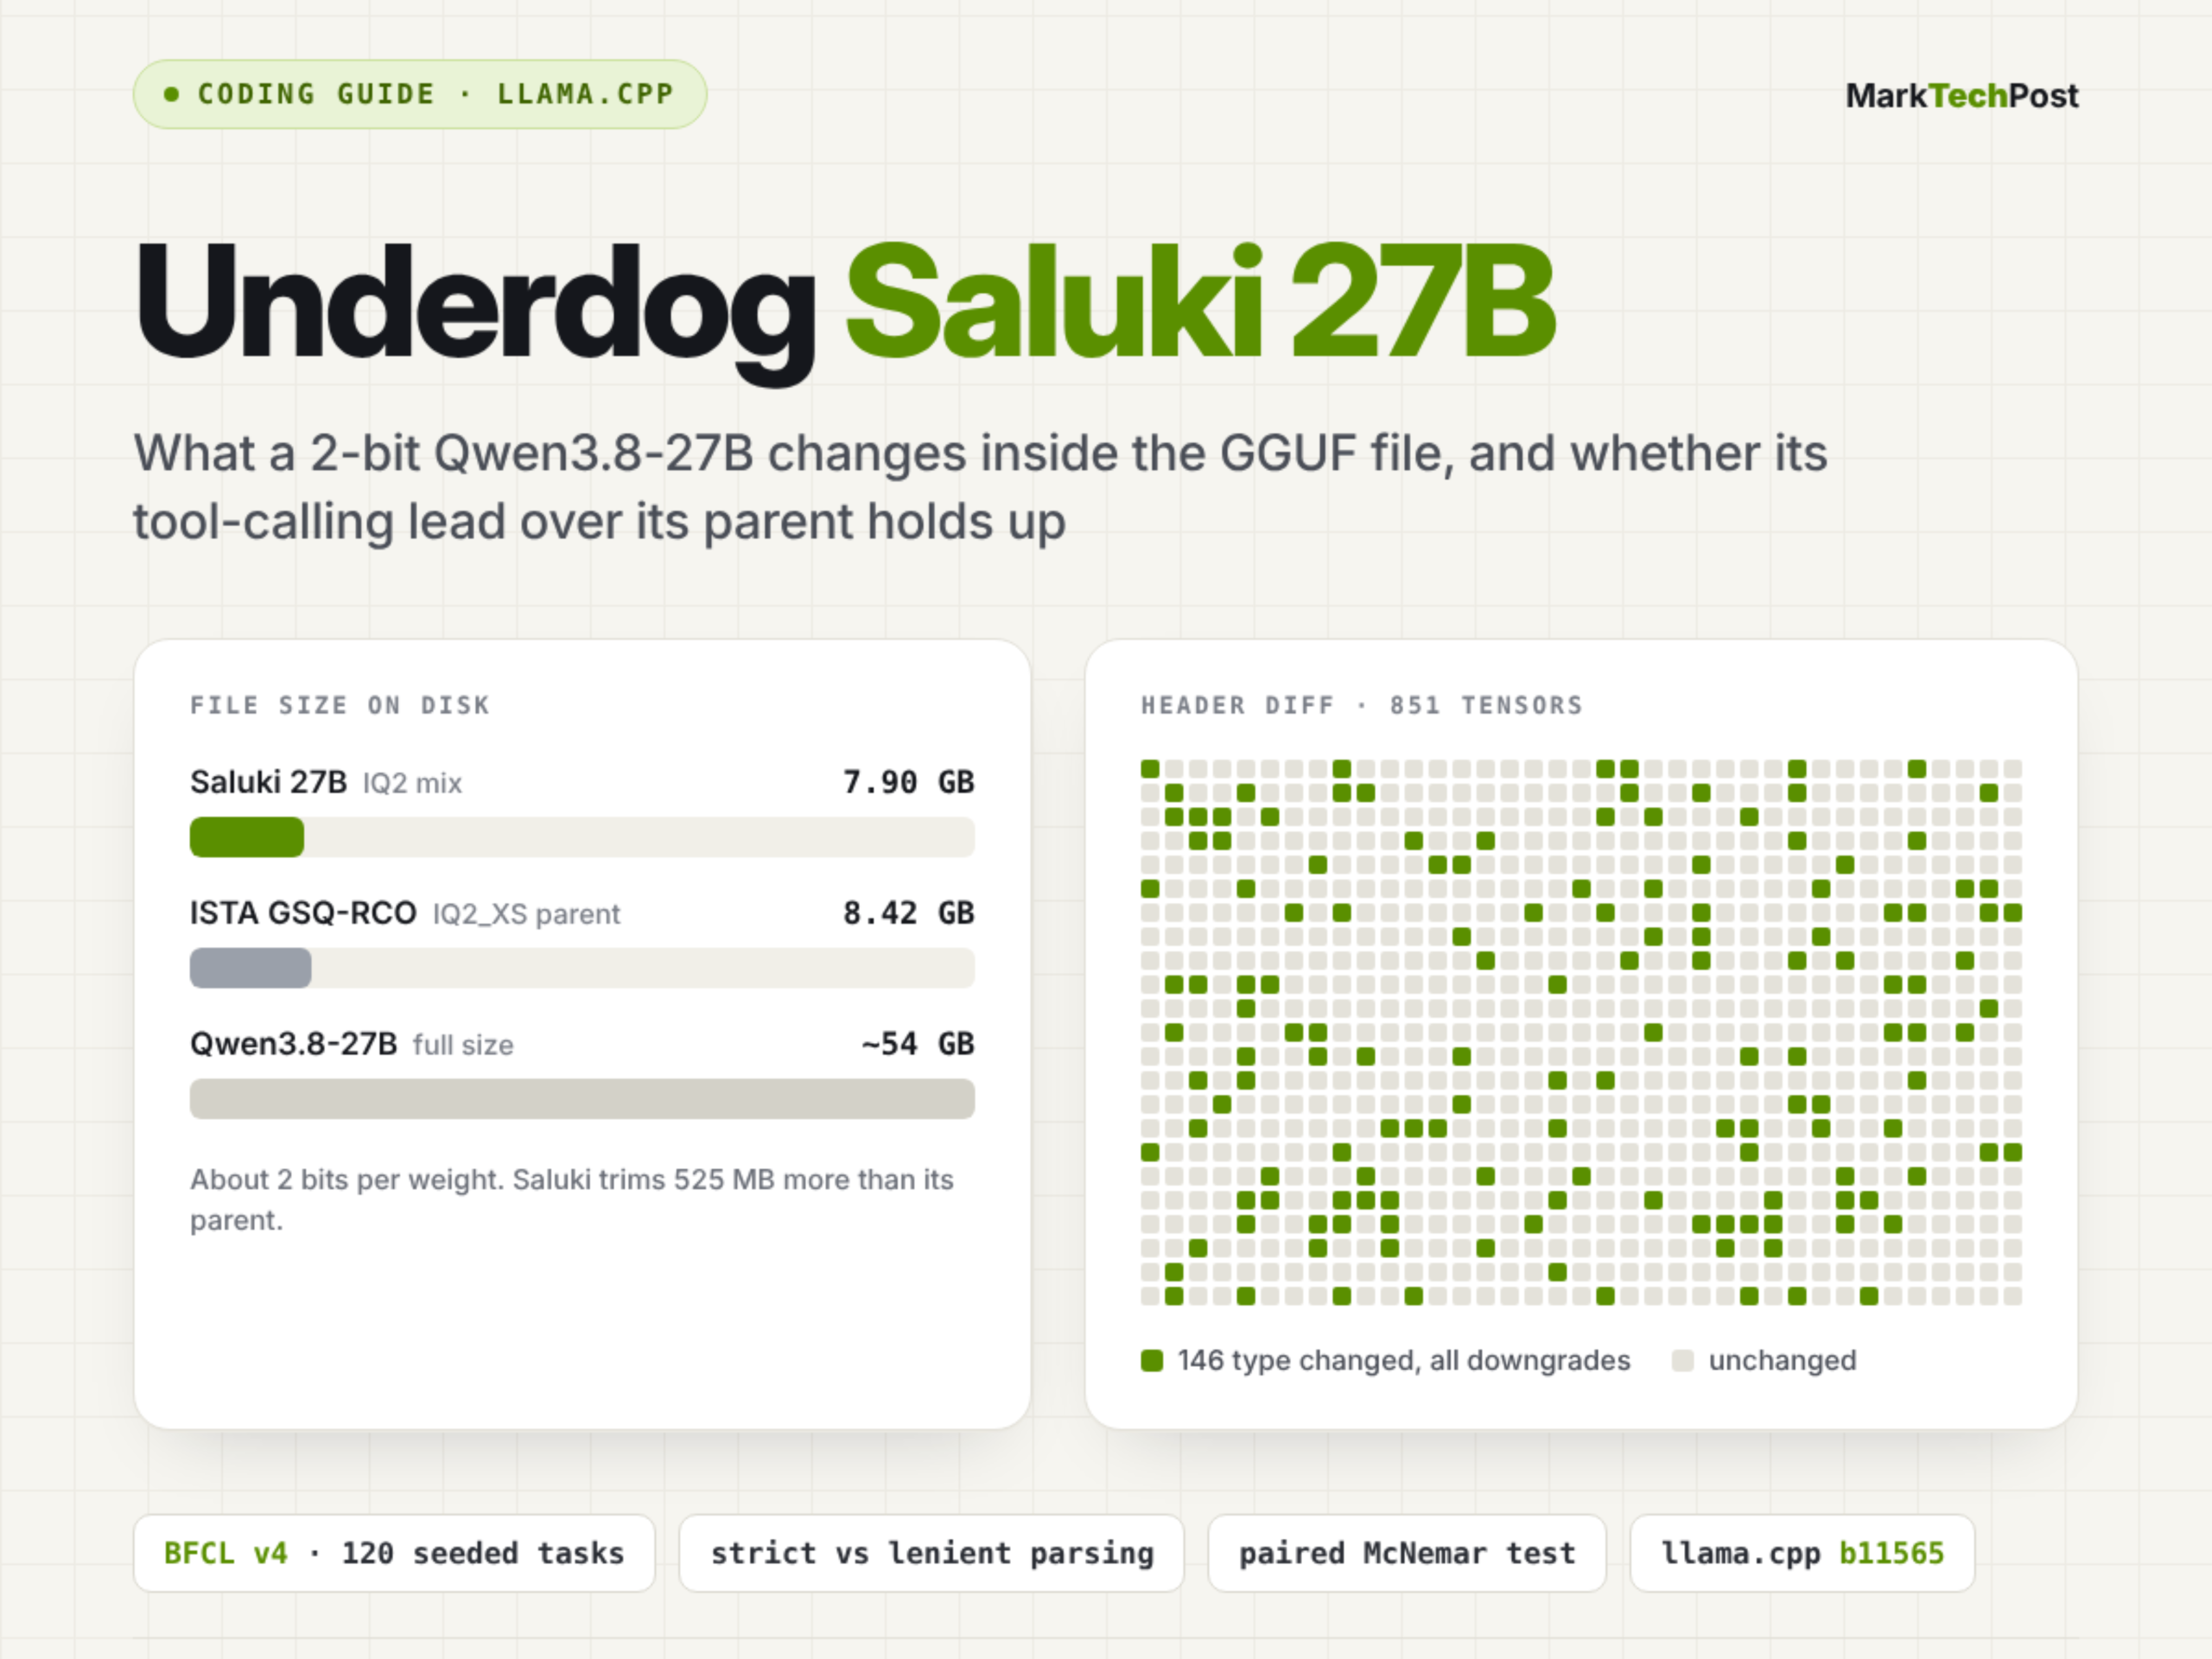
언더독 살루키 27B: GSQ-RCO 기반 2비트 Qwen3.8-27B 도구 호출 모델 기술 분석

이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
진행 상황 및 관련 보도

애플의 첫 번째 폴더블 iPhone 듀오가 판매 시작과 동시에 집중적인 화면 균열 문제가 발생했다.

여러 사용자가 애플의 첫 번째 폴더블 스마트폰인 iPhone Duo를 개봉한 직후, 힌지 바로 위쪽 화면에서 금이 가거나 파손되는 문제가 짧은 시간 내에 발생했다고 보고했으며, 해당 결함이 매우 집중적으로 나타나고 있습니다. 호주와 중국에서도 유사 사례가 보고되어, 이는 힌지 조립 시 공차 문제로 인한 것으로 추정됩니다. 애플 측은 아직 공식 입장을 밝히지 않았으며, AS 처리 결과에 따라 무상 교체 여부 또는 고액의 자비 수리 여부가 결정될 예정입니다.

추천 이유:이 사건은 신형 제품의 대규모 초기 품질 이상과 관련되어 있어 소비자의 권익과 기업의 책임 경계를 정면으로 부딪히고 있으며, 여기에 3包 규정의 적용 여부와 AppleCare+ 서비스의 정체성 등 공공적 쟁점까지 겹쳐 전형적인 경고적 의미와 권리 보호의 참고 가치를 지니고 있다.

진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

연구는 LLM이 생성한 합성 설문조사 응답자 커버리지를 평가하는 새로운 지표 RCG를 제안했다.

이 논문은 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30900v1), 대규모 언어 모델(LLM)이 생성한 합성 설문 응답자가 실제 인간 응답자를 완전한 응답 프로파일 공간에서 얼마나 잘 포괄하는지를 측정하기 위한 새로운 평가 지표인 ‘응답자 포괄 격차’(RCG)를 제안한다.

Silicon Samples Match the Answers but Not the Respondents

추천 이유:기존 평가 방법은 단일 문항의 정답 분포나 문항 간 상관성에만 주목할 뿐, LLM이 생성한 응답자가 실제 모집단에서 실제로 존재하는 정답 조합을 재현했는지 여부를 식별할 수 없다. RCG는 최초로 전체 응답 프로파일을 기반으로 커버리지 격차를 정량화하였으며, 두 가지 미국 사회조사 데이터를 통해 모든 테스트 대상 LLM에서 유의미한 미커버리지 인구가 존재하고, 이들이 단순한 변동성 표본 추출 기준선 및 가우스 코플라 모델보다 성능이 저조함을 실증적으로 확인했다.

진행 상황 및 관련 보도

새로운 연구에서 ReflectPO 프레임워크를 제안하여, 대규모 언어 모델 에이전트의 장기적 작업에서의 자율적 오류 수정 능력을 향상시켰다.

2026년 10월 24일, arXiv는 “ReflectPO: 장기 주기 LLM 에이전트를 위한 반성 유도 전략 최적화”라는 제목의 연구 논문(번호 2610.30933v1)을 발표했으며, 복잡하고 다단계이며 상태에 의존하는 작업에서 도구 기반 대규모 언어 모델 에이전트의 자율적 오류 복구 능력을 강화하기 위해 ReflectPO라는 강화학습 프레임워크를 제안했습니다.

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

추천 이유:이 논문은 최근 발표된 최첨단 AI 연구로, 현재 LLM 에이전트의 실용화에서 핵심적인 한계인 장기 작업에서 발생하는 초기 오류의 누적 효과에 초점을 맞추고 있다. 본 연구에서 제안한 Reflection-Guided Sampling과 Tree-Structured Credit Assignment의 이중 구성 설계는 방법론적 혁신성을 갖추고 있으며, 두 가지 도구 사용 벤치마크에서 여러 기준선을 상회하는 실증적 성과를 보여 기술적 참고 가치를 지닌다.

진행 상황 및 관련 보도

아마존 세이지메이커 AI가 다중 라운드 강화학습(MTRL) 프레임워크를 출시하여, 엔드투엔드 방식으로 에이전트가 다단계 작업을 완수하도록 지원합니다.

AWS는 Multi-Turn Reinforcement Learning(MTRL) 기능을 출시하여, 사용자가 SageMaker AI에서 전체 작업 궤적과 최종 결과 피드백을 바탕으로 대규모 모델 에이전트를 단계별 주석 없이 학습할 수 있도록 지원합니다. Wordle을 예시로 삼아 AgentCore 배포, 데이터 준비, GRPO 학습, 보상 설계 및 비용 분석에 이르는 전 과정을 시연합니다.

진행 상황 및 관련 보도

AWS CDK는 재사용 가능한 구성 요소를 구축하여 SageMaker 엔드포인트의 확장·축소 및 업데이트 시 발생하는 블로킹 문제를 해결합니다.

SageMaker 실시간 AI 엔드포인트가 Application Auto Scaling에 등록된 상태에서는 AWS CDK 또는 CloudFormation을 통해 인스턴스 유형 및 수량과 같은 구성 설정을 직접 업데이트하려고 하면 실패합니다. 본 문서에서는 사용자 정의 리소스 기반의 CDK 구성 방식을 제안하며, 엄격한 의존성 오케스트레이션을 통해 엔드포인트 구성과 확장/축소 전략을 원자적 단위로 처리하고, 수동 업데이트를 필요 없도록 구현합니다.

진행 상황 및 관련 보도

OpenAI가 Decisions API 의사결정 모델을 정식으로 출시하며, TypeSafe Jev와의 경쟁에 본격적으로 나섰다.

OpenAI는 2026년 10월 22일을 전후하여 모든 고객에게 Decisions API를 개방할 예정이며, 이 모델은 ChatGPT Luna를 기반으로 재구성되어 밀리초 수준의 낮은 지연 시간과 저비용 추론을 강조하며, 이미지 이해 등 다중 모달 작업에서 우위를 보입니다. 현재 주요 의사결정 모델 벤치마크에서는 최신 Jev 및 D1 Ultra와 같은 경쟁 제품에 비해 순위가 뒤처져 있지만, Box, Datadog, Speak 등 여러 기업에서 실사용 사례로 채택된 바 있습니다.

진행 상황 및 관련 보도

아마존 세이지메이커가 학습 세션 API를 출시했습니다: 사용자는 GPU를 관리할 필요 없이 맞춤형 대규모 모델 학습 루프를 작성할 수 있습니다.

아마존 세이지메이커는 트레이닝 세션(Training Sessions) API를 출시하여, 사용자가 순수 파이썬 스크립트로 SFT, RLHF, GRPO, KTO 등과 같은 맞춤형 대규모 모델 훈련 로직을 구현할 수 있도록 지원합니다. GPU 리소스 스케줄링, 장애 복구, 분산 실행 및 체크포인트 관리는 모두 서비스에서 관리합니다.

진행 상황 및 관련 보도

클라우드 배포 예정: ‘콜 오브 듀티: 모던 워페어 4’가 GeForce NOW에 출시됩니다

이번 목요일, GFN에서 바로 플레이해 보세요. 콜 오브 듀티: 모던 워페어 4가 출시와 동시에 GeForce NOW에 도착하며, 새로운 캠페인, 멀티플레이어 액션, 그리고 DMZ라는 고스택 추출 모드를 지원 기기로 제공합니다. 또한 캠페인의 그래픽 품질도 한층 업그레이드되었습니다: 얼티밋 회원에게는 지포스 RTX 5080급 성능이 제공되어, […]에서 레이 트레이싱 기능을 지원합니다.

진행 상황 및 관련 보도

파나슈 — 모바일용 벨 에포크 RTS

파나슈 — 모바일용 벨 에포크 RTS 참으로 기분 좋은 일이네요: 저는 어제 Apache 2.0 라이선스 하에 ‘배틀 드론스’를 출시했는데, 이미 프랑스어 버전 포크가 나와서 게임의 배경을 스팀펑크풍의 1900년대 프랑스로 바꾸고 애니메이션 인트로까지 추가했습니다! 파나슈는 모바일과 웹브라우저에서 즐길 수 있는 벨 에포크 시대(약 1900년경)의 프랑스를 배경으로 한 실시간 전략 게임입니다. 비행선, 증기식 장갑차, 크뢰조 장갑함, 투구를 쓴 자동인형, 그리고 이동하는 요새 ‘가르강튀아’ 등, 화려한 볼거리가 가득합니다. 여기에서 파나슈를 플레이해 보실 수 있습니다—새로운 인트로 영상을 직접 확인해 보시려면 링크를 클릭해 보시는 것도 좋습니다. 현재까지는 게임플레이 변경보다는 주로 미적 요소 위주의 업데이트에 그치고 있습니다. 음악에도 프랑스 특유의 감성이 더해졌고요. 새로운 스팀펑크 스타일의 모델들은 정말 멋집니다! 여기에는 해당 페이지가 있습니다.

진행 상황 및 관련 보도

Tenex의 AI 네이티브 SDLC 구축: 포춘 2000대 기업을 위한 에이전트 기반 개발 실무

설립 18개월 된 AI 원생 소프트웨어 기업 Tenex는 출력 지향 보수, MetaHarness 프레임워크 및 Opus 5.5를 기반으로 한 AI 에이전트 워크플로우를 통해 포춘 2000대 기업의 약 절반을 고객으로 두고 있습니다. 이 회사의 모델은 프로세스 표준화, 비코딩 방식의 가치 재평가, 그리고 기업 수준의 AI 도입에서 발생하는 ‘마지막 1마일’ 문제 해결에 중점을 두고 있습니다.

진행 상황 및 관련 보도

Tenex, AI 네이티브 SDLC 구축: 결과 기반 지불, 에이전트 기반 개발 및 엔터프라이즈 AI 도입의 마지막 1마일

Tenex는 설립 18개월(2026년 기준)이며 직원 수 75명 규모의 AI 원생 소프트웨어 제공 기업으로, 포춘 2000대 기업의 약 절반과 이에 상응하는 중견기업을 고객으로 두고 있습니다. 주요 실천 사례로는 스토리 포인트를 기반으로 한 동적 엔지니어 보상 체계, AI 전략가의 품질 검증 메커니즘, Git 내부에 통합된 컨텍스트 기반 MetaHarness 프레임워크, 그리고 ‘비코딩 고부가가치 작업’에 집중하는 역량 재정립이 포함됩니다. 한편, 기업의 AI 도입은 여전히 범용 LLM 배포와 엔지니어링 측 에이전트 중심으로 집중되어 있으며, 백엔드 오피스 계열의 생산용 AI 에이전트 침투율은 약 5%에 불과한 것으로 파악됩니다.

진행 상황 및 관련 보도

TorchNeuron 시스템 수준 성능 분석(제1부): AWS Trainium 칩 기반 엔드투엔드 프로파일링

이 글은 Hugging Face와 Amazon이 공동으로 발표한 기술 블로그 시리즈의 첫 번째 편으로, AWS Trainium AI 가속 칩에서 TorchNeuron을 활용한 PyTorch 모델 추론 성능 분석 방법을 체계적으로 소개합니다. 여기에는 Neuron 백엔드 통합 원리, torch.profiler 구성 방법, NeuronConfig 및 NeuronProfiler 도구의 사용법, Neuron Explorer를 이용한 시각적 추적 등이 포함되며, RMSNorm을 사례로 삼아 세 가지 구현 방식(순수 PyTorch, torch.rms_norm 내장형 병합, torch.compile 자동 병합) 간의 장치별 처리 시간 차이를 비교합니다.

진행 상황 및 관련 보도