
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

b12007

kv-cache : GPU에서 회전 상수를 유지 (#31073) * kv-cache : GPU에서 회전 상수를 유지 도움말: Codex * tests : 상주하는 KV 회전 버퍼 검증 도움말: Codex * kv-cache : 남아 있는 다중 디바이스 회전 작업 문서화 도움말: Codex * kv-cache : 레이어별 회전 버퍼 지원 도움말: Codex * kv-cache : 하이브리드 SWA 회전 입력 및 혼합 배치 확인 수정 도움말: Codex * models : mistral-large4와 dflash에서 레이어별 회전 사용 * tests: 회전 버퍼 테스트 삭제 --------- 공동 작성자: Pascal **웹사이트:** - **인증서:** - **macOS/iOS:** - [macOS 애플 실리콘(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12007/llama-b12007-bin-macos-arm64.tar.gz) - macOS 애플 실리콘(arm64, KleidiAI 활성화) [비활성화](ht

진행 상황 및 관련 보도

b12005

opencl: q2_0 초기 지원 추가 (#31340) * opencl: q2_0 AOS 이동 추가 공동 작성자: Shaofei Qi 보조 작성자: Codex * opencl: q2_0 SOA 이동 및 타일링된 mm 추가 공동 작성자: Shaofei Qi 보조 작성자: Codex * opencl: adreno용 q2_0 noshuffle gemm/gemv 추가 보조 작성자: Codex * opencl: adreno용 q2_0 dp4a 추가 * opencl: adreno의 q2_0 디코딩 및 좁은 배치 최적화 --------- 공동 작성자: Li He **웹사이트:** - **인증서:** - **macOS/iOS:** - [macOS 애플 실리콘(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12005/llama-b12005-bin-macos-arm64.tar.gz) - macOS 애플 실리콘(arm64, KleidiAI 활성화) [비활성화](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS 인텔(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12005/llama-b12005-bin-macos-x64.tar.g

진행 상황 및 관련 보도

b12002

ggml : 배치된 텐서 복사 API 추가 (#30881) * ggml : 범용 배치된 텐서 복사 API 추가 지원자: pi:llama.cpp/ggml-org/DeepSeek-V4-Flash-Vision-Exp-GGUF (Mac Studio, M2 Ultra, 192GB) * llama : 컨텍스트 I/O에서 배치된 텐서 복사 API 사용 지원자: pi:llama.cpp/ggml-org/DeepSeek-V4-Flash-Vision-Exp-GGUF (Mac Studio, M2 Ultra, 192GB) * ggml : 배치된 텐서 API에 CUDA 지원 추가 지원자: pi:llama.cpp/ggml-org/DeepSeek-V4-Flash-Vision-Exp-GGUF (Mac Studio, M2 Ultra, 192GB) * ggml : 비동기 텐서_n API 제거 a

진행 상황 및 관련 보도

FlatCake: LLM 서비스를 위한 평면형 KV캐시 저장 아키텍처

arXiv:2610.38355v1 발표 유형: 신규 초록: KV 캐시 재사용은 LLM 서비스를 가속화하지만, 기존 시스템들은 호스트 DRAM과 NVMe SSD를 계층적 하위 구조로 관리하며, DRAM을 중간 캐시로 활용합니다. 그러나 실제 생산 환경의 LLM 워크로드는 이러한 계층 구조의 두 가지 전제 조건을 모두 무너뜨립니다. 첫째, 이중 모드 재사용 방식은 DRAM의 시간적 필터링 기능을 무력화합니다. 왜냐하면 워크로드는 재사용 거리가 긴 일회성 블록이나 DRAM 용량을 초과하는 수기가바이트 규모의 에이전트 세션으로 구성되어 있어 SSD가 핵심 읽기 경로에 위치하게 되기 때문입니다. 둘째, DRAM의 스테이징과 제거 순서에 따른 배치 방식은 SSD 복원 과정을 병목으로 만듭니다. 인-플라이트 프리픽스를 위해 호스트 스테이징 버퍼를 유지하면 부하 상황에서 컨텐션을 유발해 프리페치 작업이 중단되며, 증분식 제거는 세션의 블록들을 SSD 전체에 분산시켜 대규모 연속 읽기를 방해합니다. 우리는 p

진행 상황 및 관련 보도

b11982

hexagon: UPSCALE 연산 지원 (#31331) * hex-upscale: 기본 업스케일 연산(완전히 벡터화되지 않음) * hex-upscale: 가장 가까운 2배, 4배 및 이방성 4배 업스케일 최적화 * hex-upscale: 연속적이지 않은 행과 차원 축소 기능 추가 * hex-upscale: 스칼라 스테이징 대신 vgather 사용 * hex-upscale: 모든 커널 선택 로직을 호스트로 이전하고, 주석 검토 및 정리 작업 수행 * 테스트: qwen3-vl 이미지→텍스트 시나리오를 포괄하는 순열된 UPSCALE 테스트 추가 **웹사이트:** - **인증서:** - **macOS/iOS:** - [macOS 애플 실리콘(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11982/llama-b11982-bin-macos-arm64.tar.gz) - macOS 애플 실리콘(arm64, KleidiAI 활성화) [비활성화](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS 인텔(x64)](https://github.com/ggml-org/llama.cpp/releases/downloa

진행 상황 및 관련 보도

인피니-AI-랩, AI 에이전트를 위한 오픈소스 하네스 어댑터 프레임워크 ‘허밋’ 출시

인피니-AI-랩은 작업 피드백을 기반으로 외부 계층의 명령, 기술, 메모리 및 도구를 학습시키는 아파치 2.0 라이선스의 하네스 어댑터 프레임워크 ‘허밋’을 공개했습니다. 이 글은 ‘인피니-AI-랩, AI 에이전트를 위한 오픈소스 하네스 어댑터 프레임워크 ‘허밋’ 출시’라는 제목으로 MarkTechPost에 처음 게재되었습니다.

진행 상황 및 관련 보도

b11980

[SYCL] 정량화된 KV 캐시를 위한 DPAS 플래시 어텐션 커널 추가 (#31125) * sycl : 정량화된 KV 캐시를 위한 DPAS 플래시 어텐션 커널 추가 디코딩 및 소규모 배치(쿼리 토큰 1~31개)는 이제 매 호출마다 전체 캐시를 f16으로 변환하거나 스칼라 디퀀터화하는 대신, q4_0 및 q8_0 KV 블록에서 직접 플래시 어텐션을 수행합니다. Q.K는 XMX에서 s8 x s4와 s8 x s8 DPAS를 사용하며, V.P는 f16으로 유지됩니다. dpas.s4.s8은 joint_matrix에 s4가 없기 때문에 인라인 vISA로 처리됩니다. 헤드 크기 64부터 512까지, GQA 최대 32 및 어텐션 싱크를 지원합니다. 프롬프트는 기존 커널에서 그대로 작동합니다. GGML_SYCL_FA_DPAS=0으로 설정하면 이 기능이 비활성화됩니다. B580, Llama 3.1 8B Q4_K_M, q4_0 KV, tg128: 16K 컨텍스트에서 31.3~54.2 t/s의 성능을 보입니다. FLASH_ATTN_EXT 4582/4584, 마스터와 동일한 2건의 실패 사례가 있습니다. 협조자: Claude * sycl : 헤드 수가 192개로 감소했으며, 문서에 Wildcat Lake가 추가되었습니다. 협조자: Claude * sycl : str

진행 상황 및 관련 보도

접두사 키와 값의 중요성은 늦게 드러난다: 루프형 언어 모델에서 자기-추론적 디코딩을 위한 RIPE 캐싱

arXiv:2610.34436v1 발표 유형: 신규 초록: 루프형 언어 모델은 토큰당 레이어 블록을 $R$번 실행하므로, 해당 모델의 키-값(KV) 캐시는 각 반복 레이어마다 $R$개의 평면을 저장하며, 자기-투기적 디코딩(몇 개의 루프로 초안을 생성하고 $R$개 모두로 검증)에서는 이 모든 평면을 읽어들입니다. 우리는 접두사 키와 값이 후반부에서 중요한 역할을 한다는 점을 발견했습니다. 동일한 섭동 크기에서도, 루프 25~32는 루프 2~9에 비해 $e^{15.0}$(Huginn-0125) 및 $e^{12.8}$(Raven-Llama) 배 더 민감하며, 각 루프마다 평면들은 기하급수적으로 마지막 평면에 접근하여, 각각 0.88과 0.81에 도달합니다. 이때 가장 깊은 평면 하나만으로 충분한지 여부는 후반부 평면들이 얼마나 성숙했는지에 따라 달라집니다. Raven에서는 이를 저장하는 것만으로도 bf16에서 fp32로 변경한 경우와 구별되지 않으며, Huginn에서는 전체 오차의 74%를 단 1%의 위치가 차지합니다. 우리는 이를 RIPE로 발전시켰으며, RIPE는 가장 깊은

진행 상황 및 관련 보도

오픈 ISA 슈퍼컴퓨팅을 향하여: HPC 워크로드에 대한 RISC-V, Arm, x86 아키텍처 비교 연구

arXiv:2610.32632v1 발표 유형: 신규 초록: RISC-V는 고성능 컴퓨팅(HPC)의 후보 아키텍처로 부상하고 있지만, 기존의 x86 및 Arm 프로세서와의 경쟁력은 아직 평가하기 어렵습니다. 이는 기존 연구들이 서로 다른 플랫폼, 워크로드, 방법론을 사용하고 있으며, 에너지 효율성을 거의 고려하지 않기 때문입니다. 본 연구에서는 공통된 소프트웨어 스택과 방법론을 활용하여 최신 HPC용 RISC-V, Arm, x86 프로세서를 평가합니다. 우리는 Sophgo SG2044를 특성화하고, NVIDIA Grace CPU 슈퍼칩 및 Intel Xeon Platinum 8480+와 함께 STREAM, HPL, HPL-MxP, HPCG 등 네 가지 HPC 벤치마크와 iPIC3D, PLUTO, OpenFOAM, llama.cpp 등 네 가지 대표 애플리케이션에서 비교 분석을 수행했습니다. 본 연구에서 사용된 OpenBLAS 기반 HPL-MxP 버전은

Toward Open ISA Supercomputing: A Comparative Study of RISC-V, Arm, and x86 Architectures on HPC Workloads
진행 상황 및 관련 보도

arXiv의 새로운 논문은 증거 검증과 가중치 업데이트가 필요 없는 프롬프트 수정을 지원하는, 추적 가능한 다모달 감정 추론 에이전트 프레임워크를 제안합니다.

2026년 10월 26일, arXiv는 사전인쇄 논문(번호 2610.31685v1)을 발표하며, 동결된 대규모 모델 기반의 추적 가능한 다중모달 감정 추론 지능체 아키텍처를 제안했습니다. 이 아키텍처는 모달별 전용 인지 지능체, 통합 지능체, MLLM 비판자 및 증거 검증 단계를 통해 오류 귀속과 프롬프트 공간의 자율적 최적화를 구현하며, MER2025 데이터셋에서 여러 개방형 다중모달 대규모 모델(2B–38B 파라미터)의 감정 인식 F-스코어를 0.6~2.2점 향상시켰습니다.

An Agentic Approach with Evidence-Grounded Verification for Multimodal Emotion Reasoning in Conversation

추천 이유:이 연구는 현재 다중 모달 감정 추론 시스템에서 명령 미세조정 비용의 높음과 에이전트 파이프라인의 디버깅 불가능성 간의 모순을 해결하기 위해, 증거 인용, 확실성 검증, 실패 귀인 및 타깃형 프롬프트 수정을 통합한 최초의 전 과정 설명 가능한 프레임워크를 제안한다. 모든 개선 사항은 모델 가중치를 변경하지 않으며, 네 가지 서로 다른 규모의 오픈소스 MLLM에서 실증적으로 효과를 입증하여 방법론적 혁신성과 공학적 실용성을 갖추고 있다.

진행 상황 및 관련 보도

엣지 기반 LLM 훈련의 민주화: 도전 과제, 시스템 및 앞으로의 방향

arXiv:2610.32215v1 발표 유형: 신규 초록: 현대 GPU 데이터 센터의 컴퓨팅 파워 증가로 인해 일부 산업 거대 기업들이 대규모 데이터를 활용하여 대형 언어 모델(LLM)을 훈련하고 배포할 수 있게 되었습니다. 그러나 이러한 모델과 그 학습 데이터의 엄청난 규모는 중앙 집중식 개발을 점점 더 지속하기 어렵게 만들고 있으며, 동시에 관련된 개인 데이터를 보유하되 이에 상응하는 인프라를 갖추지 못한 소규모 기관들을 배제하고 있습니다. 본 논문에서는 분산형 LLM 훈련에 관한 우리의 입장을 사전 학습 및 미세 조정 패러다임을 중심으로 정리하고, 연합 학습, 분할 학습 및 탈중앙화 접근법을 다루며, 이들 방법이 이질적인 하드웨어와 신뢰성 낮은 연결성을 가진 지리적으로 분산된 환경에서 어느 정도 준비되어 있는지 평가합니다. 이어서 우리는 {\em 통합}된 시스템을 제시합니다

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
진행 상황 및 관련 보도

llama.cpp가 b11871 버전을 출시했습니다: 서비스 크래시를 방지하기 위해 JSON 중첩 깊이 제한을 추가했습니다.

llama.cpp의 b11871 버전에서는 핵심 보안 수정 사항을 도입하여, 요청에 포함된 JSON 중첩 레벨에 대해 128레벨의 강제 제한을 적용함으로써, 깊은 재귀 파싱으로 인한 HTTP 스레드 스택 오버플로와 서비스 크래시를 방지합니다(맥OS에서는 SIGBUS, 리눅스에서는 SIGSEGV가 발생). 이 정책은 챗 인터페이스의 다양한 입력 시나리오를 포괄하며, 모든 경우에 HTTP 400 오류를 일관되게 반환합니다.

진행 상황 및 관련 보도

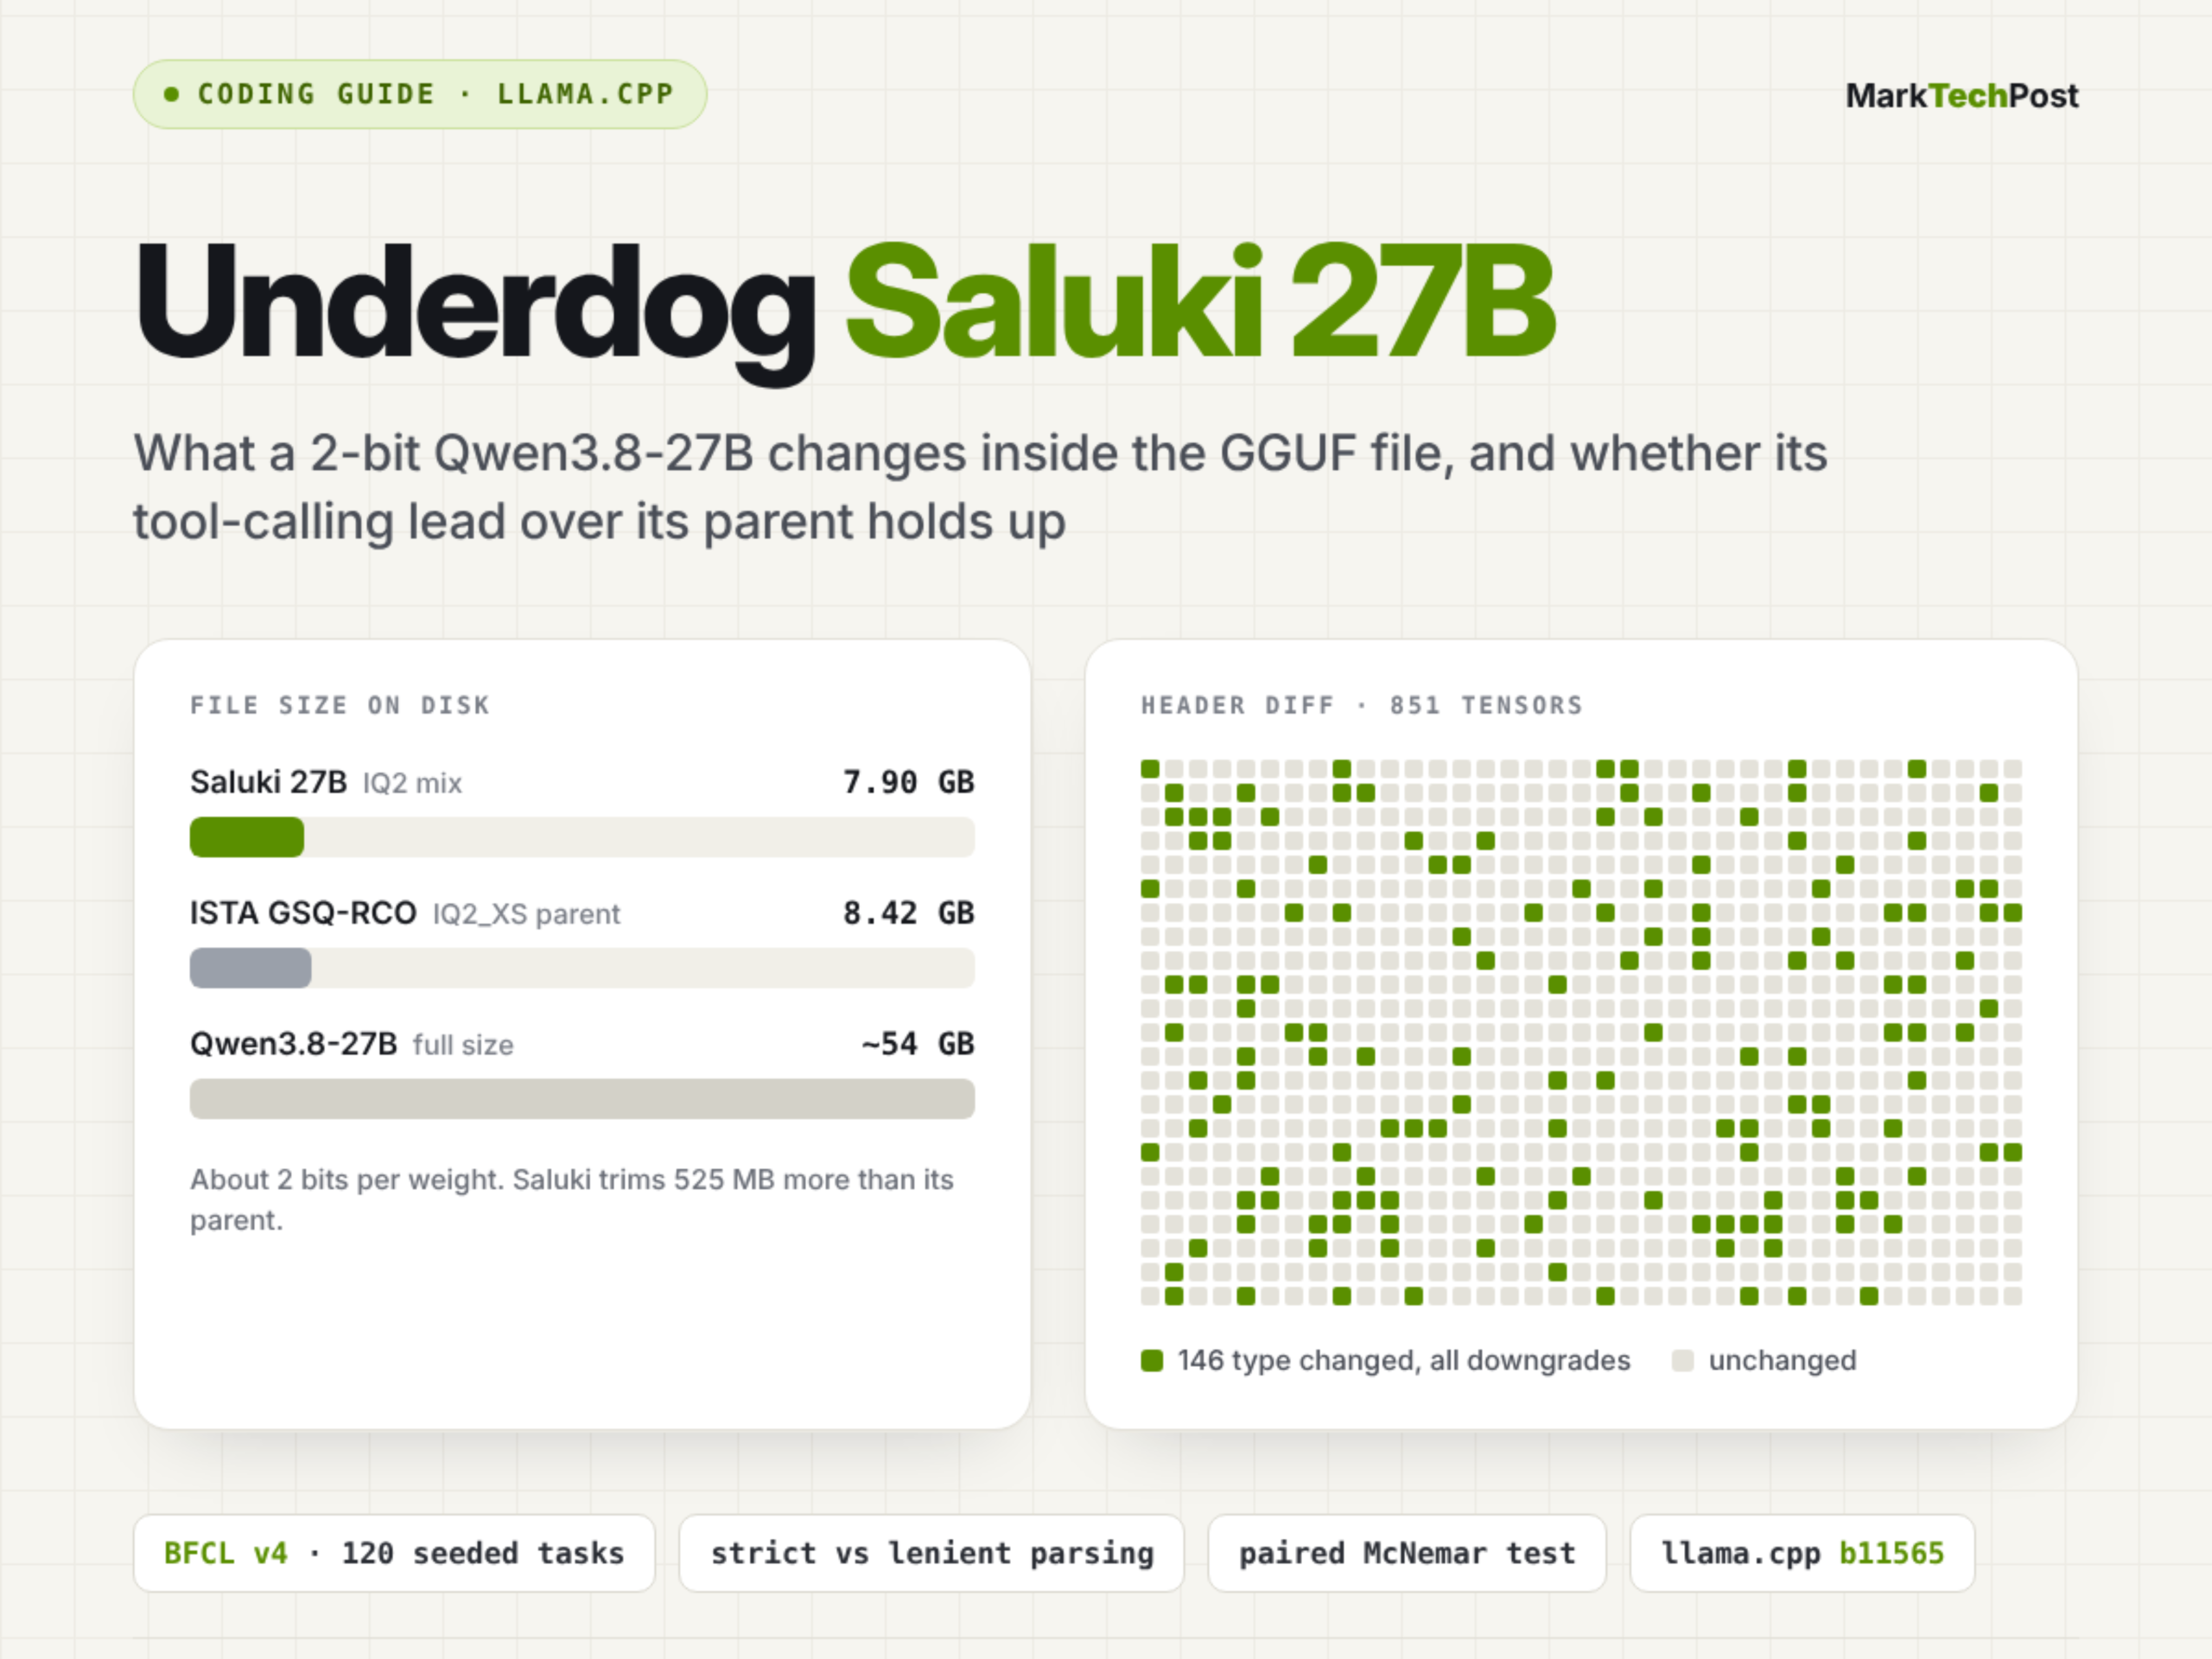
언더독 살루키 27B: GSQ-RCO 기반 2비트 Qwen3.8-27B 도구 호출 모델 기술 분석

이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
진행 상황 및 관련 보도

llama.cpp가 b11870 버전을 출시하여 DeepSeek-V4.1-Flash 모델을 정식으로 지원합니다.

llama.cpp는 버전 b11870에서 DeepSeek-V4.1-Flash(deepseek41) 모델을 지원하며, Engram 아키텍처를 기반으로 KV 캐시 계산 간소화, BF16 정밀도를 MXFP8로 대체, 인그래프 내 행 수집 등 여러 하위 수준 최적화를 수행했습니다. 또한 macOS, Linux, Windows, Android, iOS 및 openEuler를 포괄하는 다중 플랫폼 바이너리 빌드를 동시에 제공합니다.

진행 상황 및 관련 보도

llama.cpp가 b11869 버전을 출시했습니다: Jinja 템플릿 함수의 매개변수 처리를 수정하고, 다중 플랫폼 바이너리 지원을 추가했습니다.

llama.cpp 프로젝트는 빌드 버전 b11869를 출시했으며, 주요 수정 사항으로 Jinja 템플릿의 select 및 selectattr 함수에서 인수 해석 로직을 개선했고, macOS, Linux, Windows, Android, iOS 및 openEuler 등 수십 가지 하드웨어와 백엔드 조합에 대한 미리 컴파일된 바이너리 패키지를 제공합니다.

진행 상황 및 관련 보도

llama.cpp가 b11868 버전을 출시했습니다: Hexagon NPU의 멀티코어 플래시 어텐션 지원을 강화하여 전 플랫폼 컴파일 및 빌드를 지원합니다.

llama.cpp v2.45.0(태그 b11868)이 정식으로 출시되었으며, 핵심 업데이트로는 Hexagon 백엔드에 KV-head 분할 메커니즘을 도입하여 다중 코어 HMX Flash Attention의 성능을 최적화하고, FA 분할 제어 플래그를 통일했습니다. 동시에 macOS, Linux, Windows, Android, iOS 및 openEuler 등 모든 플랫폼용 바이너리 패키지를 제공하며, CUDA 12/13, Vulkan, ROCm, OpenVINO, SYCL, Snapdragon(Adreno+Hexagon) 등 다양한 백엔드 지원을 포함합니다.

진행 상황 및 관련 보도

llama.cpp가 b11867 버전을 출시했습니다: 서버 측 엔트리포인트가 재구성되었으며, 다중 플랫폼과 이기종 가속 백엔드를 전면 지원합니다.

llama.cpp가 GitHub에서 b11867 버전을 공식 출시했으며, 핵심 변경 사항으로는 서버 측 엔트리포인트의 재구성(PR #31113)과 server_role 메커니즘의 추가가 포함됩니다. 또한 macOS, Linux, Windows, Android, iOS 및 openEuler를 지원하는 40여 개의 사전 컴파일된 바이너리 패키지를 제공하며, CPU, CUDA(12.4/12.8/13.4), Vulkan, ROCm 10.0, OpenVINO, SYCL(FP16/FP32), Snapdragon(Adreno+Hexagon) 등 다양한 하드웨어 백엔드를 지원합니다.

진행 상황 및 관련 보도

llama.cpp가 b11866 버전을 출시했습니다: Metal 백엔드의 중복 AMAX 스케일링 로직을 제거하고, MoE 계산 경로를 간소화했습니다.

llama.cpp v.b11866 버전에서는 Metal 백엔드에 존재하던 구식 src1의 2의 거듭제곱 형태 AMAX 스케일링 메커니즘을 제거하고, 대신 계산 그래프 내에서 전문가 토큰별로 보다 세밀한 amax 스케일링을 적용하여 MoE 하에서 프로젝션 활성화 값이 f16 표현 범위 내에 유지되도록 보장합니다. 동시에 관련된 이단계 축약 핵심 함수, F32 정밀도 스케줄링 및 경계 위반 테스트 케이스도 함께 삭제되었습니다.

진행 상황 및 관련 보도