
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

엣지 기반 LLM 훈련의 민주화: 도전 과제, 시스템 및 앞으로의 방향

arXiv:2610.32215v1 발표 유형: 신규 초록: 현대 GPU 데이터 센터의 컴퓨팅 파워 증가로 인해 일부 산업 거대 기업들이 대규모 데이터를 활용하여 대형 언어 모델(LLM)을 훈련하고 배포할 수 있게 되었습니다. 그러나 이러한 모델과 그 학습 데이터의 엄청난 규모는 중앙 집중식 개발을 점점 더 지속하기 어렵게 만들고 있으며, 동시에 관련된 개인 데이터를 보유하되 이에 상응하는 인프라를 갖추지 못한 소규모 기관들을 배제하고 있습니다. 본 논문에서는 분산형 LLM 훈련에 관한 우리의 입장을 사전 학습 및 미세 조정 패러다임을 중심으로 정리하고, 연합 학습, 분할 학습 및 탈중앙화 접근법을 다루며, 이들 방법이 이질적인 하드웨어와 신뢰성 낮은 연결성을 가진 지리적으로 분산된 환경에서 어느 정도 준비되어 있는지 평가합니다. 이어서 우리는 {\em 통합}된 시스템을 제시합니다

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
진행 상황 및 관련 보도

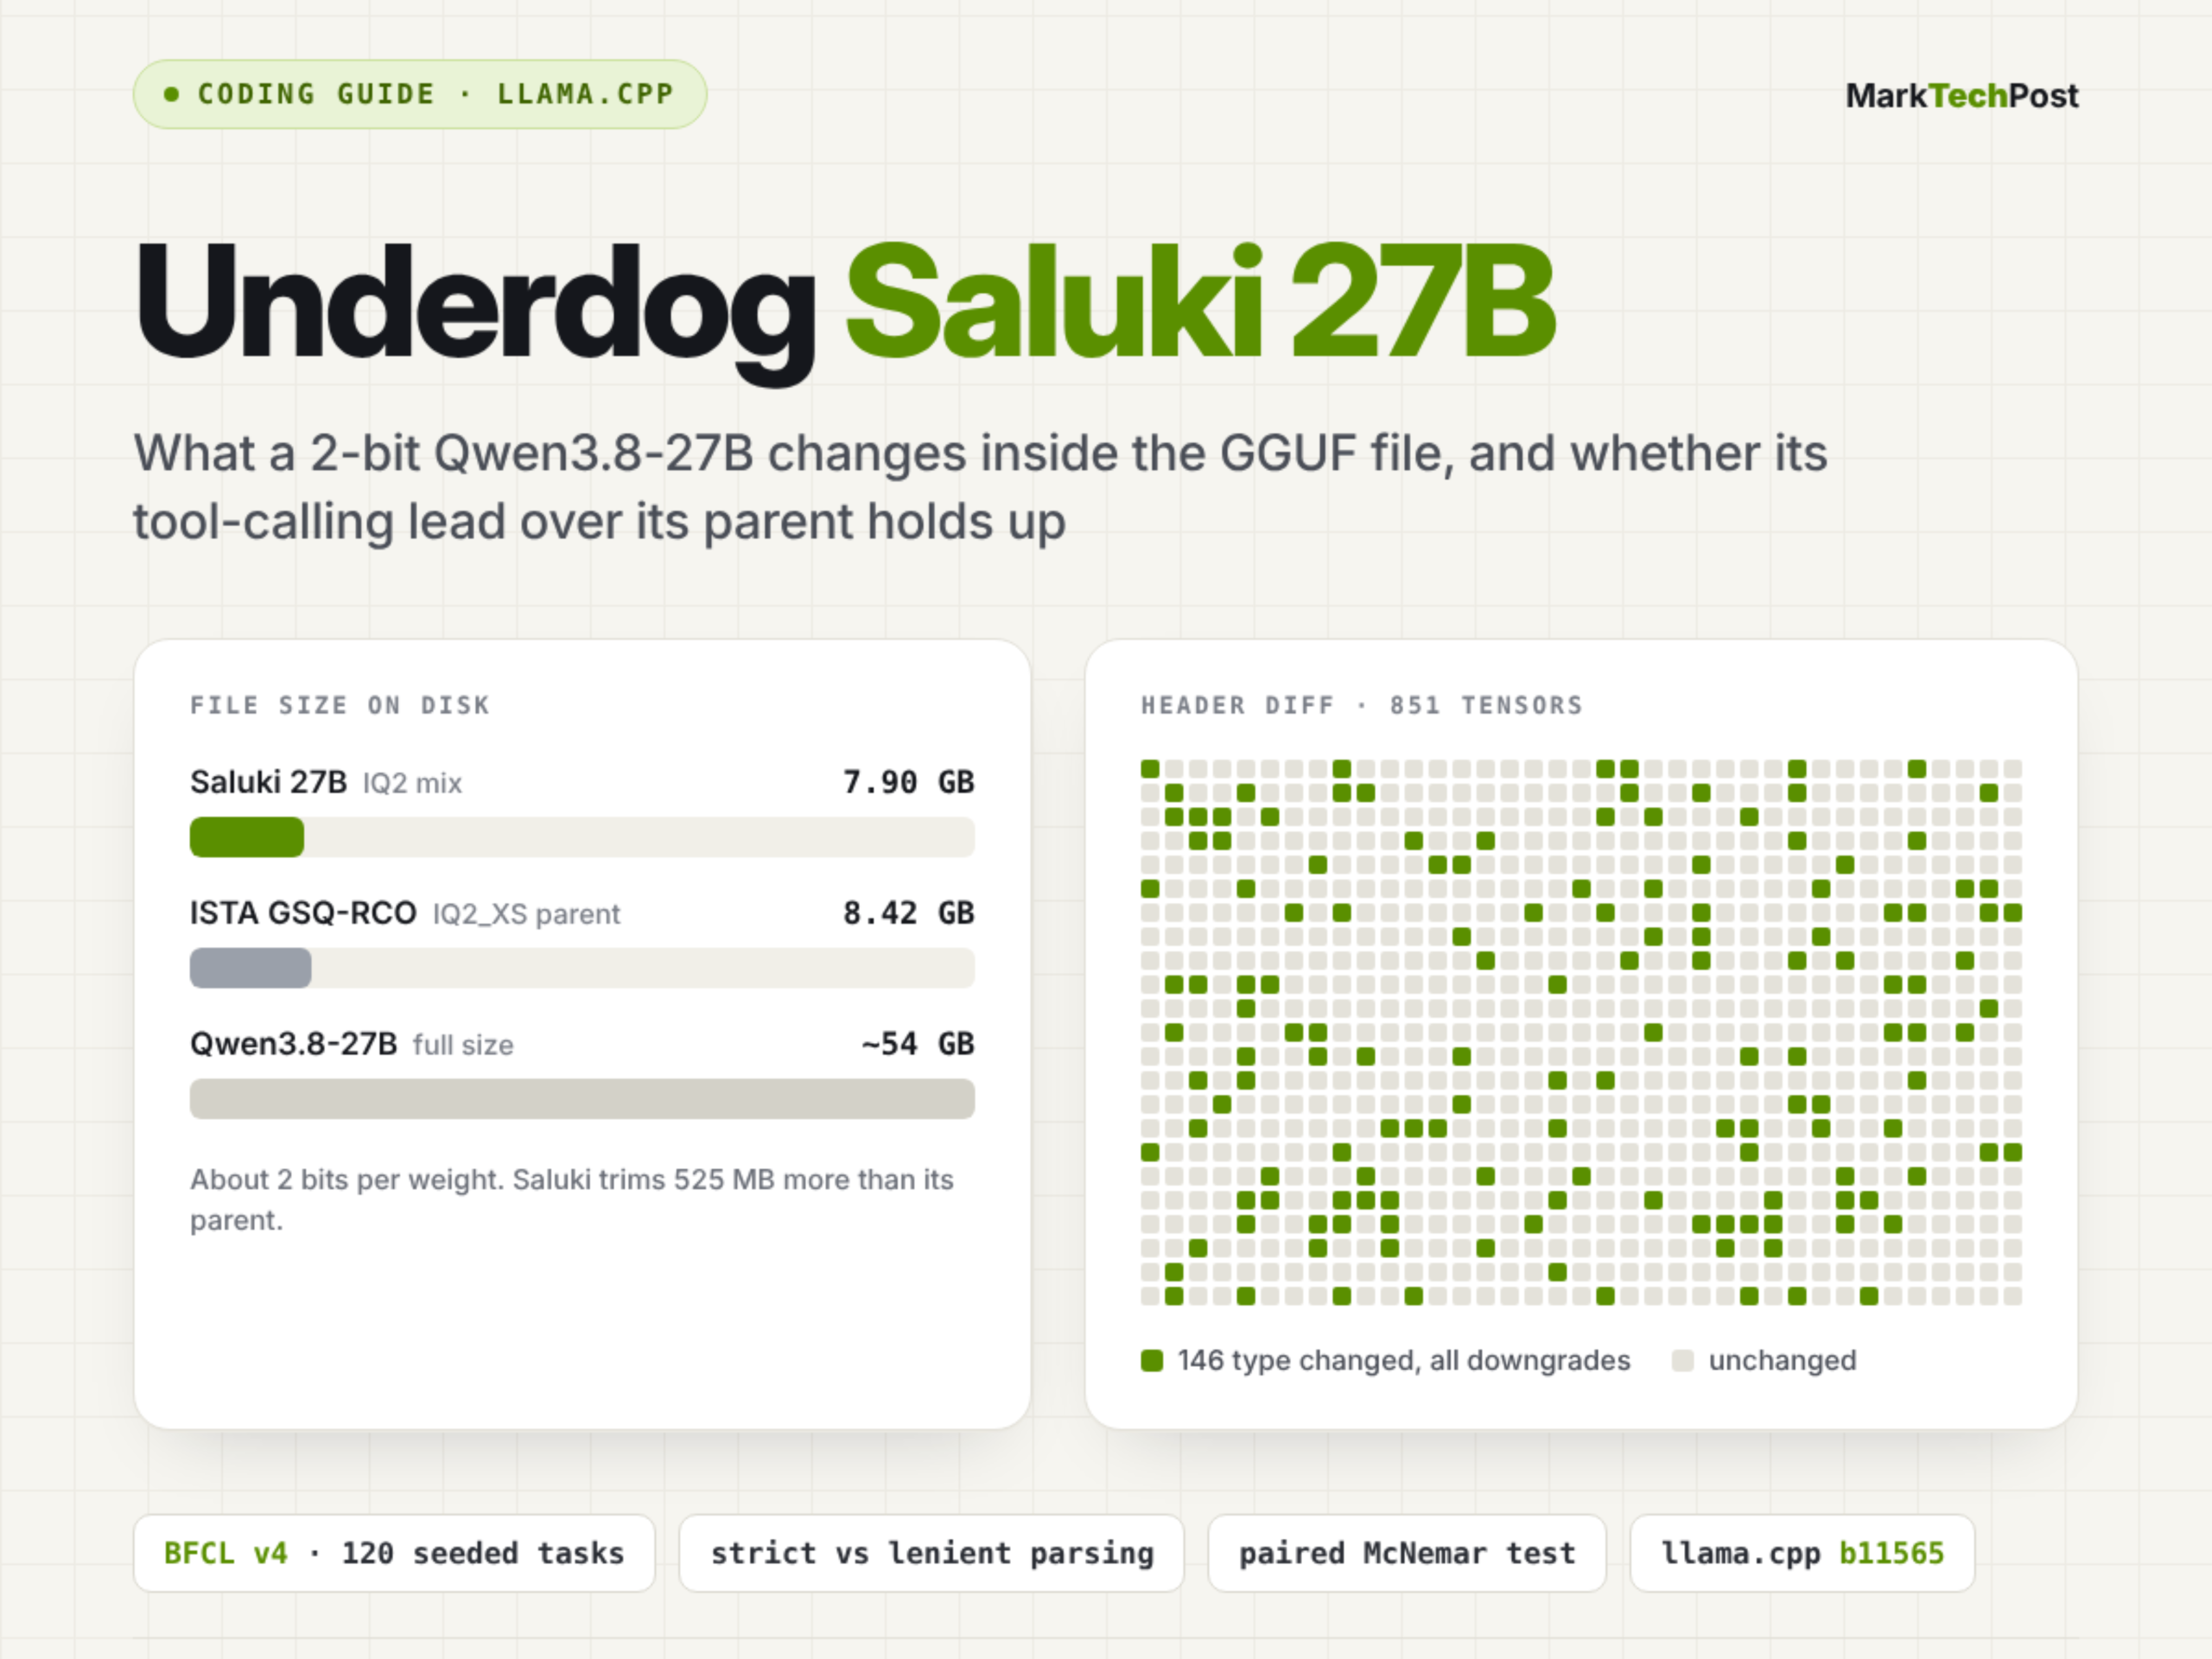
언더독 살루키 27B: GSQ-RCO 기반 2비트 Qwen3.8-27B 도구 호출 모델 기술 분석

이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

연구는 LLM이 생성한 합성 설문조사 응답자 커버리지를 평가하는 새로운 지표 RCG를 제안했다.

이 논문은 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30900v1), 대규모 언어 모델(LLM)이 생성한 합성 설문 응답자가 실제 인간 응답자를 완전한 응답 프로파일 공간에서 얼마나 잘 포괄하는지를 측정하기 위한 새로운 평가 지표인 ‘응답자 포괄 격차’(RCG)를 제안한다.

Silicon Samples Match the Answers but Not the Respondents

추천 이유:기존 평가 방법은 단일 문항의 정답 분포나 문항 간 상관성에만 주목할 뿐, LLM이 생성한 응답자가 실제 모집단에서 실제로 존재하는 정답 조합을 재현했는지 여부를 식별할 수 없다. RCG는 최초로 전체 응답 프로파일을 기반으로 커버리지 격차를 정량화하였으며, 두 가지 미국 사회조사 데이터를 통해 모든 테스트 대상 LLM에서 유의미한 미커버리지 인구가 존재하고, 이들이 단순한 변동성 표본 추출 기준선 및 가우스 코플라 모델보다 성능이 저조함을 실증적으로 확인했다.

진행 상황 및 관련 보도

새로운 연구에서 ReflectPO 프레임워크를 제안하여, 대규모 언어 모델 에이전트의 장기적 작업에서의 자율적 오류 수정 능력을 향상시켰다.

2026년 10월 24일, arXiv는 “ReflectPO: 장기 주기 LLM 에이전트를 위한 반성 유도 전략 최적화”라는 제목의 연구 논문(번호 2610.30933v1)을 발표했으며, 복잡하고 다단계이며 상태에 의존하는 작업에서 도구 기반 대규모 언어 모델 에이전트의 자율적 오류 복구 능력을 강화하기 위해 ReflectPO라는 강화학습 프레임워크를 제안했습니다.

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

추천 이유:이 논문은 최근 발표된 최첨단 AI 연구로, 현재 LLM 에이전트의 실용화에서 핵심적인 한계인 장기 작업에서 발생하는 초기 오류의 누적 효과에 초점을 맞추고 있다. 본 연구에서 제안한 Reflection-Guided Sampling과 Tree-Structured Credit Assignment의 이중 구성 설계는 방법론적 혁신성을 갖추고 있으며, 두 가지 도구 사용 벤치마크에서 여러 기준선을 상회하는 실증적 성과를 보여 기술적 참고 가치를 지닌다.

진행 상황 및 관련 보도

내일 무엇을 물어볼지 학습하기: 장기적 개인화 웹 에이전트를 위한 능동적 선호도 획득

arXiv:2610.31107v1 발표 유형: 신규 요약: 웹 에이전트는 여행 예약, 쇼핑, 일정 관리 등 반복적인 온라인 작업에서 동일한 사용자를 지속적으로 지원하므로, 그들의 장기적 유용성은 사용자의 선호를 얼마나 잘 파악하고 있는가에 달려 있습니다. 수동적 기억 및 개인화 방법은 사용자가 결코 드러내지 않는 선호를 파악할 수 없으며, 현재 작업에 대한 이익만을 중시하는 명확화 방법은 이후 작업에서도 해당 답변을 재사용할 수 있는 이점을 간과합니다. 우리는 능동적 선호도 획득(APA)을 연구합니다: 어떤 누락된 선호가 질문하는 데 드는 비용을 감수할 만한 가치가 있을까요? 우리는 누락된 선호의 전망적 개인화 가치(PPV)를, 향후 작업들에서 기대되는 누적 효용 증가에서 질문에 따른 노력과 정보 공개 위험 비용을 차감한 값으로 정의하고, 질문을 선택합니다.

Learning What to Ask for Tomorrow: Active Preference Acquisition for Long-Term Personalized Web Agents
진행 상황 및 관련 보도

아마존 세이지메이커 AI가 다중 라운드 강화학습(MTRL) 프레임워크를 출시하여, 엔드투엔드 방식으로 에이전트가 다단계 작업을 완수하도록 지원합니다.

AWS는 Multi-Turn Reinforcement Learning(MTRL) 기능을 출시하여, 사용자가 SageMaker AI에서 전체 작업 궤적과 최종 결과 피드백을 바탕으로 대규모 모델 에이전트를 단계별 주석 없이 학습할 수 있도록 지원합니다. Wordle을 예시로 삼아 AgentCore 배포, 데이터 준비, GRPO 학습, 보상 설계 및 비용 분석에 이르는 전 과정을 시연합니다.

진행 상황 및 관련 보도

AWS CDK는 재사용 가능한 구성 요소를 구축하여 SageMaker 엔드포인트의 확장·축소 및 업데이트 시 발생하는 블로킹 문제를 해결합니다.

SageMaker 실시간 AI 엔드포인트가 Application Auto Scaling에 등록된 상태에서는 AWS CDK 또는 CloudFormation을 통해 인스턴스 유형 및 수량과 같은 구성 설정을 직접 업데이트하려고 하면 실패합니다. 본 문서에서는 사용자 정의 리소스 기반의 CDK 구성 방식을 제안하며, 엄격한 의존성 오케스트레이션을 통해 엔드포인트 구성과 확장/축소 전략을 원자적 단위로 처리하고, 수동 업데이트를 필요 없도록 구현합니다.

진행 상황 및 관련 보도

아마존 세이지메이커가 학습 세션 API를 출시했습니다: 사용자는 GPU를 관리할 필요 없이 맞춤형 대규모 모델 학습 루프를 작성할 수 있습니다.

아마존 세이지메이커는 트레이닝 세션(Training Sessions) API를 출시하여, 사용자가 순수 파이썬 스크립트로 SFT, RLHF, GRPO, KTO 등과 같은 맞춤형 대규모 모델 훈련 로직을 구현할 수 있도록 지원합니다. GPU 리소스 스케줄링, 장애 복구, 분산 실행 및 체크포인트 관리는 모두 서비스에서 관리합니다.

진행 상황 및 관련 보도

스위치 2가 구형 게임과 AI를 이용해 탈옥에 성공했으며, 모더가 ‘마리오 카트 월드’의 맞춤형 캐릭터를 선보였다.

The Verge에 따르면, 유명한 모더인 Sammy Hajhamid(온라인 닉네임 pepsipu)는 닌텐도 스위치 2를 성공적으로 탈옥했다고 밝혔으며, 그의 도구 ‘ns2jb’는 OpenAI Codex의 지원을 받아 개발되었고, 한 오래된 게임을 통해 취약점을 유발했다고 한다. 시연 영상에서는 ‘마리오 카트 월드’가 시나모롤, 빨간색 분노의 새, 피터 그리핀, 마인크래프트 스티브 등 비공식 캐릭터가 포함된 수정 버전으로 실행되는 모습이 보여졌다.

진행 상황 및 관련 보도

유럽의 여러 기관이 NVIDIA Earth-2 오픈소스 모델을 도입해 지역 기반 날씨 및 기후 예측 애플리케이션을 추진하고 있습니다.

NVIDIA는 유럽을 대상으로 한 Earth-2 오픈소스 AI 모델 패밀리를 발표했으며, 여기에는 지역화된 단기 예보 모델인 StormScope EU가 포함됩니다. 또한 AXA, Vaisala Xweather, 맨체스터 대학교, TotalEnergies 등 여러 기관과 협력해 실제 환경에서의 검증을 진행하고 있으며, 이는 폭풍 위험 평가, 대기질 모델링, 태양광 발전 예측 및 레이더 지형 반전과 같은 과제를 포괄합니다.

진행 상황 및 관련 보도

월마트가 AI 에이전트 쇼핑 게이트웨이를 출시하여 자율적 구매 프로세스를 지원하고 사용자 통제를 강화합니다.

월마트는 공식적으로 Agent Gateway(인공지능 에이전트 게이트웨이)와 이를 지원하는 Agent Profiles 기능을 출시했으며, 이는 ChatGPT, Gemini, Meta Muse 등과 같은 승인된 인공지능 에이전트가 사용자를 대신해 월마트 및 Sam’s Club 플랫폼에서 검색과 주문을 완료할 수 있도록 허용합니다. 또한 별도의 계정 구성, 거래 승인, 지출 한도 등의 메커니즘을 통해 사용자가 에이전트의 행동을 전 과정에 걸쳐 완전히 통제할 수 있도록 보장합니다. 이러한 조치는 최근 아마존이 인공지능 에이전트를 통한 쇼핑을 금지한 것과는 뚜렷한 대조를 이룹니다.

진행 상황 및 관련 보도

AWS가 기술 프리뷰 솔루션을 발표했습니다: Amazon Quick과 Bedrock AgentCore를 활용한 거버넌스 가능한 대화형 공급망 지능 시스템 구축

AWS는 모델 컨텍스트 프로토콜(MCP) 기반의 모듈형 에이전트 아키텍처를 출시했으며, AgentCore를 통해 엔터프라이즈급 도구 인터페이스를 통합적으로 관리합니다. 또한 Amazon Quick은 비즈니스 사용자를 위한 자연어 기반 대화형 인터페이스를 제공하여 ERP, 구매, 모니터링 등 다양한 시스템 간에 실시간으로 승인 중심의 공급망 의사결정 지원을 구현합니다. 이 솔루션은 기술 미리보기 단계로, 생산 환경 적용이나 고객 도입을 보장하지 않습니다.

진행 상황 및 관련 보도