
Vercel Sandbox가 최대 4배 더 빠르게 시작됩니다
Vercel Sandbox의 시작 시간은 재사용 이미지 데이터에 대한 지역 캐싱을 활용함으로써 워싱턴 D.C.(iad1) 리전 외부에서 크게 향상되었으며, 파리에서는 초기화 시간을 최대 75% 단축하고 서울에서는 3.5초에서 1.05초로 줄였습니다. 원본과 거리가 가까운 리전에서는 거리가 짧아 더 작은 개선 효과를 보였습니다.
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
Vercel Sandbox의 시작 시간은 재사용 이미지 데이터에 대한 지역 캐싱을 활용함으로써 워싱턴 D.C.(iad1) 리전 외부에서 크게 향상되었으며, 파리에서는 초기화 시간을 최대 75% 단축하고 서울에서는 3.5초에서 1.05초로 줄였습니다. 원본과 거리가 가까운 리전에서는 거리가 짧아 더 작은 개선 효과를 보였습니다.
DeepSeek, Google, 그리고 NVIDIA가 에이전트 스택을 구축하다
arXiv:2610.36191v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM)은 흔히 유창하지만 사실과는 맞지 않는 응답을 생성하여 그 신뢰성에 대한 우려를 불러일으킵니다. 최근의 환각 탐지기들은 점점 더 내부 표현을 활용하고 있지만, 고차원의 숨은 상태에서 유의미한 신호를 추출하는 것은 여전히 어려운 과제입니다. 기존 접근법들은 종종 선택된 활성화 값이나 풀링 기반 압축에 의존하는데, 이로 인해 트랜스포머 계층, 특징 모드 및 토큰 전반에 걸쳐 분산된 판별적 정보를 놓칠 수 있습니다. 우리는 LOTUS(Low-rank Order-statistic TUcker-based Subspace learning)를 제안합니다. 이는 환각 탐지를 위한 다중선형 저랭크 분해 프레임워크로서, LLM의 숨은 상태로부터 컴팩트한 표현을 추출하면서도 레이블에 대한 의존성을 줄여줍니다.
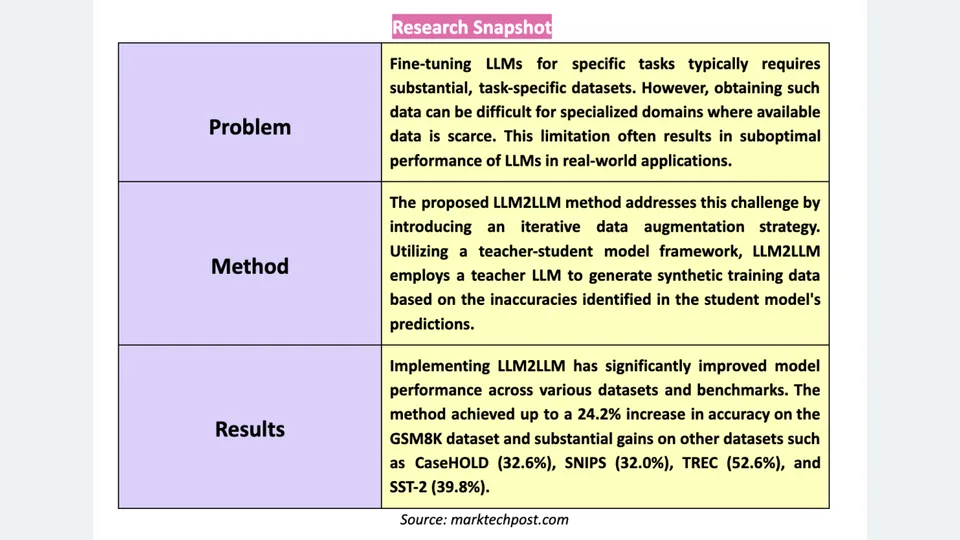
arXiv:2610.36709v1 발표 유형: 신규 초록: 추론 언어 모델은 수학 문제를 풀 때 긴 사고 체인을 작성하며, 문제당 여러 개의 체인을 샘플링한 뒤 다수결을 통해 정답을 도출하면 생성된 텍스트의 양이 크게 증가하는 대신 정확도가 향상된다. 이 비용을 줄이는 인기 있는 방법으로는, 모델이 각 토큰을 작성할 때 갖는 신뢰도를 기준으로 각 체인을 점수화하는 방식이 있다. 여기서 토큰은 단어 또는 단어의 일부를 의미한다. 이 방법에서는 2048개의 토큰으로 구성된 이동 평균 창을 사용해 해당 신뢰도를 평균화하고, 가장 낮은 평균값을 기준으로 체인을 유지하거나 중단한다. 우리는 토큰별로 기록된 이러한 신뢰도를 오디오나 라디오 신호의 맥락에서 하나의 신호로 간주하고, 스펙트럼 분석 및 갑작스러운 변화를 탐지하기 위한 통계적 검정 등 표준 신호처리 도구를 활용해 이 방법을 검토하였다. 우리는 다음과 같은 문제들로부터 각각 500개의 문제에 대해 16개의 체인을 샘플링했다.
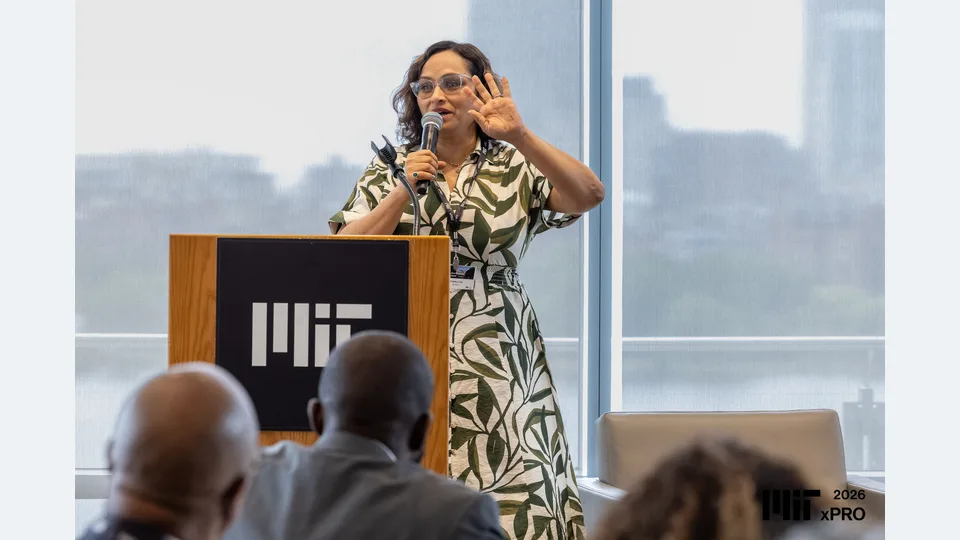
프라바 자는 MIT 오픈 러닝의 고위 임원 대상 프로그램에서 얻은 경험을 바탕으로, 자신의 직장인 버라이즌을 위해 인공지능 솔루션을 개발하고 한 권의 책을 집필했습니다.
LangChain이 Slack에서 브랜드에 맞는 동영상, 그래픽 및 프레젠테이션을 제작하는 오픈소스 디자인 에이전트인 Content Studio와 이를 구동하는 하네스를 어떻게 구축했는지.
오늘날 전 세계에는 치매를 앓고 있는 사람이 5,700만 명에 달합니다. 이들을 돕기 위해 노력하는 연구자들에게 있어 걸림돌은 노력 부족이 아니라, 과도한 데이터와 이를 종합할 전문가의 부족, 그리고 질병의 진행 속도를 따라가지 못하는 발견의 속도입니다. 생물의학 연구 및 인공지능 분야 협력단은 […]
Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 개발한 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.
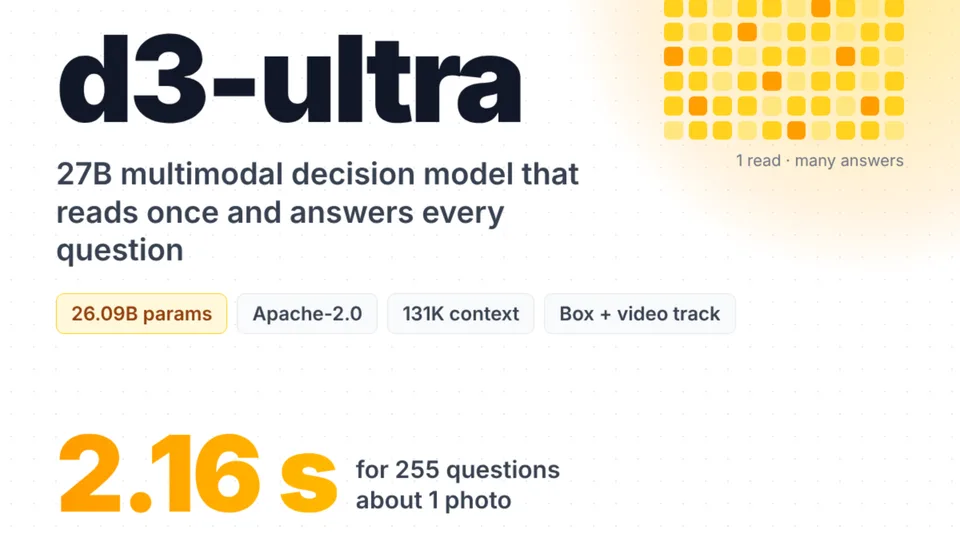
vLLM 시맨틱 라우터가 27B 규모의 오픈 웨이트 멀티모달 의사결정 모델인 d3-ultra를 출시했습니다. 이 모델은 텍스트, 이미지 및 비디오를 한 번에 처리한 뒤 모든 답변에 대한 확률을 반환하며, 팀의 SR-Text 테스트에서 87.2점을 기록했습니다. 해당 게시물 “vLLM 시맨틱 라우터, 27B 규모의 오픈 멀티모달 의사결정 모델 d3-ultra 출시”는 MarkTechPost에 처음 게재되었습니다.
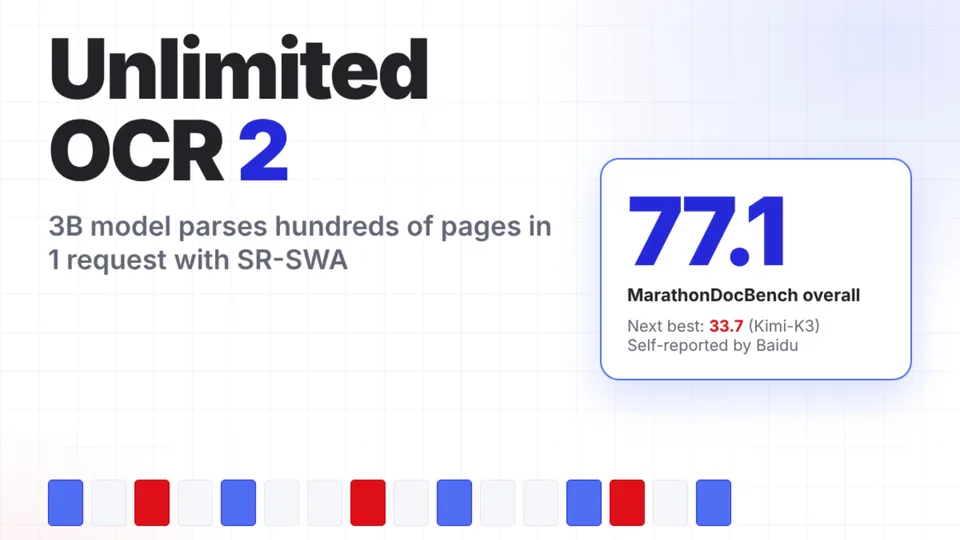
바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.
arXiv:2610.33044v1 발표 유형: 신규 초록: 체화된 시각-언어 모델은 부분적이고 변화하는 관찰로부터 제시된 질문에 답해야 한다. 이들의 성공 여부는 선택된 추론 능력과 해당 모델이 활용할 수 있는 증거 양 측면에 모두 달려 있다. 전문 라우터는 내부 계산을 조정하는 반면, 도구를 보강한 시스템은 외부 증거를 확보한다; 두 가지 접근 방식을 독립적으로 선택하면 적합한 전문가가 필요한 증거를 갖추지 못하는 상황이 발생할 수 있다. 우리는 EKT-Router를 제안하며, 이는 능력 전문가, 선택적 지식, 그리고 인지 도구를 함께 선택하는 제한된 프레임워크이다. 결과 기반 서명은 일반적 전문가, 공간 추론 전문가, 그리고 시공간 전문가의 중복되는 강점을 나타낸다. 공동 효용 함수는 호출 예산 하에서 완전한 전문가-증거 경로를 평가한다. 수집 후, 패킷 검증기는 유효한 것을 인정한다

arXiv:2610.33006v1 발표 유형: 신규 초록: 트랜스포머 기반 대규모 언어 모델(LLM)은 컨텍스트 크기가 증가함에 따라 상당한 연산 및 메모리 비용을 수반하므로, 추론 전에 컨텍스트를 더 짧은 표현으로 압축하는 방법이 필요합니다. 기존의 소프트 프롬프트 압축 방식은 일반적으로 목표 모델과 동일한 트랜스포머 백본을 사용하며, 압축된 표현을 생성하는 과정에서 상당한 지연 오버헤드가 발생합니다. 이로 인해 이러한 방식은 컨텍스트를 한 번 압축한 뒤 여러 쿼리에 걸쳐 재사용하는 오프라인 환경에만 제한됩니다. 우리는 Mamba 상태공간 모델(SSM)을 기반으로 한 플러그 앤 플레이형 온라인 컨텍스트 압축기인 Boa Compressor를 제안합니다. 이 압축기는 임의 길이의 컨텍스트를 단일 선형 시간 패스로 인코딩하여, 그 결과 얻은 표현을 바탕으로 우리가 조건부…
arXiv:2610.33019v1 발표 유형: 신규 초록: 다중 모달 에이전트가 지속적인 상호작용을 수행할 때, 장기 기억은 세부적 증거 회수와 전반적 이해를 위한 내재화된 해석이라는 두 가지 서로 다르지만 상호 보완적인 기능을 수행한다. 비록 일화 기억과 잠재 기억이 각각 명시적 역사 기록과 내재화된 경험을 통해 이러한 요구를 충족하긴 하지만, 일화 기억의 증거 범위와 통합에 대한 한계, 그리고 잠재 기억의 사실적 근거 마련에 대한 한계로 인해, 어느 한 패러다임만으로는 과제 간의 다양한 기억 특성들을 모두 포괄하기 어렵다. 이러한 격차를 해소하기 위해 우리는 모델 고유의 잠재 기억을 직관적인 사전으로 활용하고, 검색 조건에 따라 공동 정렬을 통해 정확한 증거 재구성을 가능하게 하는 다중 인덱스 기반 일화 기억을 결합한 이중 기억 프레임워크를 제안한다. At i
arXiv:2610.32104v1 발표 유형: 신규 초록: 변환기 아키텍처의 능력과 한계를 규명하기 위해 여러 가지 형식적 이론들이 개발되어 왔으며, 각 이론은 아키텍처의 서로 다른 특징을 포착하는 다양한 추상화 방식을 사용한다. 이러한 이론들은 기본 가정과 개념적 틀의 차이로 인해, 변환기가 어떤 과제를 쉽게 또는 어렵게 여길지에 대한 예측에서 서로 상충될 수 있다. 우리는 변환기 능력에 관한 일곱 가지 이론(Star-free, $\mathsf{AC}^0$, $\mathsf{TC}^0$, C-RASP, MPC, BAPO, 그리고 Sensitivity)을 정리하고, 이를 다양한 계산 구조를 포괄하는 여러 과제 세트에 걸쳐 공통적인 예측 매트릭스로 변환하였다. 또한 이 매트릭스를 완성하기 위한 새로운 이론적 결과를 제시한다. 이후 우리는 이론적…
arXiv:2610.33501v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM) 서비스는 추론 처리량을 높이기 위해 배치 처리에 의존하지만, 키-값(KV) 캐시는 시퀀스 길이와 함께 증가하여 GPU 상주 동시성을 제한한다. CPU 오프로드를 통해 호스트 메모리를 활용하면 KV 용량을 확장할 수 있지만, 기존 시스템은 여전히 대부분 GPU 중심으로 작동한다: CPU 상주 요청은 GPU 스케줄러가 적절한 겹침 기회를 제공할 때에만 진행된다. 그 결과, 호스트 메모리와 CPU 연산은 독립적인 서비스 자원으로 작용하지 못하며, 이로 인해 부하 하에서 CPU 측 진행이 간헐적으로 발생하고 꼬리 부분의 토큰 간 지연(ITL)이 부풀어 오르게 된다. 우리는 호스트를 독립적으로 스케줄링되는 디코딩 엔진으로 전환하는 LLM 서비스 런타임인 DualPace를 제안한다. DualPace는 두 개의 엔진 간에 스케줄링 권한을 분리한다: GPU 엔진
arXiv:2610.33070v1 발표 유형: 신규 초록: 이미지-비디오(I2V) 확산 모델은 단일 인물 사진이나 이미지를 애니메이션화하여, 주체의 허가 없이 공유된 이미지를 움직임 합성에 재사용할 수 있도록 합니다. 우리는 이러한 용도에 대비한 선제적 시각적 보호를 연구합니다: 이미지가 공개되기 전에 소유자는 공유 워크플로우는 유지하되 하위 단계의 움직임 생성을 방해하는 제한된 변동을 적용합니다. 기존의 스펙트럼 교란 목적은 시간적 표현을 전반적으로 감쇠시키므로, 미세하거나 공간적으로 국부화된 움직임에 대해서는 제한된 통제만 가능합니다. 우리의 핵심 아이디어는 생성된 동작이 시간적 특징의 강도뿐만 아니라, 특징 이벤트가 발생하는 순서에도 의존한다는 점입니다. 우리는 PhaseBreak라는 화이트박스 스펙트럼 리타이밍 보호 기법을 제안합니다.
arXiv:2610.33047v1 발표 유형: 신규 요약: 장기간 작동하는 어시스턴트는 종종 여러 번의 대화 전에 설정된 지시사항, 제약 조건 및 현재 목표를 포함한 후속 요청을 해석합니다. 따라서 핵심 과제는 단순히 문맥 길이가 아니라 검색 의도입니다. 예를 들어, “이전 구성 사용”과 같은 현재 쿼리는 관련 증거를 찾는 데 필요한 프로젝트, 엔터티, 버전 등의 용어를 생략할 수 있습니다. 장기 문맥 모델은 대화 기록을 재생하여 이러한 용어를 복구할 수 있지만, 반복적으로 이전 대화를 처리하는 비용을 부담해야 합니다. 기존의 검색 강화 생성(RAG) 방식은 비용이 더 저렴하지만, 정보가 충분한 쿼리라는 전제를 가집니다. 대화형 재작성 방식은 기록을 다시 읽거나 명시적으로 유지되는 텍스트 메모리에 의존합니다. 우리는 \emph{매개변수형 세션 상태}를 도입합니다
## 변경된 내용 * model_prefetch: https://github.com/Comfy-Org/ComfyUI/pull/17178에서 @rattus128이 모든 그래프 정리 작업을 동기화했습니다 * https://github.com/Comfy-Org/ComfyUI/pull/17172에서 @kijai가 MOSS-image에 로프 스케일링 지원 기능을 추가했습니다 * [파트너 노드] https://github.com/Comfy-Org/ComfyUI/pull/16943에서 @dante01yoon이 API 노드의 파트너 노드 로그인 토큰을 갱신했습니다 * [파트너 노드] feat(HeyGen): https://github.com/Comfy-Org/ComfyUI/pull/17043에서 @bigcat88이 HeyGen Voice 즉석 클론 및 텍스트 음성 변환 기능을 추가했습니다 * [파트너 노드] feat(ClarityAI): https://github.com/Comfy-Org/ComfyUI/pull/17192에서 @bigcat88이 Crystal Video Upscaler 노드를 추가했습니다 * [파트너 노드] feat(BFL): https://github.com/Comfy-Org/ComfyUI/pull/17200에서 @bigcat88이 FLUX 3 비디오 노드에 2K/4K 해상도 옵션을 추가했습니다 * MOSS-image 지원
사이버보안 업계는 강력한 최첨단 AI 모델이 양날의 검임을 깨닫고 있습니다. 기업들은 이러한 모델을 활용해 소스 코드와 시스템 구성의 취약점을 그 어느 때보다 빠르게 식별할 수 있습니다. 그러나 알고 보니 악성 행위자들도 이와 같은 작업을 수행할 수 있습니다. AI 모델이 사이버보안 분야를 새로운 차원으로 전환시킨 대표적인 사례는 다음과 같습니다 […] 본 글은 ‘양날의 검: AI가 시스템 보호를 한층 더 정교하게 만드는 동시에 악성 행위자들에게 새로운 취약점을 열어주다’라는 제목으로 SiliconANGLE에 처음 게재되었습니다.