
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

스탠퍼드 대학과 UC 버클리 대학의 연구진이 TokenGate를 발표했습니다: 토큰 기반 접근 제한 주의 메커니즘을 통해 장문 컨텍스트 사전 채우기가 최대 11.3배 더 빨라집니다.

스탠퍼드 대학교와 캘리포니아 대학교 버클리 캠퍼스의 연구진은 기존 대규모 언어 모델(LLM)에 적용 가능한 플러그 앤 플레이 방식의 학습형 토큰 가위 모듈인 TokenGate를 제안했습니다. 이 방법은 정확도를 유지하면서, 긴 컨텍스트를 사전 채워 넣는 첫 글자 생성 시간(TTFT)을 1.4배에서 최대 11.3배까지 가속화하고, 최대 메모리 사용량을 1.5배에서 최대 3.4배까지 절감합니다. 관련 코드와 체크포인트는 오픈소스로 공개되었습니다.
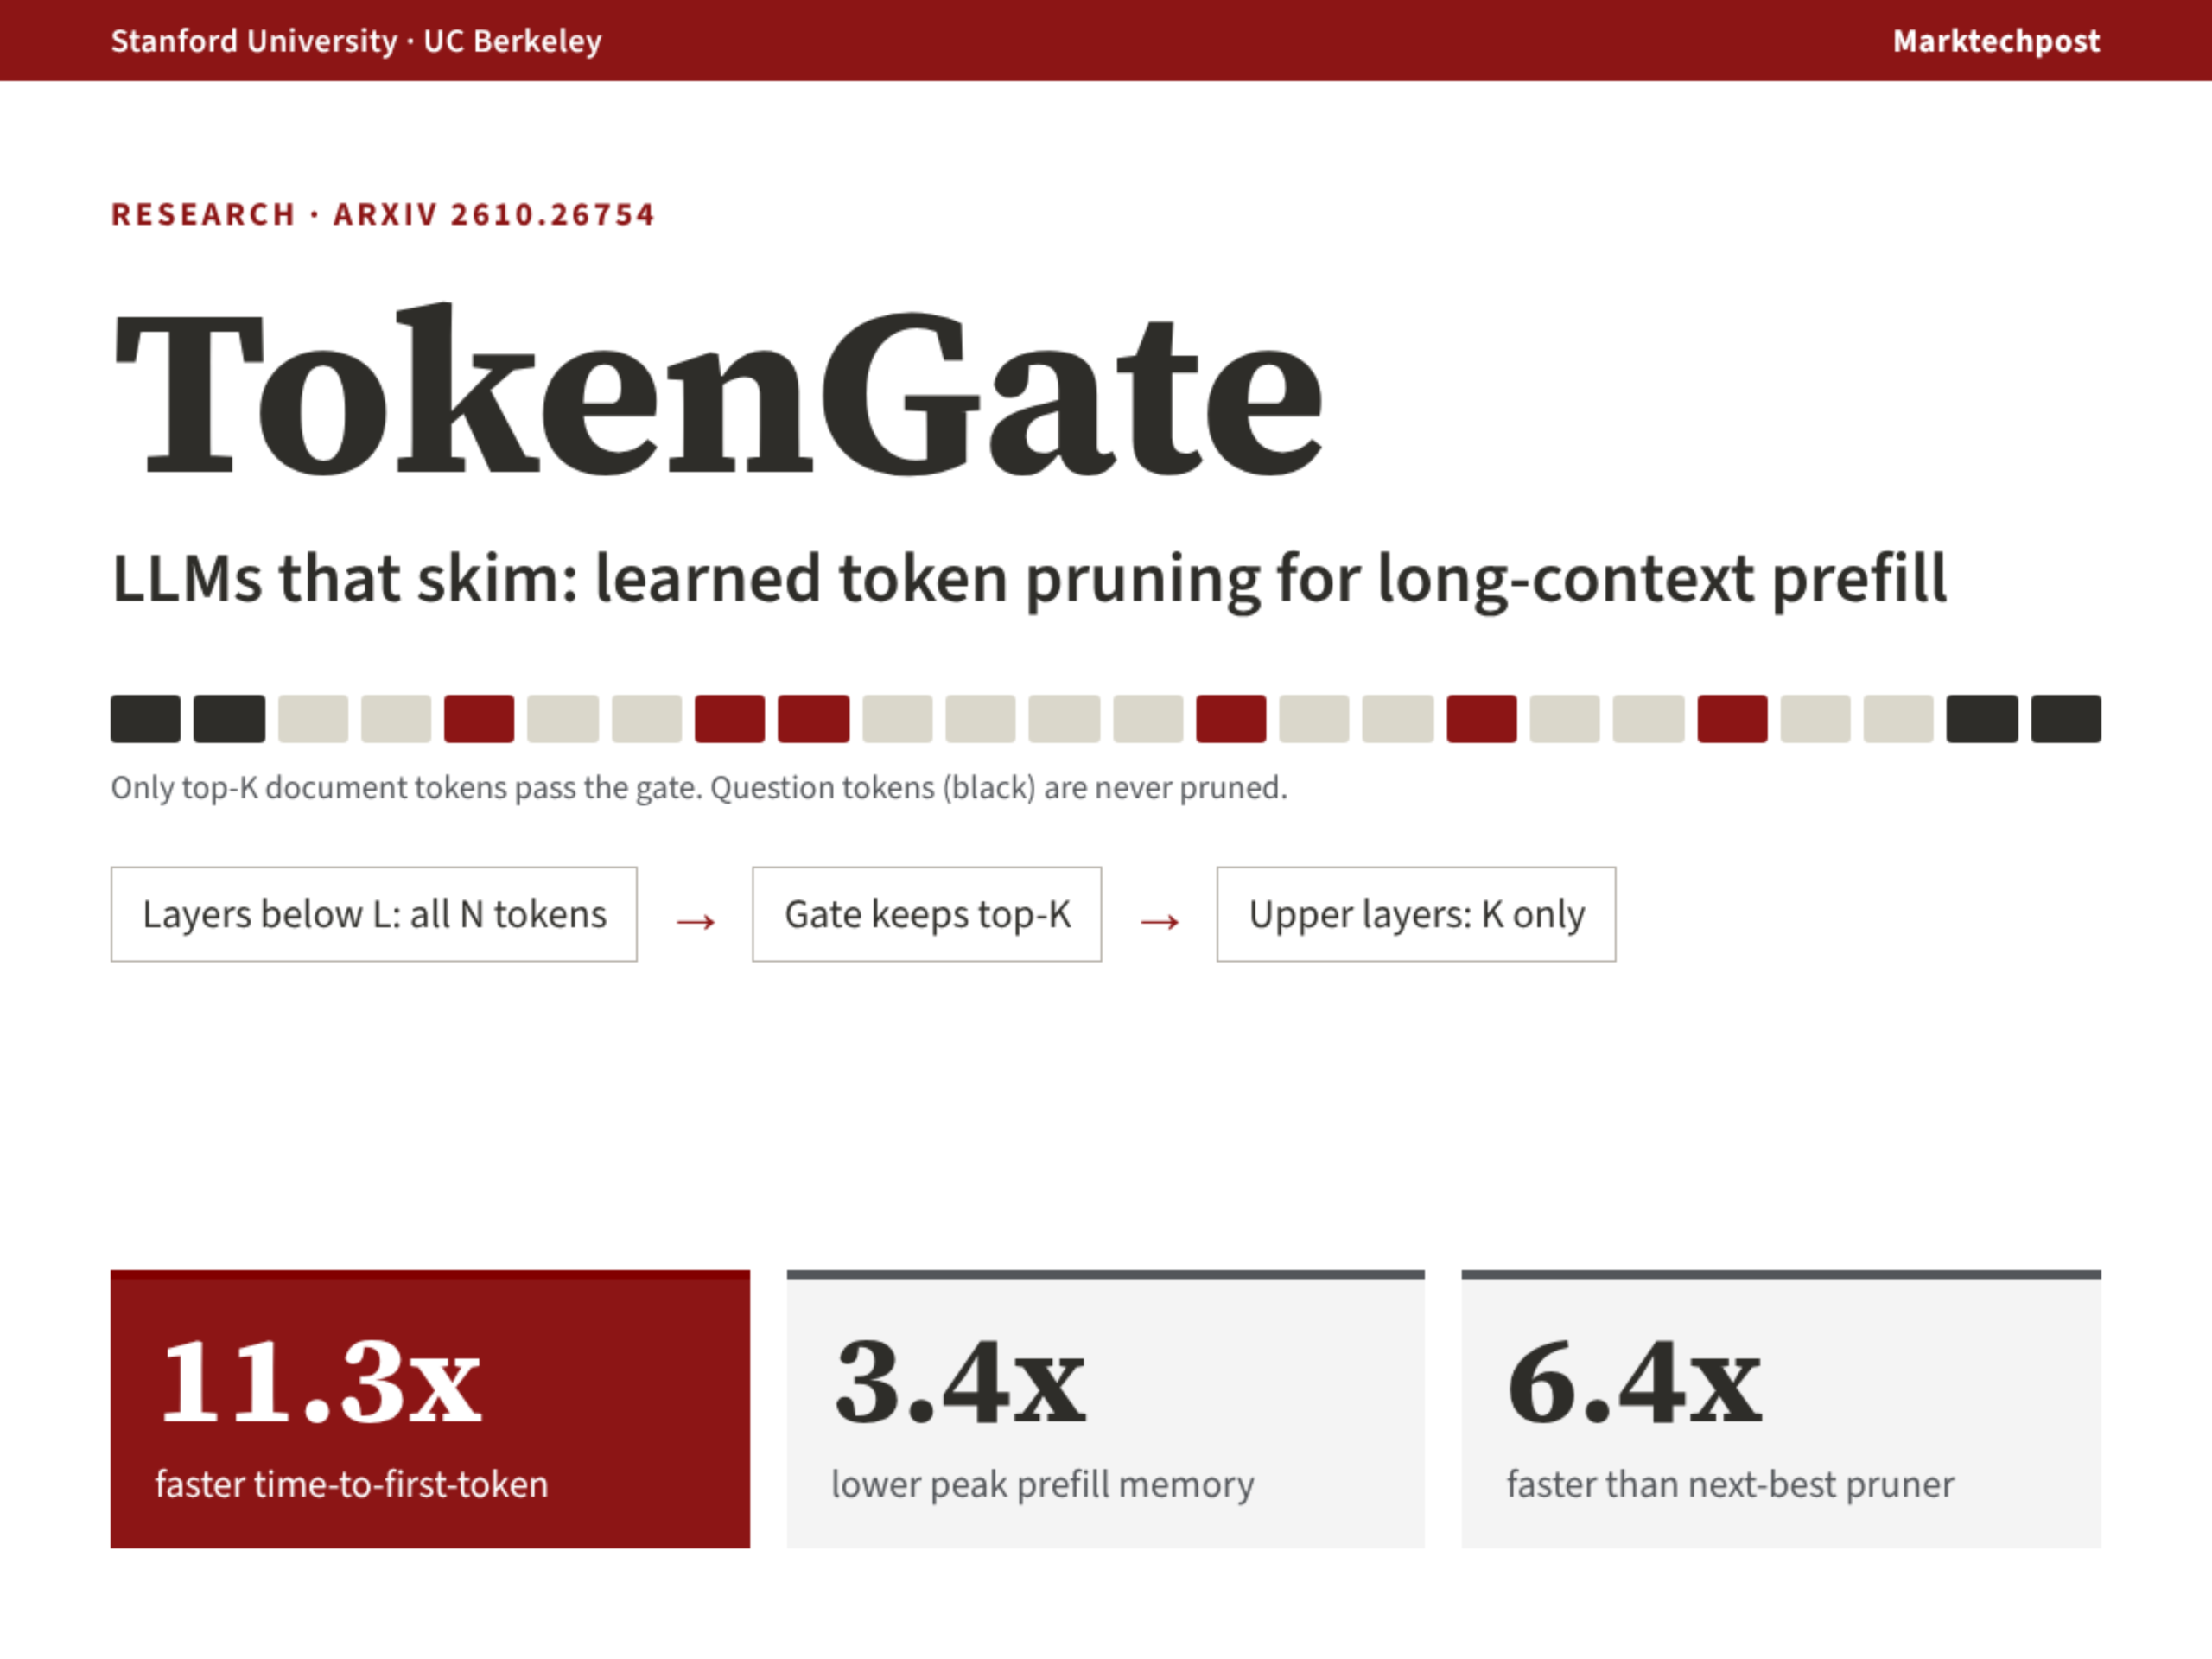
Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
진행 상황 및 관련 보도

새로운 연구는 오픈북 평가가 주로 지식 저장보다는 읽기 행동을 측정한다는 점을 밝혀냈다.

2026년 10월 24일에 발표된 arXiv 논문(2610.31017v1)은 문서 수준의 LoRA 어댑터 평가에서 오픈북 스코어링이 어댑터가 해당 문서의 지식을 실제로 인코딩했는지 여부보다는 모델의 즉각적 읽기 능력에 크게 의존한다고 지적했다. 무작위 어댑터는 오픈북 과제에서 전문가용 어댑터의 우위를 82%까지 재현할 수 있었지만, 비소스 텍스트를 대상으로 한 클로즈 과제에서는 단 2%만 재현되었으며, 이는 통계적으로 영과 구별되지 않았다.

Mostly Reading: What Open-Book Scores Measure in Document-Level LoRA Adapters

추천 이유:이 연구는 체계적인 제어 실험(위키백과 문서 150편, Llama-3.1-8B-Instruct 모델, 이중 작업 비교)을 통해 현재의 오픈북 평가 패러다임의 근본적 한계를 밝혀냈다. 즉, 이 패러다임은 ‘읽기’와 ‘암기’를 효과적으로 구분하지 못하며, 지식 편집 및 검색형 어댑터의 실제 효용성에 대한 방법론적 도전 과제를 제기한다. 또한 논문에서는 ‘깨끗하지만 잘못된 결과’를 초래하는 네 가지 침묵 오류를 보고하여 재현성 위험을 부각시켰다.

진행 상황 및 관련 보도