
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

시퀀싱 프로토콜 이해를 위한 AI 에이전트 평가 및 개선

arXiv:2610.37851v1 발표 유형: 신규 초록: 기존의 과학적 에이전트 벤치마크는 에이전트가 시퀀싱 프로토콜에서 명시된 정확한 분자 구조와 생성 워크플로를 재구성할 수 있는지에 대해 거의 평가하지 않으며, 이는 맞춤형 시퀀싱 분석을 수행하는 데 매우 중요한 역량입니다. 우리는 시퀀싱 라이브러리 구조와 분자 워크플로를 재구성하기 위한 문서 기반 벤치마크인 LibStructBench를 제안합니다. 우리의 실험 결과에 따르면, 최첨단 에이전트들은 대체로 대략적인 재구성을 수행하긴 하지만, 특히 분자 상태 표현과 워크플로 연결성 측면에서 정확한 재구성에는 여전히 신뢰성이 부족한 것으로 나타났습니다. 또한, 기본 언어 모델을 변경하는 것이 에이전트 하네스를 교체하는 것보다 평균 성능 차이를 더 크게 발생시켰으며, 이는 통계적으로 유의미한 차이였습니다.
진행 상황 및 관련 보도

해설을 읽지 않고도 점수를 매기는 방법: 자동 해석 가능성 평가 데이터의 구조적 단축법

arXiv:2610.37676v1 발표 유형: 신규 요약: 자동 해석 가능성은 스파스-오토인코더(SAE) 특성에 대한 설명을 평가하기 위해, 모델에게 평가 예시들에서 해당 특성이 활성화되는 위치를 토큰별로 예측하도록 하거나, 표시된 토큰들이 그 특성에 부합하는지를 판단하도록 요청합니다. 우리는 평가 데이터의 표준 파이프라인이 생성한 결과를 설명을 읽지 않고도 점수 매길 수 있음을 발견했습니다. Neuronpedia에 저장된 GPT-2 소형 특성 500개에 대한 무작위 퍼징 실행 결과에 따르면, 활성화된 예시 중 91.3%가 중심 토큰에 최대값이 위치하도록 잘려 있으며, 중심 토큰이 표시되어 있을 때 “예”라고 판단하는 규칙은 저장된 LLM 점수 매기기 도구들(파이프라인 코드로부터 재구성된 표시 기반 판정 결과를 바탕으로 재산출)의 정확도 0.838에 비해 0.979의 균형 잡힌 정확도를 달성합니다. 또한 표시 개수만을 기준으로 판단하는 규칙은 0.969의 정확도를 보입니다. T

진행 상황 및 관련 보도

Seq@K: 순차적 피드백 하에서 언어 모델 평가

arXiv:2610.37859v1 발표 유형: 신규 초록: 언어 모델 기반 에이전트는 맥락 속의 자연어로부터 학습할 수 있다는 점에서 기존 지능형 시스템과 근본적으로 다릅니다. 이러한 능력은 현대 에이전트 워크플로우에서 널리 사용되는 방식인, 피드백에 따라 답변을 반복적으로 개선해 나가는 것을 가능하게 합니다. 그러나 커뮤니티에서는 주로 Pass@1이나 Pass@K와 같은 지표로 모델을 평가해 왔으며, 이는 모델이 이전 시도에서 얻은 피드백을 어떻게 활용하는지를 포착하지 못합니다. 우리는 각각의 이전 시도가 실패했을 때마다 피드백을 제공받아, K번의 연속된 시도 내에 문제를 해결할 수 있는지 여부를 측정하는 자연스러운 평가 프로토콜인 Seq@K를 제안합니다. 장기 계획을 검토하는 다단계 에이전트 벤치마크와 달리, Seq@K는 개선이라는 핵심 역량을 분리하고 이를 정식화합니다.

진행 상황 및 관련 보도

에이전트 간 인수 이행에 대한 벤치마킹 과제

arXiv:2610.36523v1 발표 유형: 신규 초록: 에이전트들이 더 긴 작업을 협업하는 과정에서, 작업이 완료되기 전에 책임이 모델 간에 이양될 수 있습니다. 수신 모델은 남아 있는 요구사항을 해결하면서, 이전의 결정, 관찰 및 행동을 바탕으로 작업을 이어가야 합니다. 이러한 전환 과정을 평가하려면, 인수 이전에 보존된 정보와 수신 모델이 어떻게 작업을 계속해 나가는지 사이의 관계를 연결해야 하며, 이는 단순히 작업 성공률과 기억 유지 점수만으로는 포착할 수 없습니다. 우리는 인수 이행 상태 연속성 벤치마크(HSC-Bench)를 도입하며, 이는 작업 인수의 두 가지 상호보완적인 측면을 평가하는 1,039개의 과제로 구성되어 있습니다: 관련 저장소 증거를 복구하고, 이미 설정된 대화, 도구 및 파일 작업 상태에서 계속 진행하는 능력입니다. 여섯 개의 수신 모델 간 비교 결과에 따르면, 구조적…

진행 상황 및 관련 보도

Mirendil, 1,000만 토큰 규모의 첫 번째 모델인 Fern 0.1을 출시했습니다

Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 개발한 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

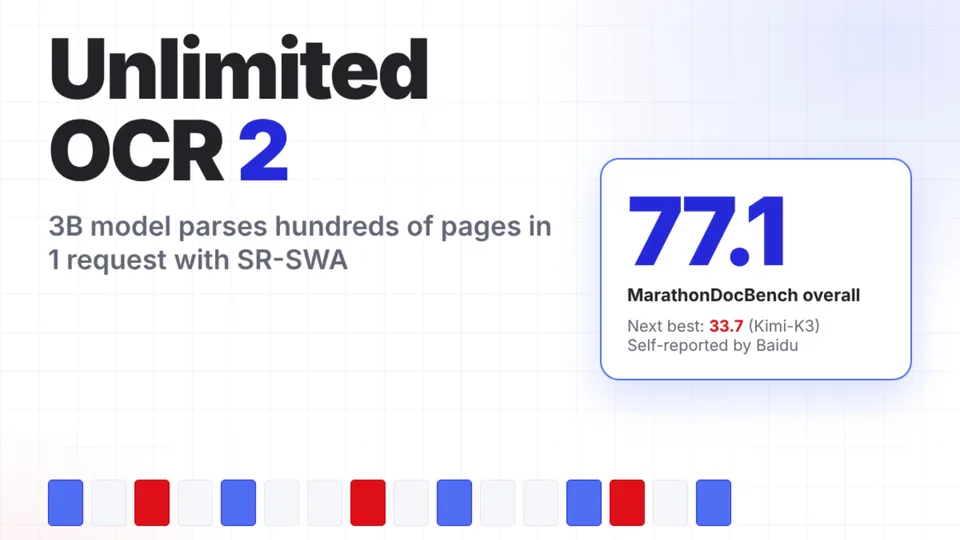
바이두, 수백 페이지 문서 파싱을 위한 무제한 OCR 2 오픈소스 출시

바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

AdaptTok-Indic: 인도계 언어를 위한 스크립트 인식형 적응형 토큰화

arXiv:2610.33017v1 발표 유형: 신규 요약: 영어 중심의 말뭉치로 학습된 다국어 토큰라이저는 종종 인도계 언어를 과도하게 세분화하여, 결과적으로 더 긴 토큰 시퀀스와 각 스크립트 간의 토큰화 격차를 초래합니다. 우리는 AdaptTok-Indic을 제안합니다. 이는 유니코드 정규화 전처리와 명시적인 인도계 결합 처리, 스크립트 인식형 라우팅, 그리고 소규모 트랜스포머 언어 모델과 함께 공동 학습된 학습 기반 바이트 수준 경계 예측을 결합한, 인도계에 특화된 적응형 토큰라이저 확장입니다. 벵골어와 힌디어를 대상으로 평가했으며, 구자라트어, 타밀어, 텔루구어에 대해서도 추가 평가를 수행한 결과, AdaptTok-Indic은 인도계 지향 토큰라이저 베이스라인인 SentencePiece BPE 및 독립적으로 구현된 MAGNET 방식 베이스라인보다 낮은 토큰 비율을 달성했습니다. 다섯 가지 기록된

진행 상황 및 관련 보도

AWS가 CDK 기반의 관리형 Bedrock 지식 저장소 스마트 검색 참조 구현을 발표했습니다.

AWS는 2026년 10월 26일 블로그를 통해, AWS CDK를 활용해 구축한 엔터프라이즈급 에이전트 기반 검색(Agentic Retrieval)의 참조 구현을 소개했습니다. 이 솔루션은 Amazon Bedrock의 관리형 지식 베이스(Managed Knowledge Base)에 특화되어 있으며, 지식 베이스 간의 시맨틱 라우팅, 반복적 검색, 인용 정보를 포함한 출처 추적 답변 및 7계층 관찰성을 지원합니다.

추천 이유:이 자료는 AWS 공식 기술 블로그(2026년 10월 26일 게시)에 실린 것으로, 2024년 8월에 출시된 관리형 KB 및 AgenticRetrieveStream API와 같은 이미 제공되는 기능, 네 스택 CDK 애플리케이션과 같은 검증 가능한 배포 구조, 지역별 이용 가능성 및 관리형 KB에만 한정된 사용 제한 등 명확한 제약 사항, 그리고 오픈소스 구현 세부사항에 초점을 맞추고 있습니다. 성능에 관한 단언이나 제3자에 의한 신뢰성 보증은 포함되어 있지 않으며, 사실성과 시의성을 충족합니다.

진행 상황 및 관련 보도

Nace AI, AI 에이전트 검색을 위한 Drex 출시: BrowseComp-Plus에서 92.05%, 검색 호출 수는 12.6회

Nace AI는 Drex for Search를 출시하며, 자사의 Drex 의사결정 모델을 AI 에이전트의 문서 검색에 적용했습니다. Nace는 BrowseComp-Plus에서 12.6회의 검색 호출로 92.05%의 성과를 기록했으며, OfficeQA Pro에서는 에이전트의 전환 횟수가 더 적었습니다. 이 글은 MarkTechPost에 처음 게재되었습니다.

진행 상황 및 관련 보도

오픈 ISA 슈퍼컴퓨팅을 향하여: HPC 워크로드에 대한 RISC-V, Arm, x86 아키텍처 비교 연구

arXiv:2610.32632v1 발표 유형: 신규 초록: RISC-V는 고성능 컴퓨팅(HPC)의 후보 아키텍처로 부상하고 있지만, 기존의 x86 및 Arm 프로세서와의 경쟁력은 아직 평가하기 어렵습니다. 이는 기존 연구들이 서로 다른 플랫폼, 워크로드, 방법론을 사용하고 있으며, 에너지 효율성을 거의 고려하지 않기 때문입니다. 본 연구에서는 공통된 소프트웨어 스택과 방법론을 활용하여 최신 HPC용 RISC-V, Arm, x86 프로세서를 평가합니다. 우리는 Sophgo SG2044를 특성화하고, NVIDIA Grace CPU 슈퍼칩 및 Intel Xeon Platinum 8480+와 함께 STREAM, HPL, HPL-MxP, HPCG 등 네 가지 HPC 벤치마크와 iPIC3D, PLUTO, OpenFOAM, llama.cpp 등 네 가지 대표 애플리케이션에서 비교 분석을 수행했습니다. 본 연구에서 사용된 OpenBLAS 기반 HPL-MxP 버전은

Toward Open ISA Supercomputing: A Comparative Study of RISC-V, Arm, and x86 Architectures on HPC Workloads
진행 상황 및 관련 보도

LLM 평가에서 전체 F1 점수만을 사용해 자동 채점기를 검증하는 것은 오해를 유발할 위험이 있다: 새로운 연구는 구체적인 프롬프트 차이에 맞춰 검증해야 함을 강조한다

arXiv 논문(2610.31678v1)은 대화형 대규모 언어 모델 평가에서 자동 채점 도구의 전체 정확도나 F1 점수에만 의존하면 프롬프트 특이적 오류가 가려져 프롬프트 효과에 대한 잘못된 판단을 초래할 수 있다고 지적한다. 실증 분석에 따르면, 동일한 채점 도구가 서로 다른 프롬프트에서 보이는 위양성률은 2.6%에서 33.3%로 크게 차이 나며, 겉보기로 유의미한 9.3점의 효과도 두 개의 LLM 심사 하에서는 2.3점으로 축소되고 통계적으로 유의미하지 않게 된다.

Validating the Comparison, Not Just the Scorer: Why Overall Accuracy Can Mislead in Interactive LLM Evaluation

추천 이유:이 연구는 실제 실험 데이터(6개의 모델, 180개의 가상 개체 질문, 6가지 프롬프트 조건)를 기반으로 하며, 현재 LLM 평가에서 널리 존재하는 방법론적 취약점을 밝혀냈습니다—즉, 스코어러의 전반적인 성능을 핵심 비교 과제에서의 신뢰성과 동일시하는 문제입니다. 핵심 주장(각 프롬프트를 별도로 검증하고 불확실성을 반영해야 한다는 점)은 명확한 실증적 근거와 실행 가능한 권고안을 바탕으로 하며, 발표 시점(2026년 10월 26일)과 출처의 신뢰성(arXiv 사전출판 플랫폼) 측면에서도 높은 시의성을 갖습니다.

진행 상황 및 관련 보도