본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

GRAFT: 에이전트 설계를 위한 실행 기반 유전자 재조합

arXiv:2611.23509v1 발표 유형: 신규 초록: 자동 에이전트 설계는 언어 모델 크로스오버를 사용하여 작업 분해, 모델 조정 및 검증을 위한 유망한 메커니즘을 재조합하는 진화적 방법으로 LLM 기반 에이전트 성능을 향상시키는 실행 가능한 아키텍처를 탐색합니다. 그러나 이러한 탐색은 일반적으로 집계 적합도만으로 안내되며, 이는 각 점수 뒤에 숨겨진 인스턴스 수준의 성공과 실패를 가려냅니다. 우리는 에이전트 설계를 위한 실행 안내형 유전 재조합(GRAFT)을 제안하며, 여기서 집계 적합도는 선택과 생존에 사용되고 부모별 실행 증거는 통합된 변이와 함께 의미적 크로스오버를 안내하는 데 활용됩니다. 이 시스템의 피드백 하네스는 적합도 평가에서 얻은 성공 및 실패 실행의 제한된 샘플을 재사용하며, 참조 답안을 보류하고 추가적인 작업 실행을 요구하지 않습니다. 우리는 개방형 가중치 최적화 및 실행기 모델을 사용하여 여섯 가지 추론 및 프로그래밍 설정에서 GRAFT를 평가합니다. 그 결과 평균 테스트 정확도 82.0%를 달성하여 가장 강력한 기준선을 9.8%포인트 상회합니다. 통제된 제거 실험에 따르면, 초기화, 탐색 규칙, 복구 정책 및 평가 예산을 고정한 상태에서 실행 증거를 추가하면 테스트 정확도가 향상됩니다. 우리의 결과는 진화적 에이전트 설계에 있어 부모별 실행 증거의 가치를 뒷받침합니다.
시퀀싱 프로토콜 이해를 위한 AI 에이전트 평가 및 개선

arXiv:2610.37851v1 발표 유형: 신규 초록: 기존의 과학적 에이전트 벤치마크는 에이전트가 시퀀싱 프로토콜에서 명시된 정확한 분자 구조와 생성 워크플로를 재구성할 수 있는지에 대해 거의 평가하지 않으며, 이는 맞춤형 시퀀싱 분석을 수행하는 데 매우 중요한 역량입니다. 우리는 시퀀싱 라이브러리 구조와 분자 워크플로를 재구성하기 위한 문서 기반 벤치마크인 LibStructBench를 제안합니다. 우리의 실험 결과에 따르면, 최첨단 에이전트들은 대체로 대략적인 재구성을 수행하긴 하지만, 특히 분자 상태 표현과 워크플로 연결성 측면에서 정확한 재구성에는 여전히 신뢰성이 부족한 것으로 나타났습니다. 또한, 기본 언어 모델을 변경하는 것이 에이전트 하네스를 교체하는 것보다 평균 성능 차이를 더 크게 발생시켰으며, 이는 통계적으로 유의미한 차이였습니다.

진행 상황 및 관련 보도

해설을 읽지 않고도 점수를 매기는 방법: 자동 해석 가능성 평가 데이터의 구조적 단축법

arXiv:2610.37676v1 발표 유형: 신규 요약: 자동 해석 가능성은 스파스-오토인코더(SAE) 특성에 대한 설명을 평가하기 위해, 모델에게 평가 예시들에서 해당 특성이 활성화되는 위치를 토큰별로 예측하도록 하거나, 표시된 토큰들이 그 특성에 부합하는지를 판단하도록 요청합니다. 우리는 평가 데이터의 표준 파이프라인이 생성한 결과를 설명을 읽지 않고도 점수 매길 수 있음을 발견했습니다. Neuronpedia에 저장된 GPT-2 소형 특성 500개에 대한 무작위 퍼징 실행 결과에 따르면, 활성화된 예시 중 91.3%가 중심 토큰에 최대값이 위치하도록 잘려 있으며, 중심 토큰이 표시되어 있을 때 “예”라고 판단하는 규칙은 저장된 LLM 점수 매기기 도구들(파이프라인 코드로부터 재구성된 표시 기반 판정 결과를 바탕으로 재산출)의 정확도 0.838에 비해 0.979의 균형 잡힌 정확도를 달성합니다. 또한 표시 개수만을 기준으로 판단하는 규칙은 0.969의 정확도를 보입니다. T

진행 상황 및 관련 보도

Mirendil, 1,000만 토큰 규모의 첫 번째 모델인 Fern 0.1을 출시했습니다

Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 개발한 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

바이두, 수백 페이지 문서 파싱을 위한 무제한 OCR 2 오픈소스 출시

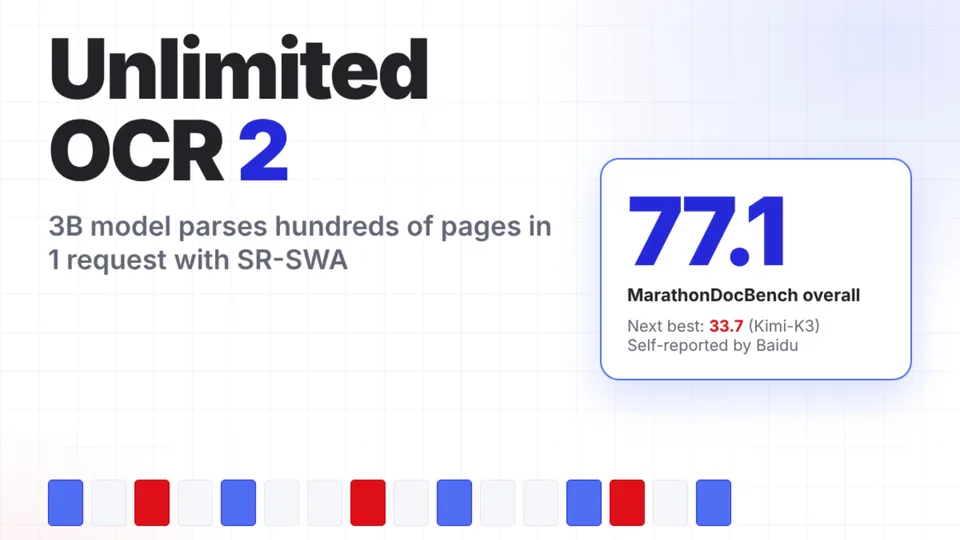
바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

소셜 월드 모델 평가 격차

arXiv:2610.33014v1 발표 유형: 신규 초록: 협상 어시스턴트는 상대방의 반응을 정확히 예측하지 않더라도 좋은 거래를 성사시킬 수 있다. 우리는 사회적 세계 모델에 대한 평가들이 이러한 예측을 직접적으로 검증하는지 여부를 묻는다. 1999년부터 2026년까지 발표된 113편의 연구를 검토한 결과, 9편의 주요 평가는 시스템이나 실험자가 선택한 행동에 대한 실제 사람의 반응을 측정한다. 이 중 단 2편만이 명시적인 반응 예측과 실제 반응을 비교하고 있다. 해당 연구들의 예측 모델은 행동이 선택될 때 이용 가능한 정보를 사용하며, 평가 대상 반응은 모델 학습 과정에서 제외되었다; 또한 두 연구 모두 개입 조건을 무작위화하였다. 언어 모델 관련 25편의 논문에 대한 별도의 전문 텍스트 검토에서는 이러한 조건을 충족하는 실험이 발견되지 않았다. 나머지 평가들은 현재 상태 추론, 과제 성공 또는 예측 f

진행 상황 및 관련 보도