
NVIDIA DGX Spark에서 MoE 추론을 향상시키는 3가지 방법
토큰을 더 빠르게 생성하려면 먼저 추론 성능을 제한하는 요인을 파악하는 것부터 시작합니다. NVIDIA에서 Inclusion AI의 Ling-3.0-flash를 대상으로 한 배치 크기 1 평가에서는...
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
토큰을 더 빠르게 생성하려면 먼저 추론 성능을 제한하는 요인을 파악하는 것부터 시작합니다. NVIDIA에서 Inclusion AI의 Ling-3.0-flash를 대상으로 한 배치 크기 1 평가에서는...
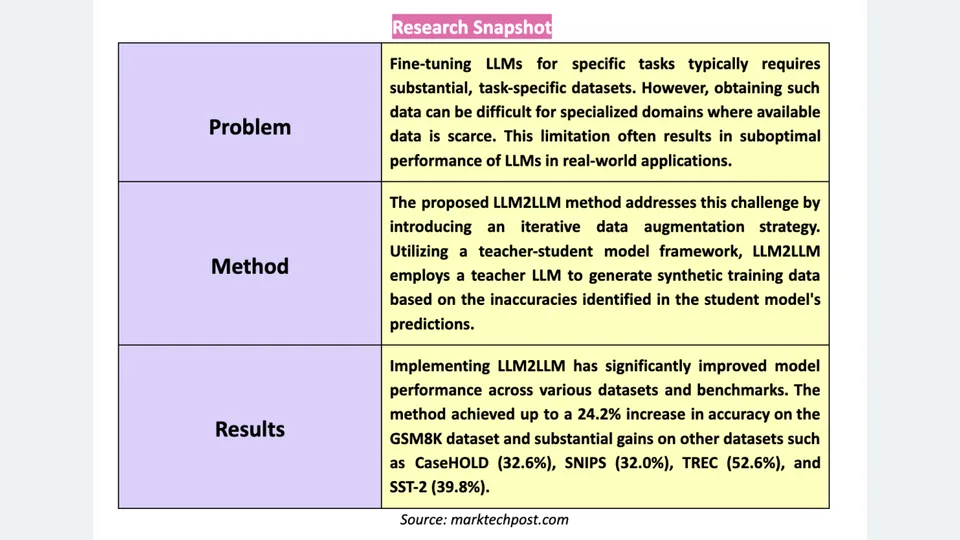
Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 개발한 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.
구 버전 순위의 점수는 만점에 근접했지만, 신규 버전의 실전 성적은 집단적으로 낙제점을 기록했다. 대형 모델 평가 자체가 하나의 비즈니스로 전환되면서, 기업들의 선택 기준은 이제 순위를 보는 데서 비용 계산으로 옮겨가고 있다.
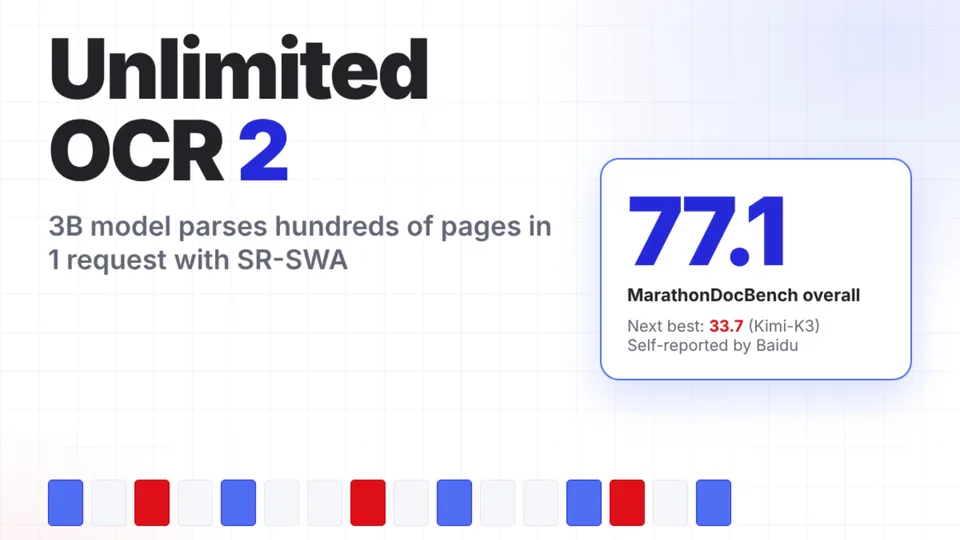
바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.
arXiv:2610.33017v1 발표 유형: 신규 초록: 영어 중심의 텍스트 코퍼스를 기반으로 학습된 다국어 토크나이저는 인도계 언어를 과도하게 세분화하는 경우가 많아, 그 결과 토큰 시퀀스가 길어지고 각 문자 체계 간의 토크나이징 격차가 확대됩니다. 우리는 유니코드 정규화 전처리와 명시적인 인도계 결합 처리, 스크립트 인식 라우팅, 그리고 소규모 트랜스포머 언어 모델과 함께 공동 학습된 학습된 바이트 단위 경계 예측을 결합한, 인도계에 특화된 적응형 토크나이징 확장인 AdaptTok-Indic을 제안합니다. 벵골어와 힌디어를 대상으로 평가했으며, 구자라트어, 타밀어, 텔루구어에 대해서도 추가적으로 평가한 결과, AdaptTok-Indic은 인도계 지향 토크나이저 기준점인 SentencePiece BPE 및 독립적으로 구현된 MAGNET 방식 기준점보다 낮은 토큰 비용을 달성했습니다. 다섯 가지 기록된
arXiv:2610.33014v1 발표 유형: 신규 초록: 협상 어시스턴트는 상대방의 반응을 정확히 예측하지 않더라도 좋은 거래를 성사시킬 수 있다. 우리는 사회적 세계 모델에 대한 평가들이 이러한 예측을 직접적으로 검증하는지 여부를 묻는다. 1999년부터 2026년까지 발표된 113편의 연구를 검토한 결과, 9편의 주요 평가는 시스템이나 실험자가 선택한 행동에 대한 실제 사람의 반응을 측정한다. 이 중 단 2편만이 명시적인 반응 예측과 실제 반응을 비교하고 있다. 해당 연구들의 예측 모델은 행동이 선택될 때 이용 가능한 정보를 사용하며, 평가 대상 반응은 모델 학습 과정에서 제외되었다; 또한 두 연구 모두 개입 조건을 무작위화하였다. 언어 모델 관련 25편의 논문에 대한 별도의 전문 텍스트 검토에서는 이러한 조건을 충족하는 실험이 발견되지 않았다. 나머지 평가들은 현재 상태 추론, 과제 성공 또는 예측 f
arXiv:2610.33036v1 발표 유형: 신규 초록: 스피킹 스타일 캡션링(SSC)은 음성의 톤, 억양, 표현력 등과 같은 비언어적 특성을 포착하여, 말이 전달되는 방식에 대한 자연스러운 언어 설명을 생성하는 것을 목표로 합니다. 대화형 AI 에이전트, 제어 가능한 음성 생성, 대규모 오디오 주석 작업 등 많은 하위 애플리케이션에서는 단일한 통합된 설명이 아니라, 특정한 음성의 측면(예: 화자의 특성, 감정, 또는 전달 스타일)을 구체적으로 기술하는 차원별 스타일 캡션을 필요로 합니다. 그러나 기존 연구들은 제어 가능한 스피킹 스타일 캡션링에 대한 통일된 수식화가 부족한 실정입니다. 우리는 이러한 한계를 해소하기 위해 SSC를 명령어 준수형 오디오-언어 과제로 정식화함으로써, 명시적인 지침이 스피킹 스타일의 특정 차원을 규정하도록 하는 접근법을 제안합니다.
arXiv:2610.33004v1 발표 유형: 신규 초록: 광학 문자 인식(OCR)은 역사 기록 보관소의 디지털화에 필수적이지만, 문자 오류율(CER)과 같은 표준 평가 지표만으로는 이름, 날짜, 식별자 등 의미 있는 정보가 제대로 유지되는지를 반드시 반영하지 못합니다. 본 연구에서는 역사 문서에서의 OCR 품질을 평가하는 데 있어 보완적인 관점으로서, OCR 오류를 엔터티 수준에서 분석합니다. 공개된 벤치마크 데이터셋인 Berrutti 아카이브의 175개 문서와, 게재 승인 시 공개될 수동으로 주석된 5,209개의 엔터티 언급을 추가하여, 시퀀스 인식 기반 OCR 시스템, OCR 전용 비전-언어 모델, 그리고 범용 비전-언어 모델을 비교합니다. 전역적 전사 정확도 외에도
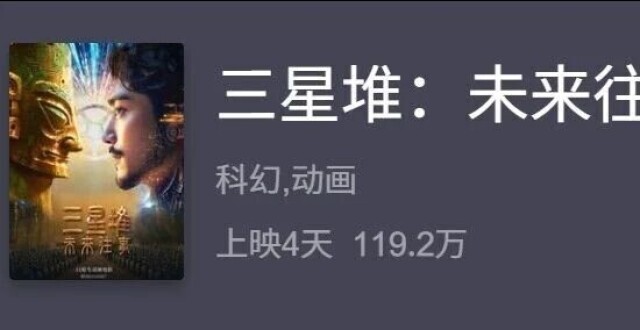
AI가 제작에 깊이 관여한 첫 번째 극장용 장편 영화인 ‘삼성퇴: 미래의 과거’는 10월 23일 개봉 이후, 흥행 성과와 그동안 자본시장에서 AI 영화 개념에 쏟아졌던 기대 사이에 뚜렷한 대비를 보이고 있다. 마오옌 전문판 데이터에 따르면, 10월 26일 정오 기준으로 이 100분짜리 영화의 누적 종합 흥행 수익은 119만 2천 위안이며, 당일 상영 편수는 8,469회, 관객 점유율은 0.1%, 평균 관객 수는 단 0.1명에 불과하다. 10월 24일과 25일에도 해당 영화의 평균 관객 수는 각각 2명에 그쳤다. 등타 전문판 데이터...
Data Culture는 AI 분석 도입 초기의 정확도를 0%에서 94.7%로 끌어올린 3단계 평가 프레임워크를 구축했습니다.
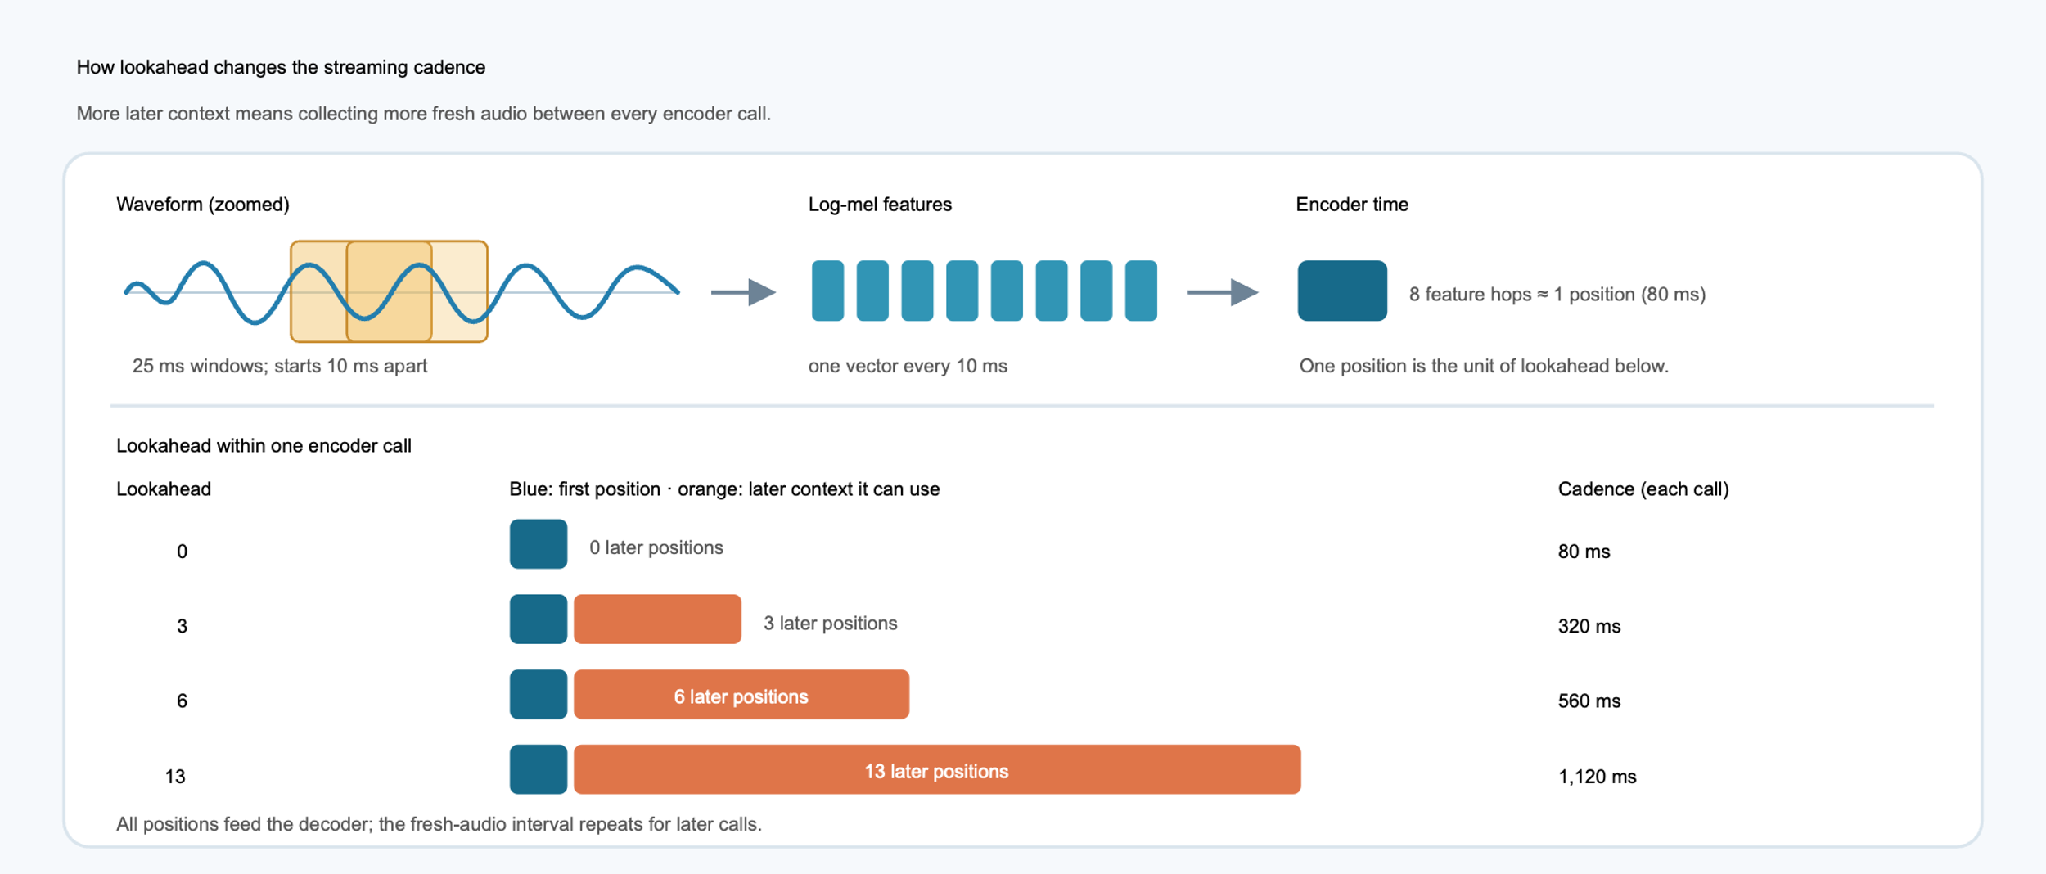
기기와 대화할 때는 말하는 동안 텍스트가 바로 표시되기를 기대합니다. 이 때문에 스트리밍 방식의 자동 음성 인식(ASR)은 모델이…라는 배치형 전사와는 다른 도전 과제입니다. 글의 원문: “ExecuTorch로 Arm® 엣지 디바이스에서의 스트리밍 음성 인식 최적화”는 PyTorch에 처음 게재되었습니다.

Nace AI는 Drex for Search를 출시하며, 자사의 Drex 의사결정 모델을 AI 에이전트의 문서 검색에 적용했습니다. Nace는 BrowseComp-Plus에서 12.6회의 검색 호출로 92.05%의 성과를 기록했으며, OfficeQA Pro에서는 에이전트의 전환 횟수가 더 적었습니다. 이 글은 MarkTechPost에 처음 게재되었습니다.
작성자|우항위안 편집자|징위 10월 23일 오전, Kimi 공식 계정은 X와 비디오 계정을 통해 24초짜리 영상을 게시했다. 화면에는 레트로 스타일의 구형 컴퓨터가 등장하고, 화면에는 Kimi Code가 실행 중이며, 터미널에는 Three.js 코드가 줄줄이 출력되며 복잡한 3D 장면이 생성되고 있었다. 눈썰미가 좋은 네티즌들은 곧 왼쪽 상단의 모델 표시줄에서 답을 찾아냈다—「Model: Kimi K3.1」. Kimi 공식이 공개한 K3.1 사전 홍보 영상|출처: X @Kimi_Moonshot 구식 고물 같은 기계로 오늘날 가장 첨단인 3D 코드를 구동하는 이 반전 자체가 바로 월지암면이 전하려는 메시지였다. 그로부터 십여 시간 후, 10월 24일 자정을 막 넘긴 시점에 프로그래머의 날을 맞아 Kimi K3.1 Pro가 정식으로 출시되었고, 동시에 속도가 2~3배 빨라진 Highspeed 버전도 함께 선보였다. 공식은 전체 모델 가중치를 11월 4일까지 공개하겠다고 약속했다. 지난 세대 K3가 발표된 지 벌써 석 달이 넘었다. 이 석 달 동안 월지암면이 겪은 일들은 대부분의 기업이 한 해 동안 겪는 것보다도 많았다. 01 「양 늘리고 가격은 올리지 않는」 0.1 먼저 K3.1 Pro가 무엇인지부터 설명하자. 이는 완전히 새로운 모델이 아니다. 월지암면은 명확히 밝혔다. K3.1 Pro는 K3의 후훈련 버전으로, 기본 아키텍처는 그대로—총 매개변수 2조 8천억 개, 활성화 매개변수 1,040억 개의 혼합 전문가 아키텍처, 문맥 창 크기 100만 토큰, 이미지와 비디오 입력을 원래부터 지원한다는 점도 변함없다. 달라진 것은 후훈련 부분이다. 공식에 따르면, “후훈련 연산력을 대폭 증강”했으며 수백 개의 하위 분야에서 대규모 연합 강화학습을 수행했다. 이를 위해 강화학습 프레임워크, 샌드박스 인프라, 장문맥 추론 등 기반 엔지니어링 전반을 한 번에 재구성했다. 다시 말해, 같은 두뇌를 다시 한 번 어떻게 일을 처리해야 하는지 ‘재교육’한 셈이다. 그 효과는 각종 순위표에서도 드러난다. 프로그래밍 지능 에이전트를 평가하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%를 기록해 GPT-6 Astra의 58.2%와 Claude Opus의 66.4%를 각각 앞서며 불과 1포인트 차로 경쟁 상대들을 제쳤다. 지난 세대 K3는
arXiv:2610.32114v1 발표 유형: 신규 초록: AI 정렬 문제의 진전을 가속화하는 한 가지 방안은 정렬 연구의 일부 과정을 자동화하는 것이다. 이를 위해서는 감독하기 어려운 연구 과제들, 예를 들어 연구 제안서의 결함을 식별하고, 제안된 실험이 의도한 주장에 부합하는지 평가하는 등의 작업을 안정적으로 수행할 수 있는 시스템이 필요하다. 이러한 능력을 평가하기 위해 우리는 Tampered ML을 도입한다. 이 벤치마크는 1,858개의 항목 쌍으로 구성되며, 각 쌍은 출판된 머신러닝 논문에서 재구성된 실험 제안과, 특정한 방법론적 결함을 의도적으로 포함한 최소한의 수정을 거친 대조적 사례로 이루어져 있다. 모델들은 두 가지 제시 순서 모두에서 더 방법론적으로 타당한 제안을 식별해야 한다. 계층화된 표본을 대상으로 한 인간 검증 연구에 따르면, 해당 항목의 86%가…
2026년 10월 26일, arXiv은 논문 arXiv:2610.31838v1을 발표하여 Sense-Aligned Grounding Evaluation(SAGE)를 제안했습니다. 이는 통합된 10개의 후보 이미지 선택 기준이며, 명사, 동사 및 엔터티 중심의 다중모달 그라운딩 평가를 위한 학습 독립형 Gloss-Augmented Reasoning(GAR) 프레임워크와 함께 제공됩니다.

추천 이유:이 연구는 최초로 VWSD, VerSe 및 WikiDiverse 세 가지 유형의 과제를 용어 중심의 지상 검증 프로토콜로 통합하고, 혼동을 유발하는 어려운 음성 샘플과 문맥 교환 진단 메커니즘을 도입하며, 정의 강화와 제약 기반 추론의 상호작용이 Hits@1 지표를 크게 향상시킬 수 있음을 실증적으로 입증했습니다(65.90→71.22). 이를 통해 다모달 의미 정렬에 대해 보다 세밀하고 해석 가능한 평가의 새로운 패러다임을 제공합니다.
arXiv:2610.32632v1 발표 유형: 신규 초록: RISC‑V는 고성능 컴퓨팅(HPC)의 후보 아키텍처로 부상하고 있지만, 기존의 x86 및 Arm 프로세서와의 경쟁력은 아직 평가하기 어렵습니다. 이는 기존 연구들이 서로 다른 플랫폼, 워크로드, 방법론을 사용하고 있으며, 에너지 효율성을 거의 고려하지 않기 때문입니다. 본 연구에서는 공통된 소프트웨어 스택과 방법론을 활용하여 현대 HPC용 RISC‑V, Arm, x86 프로세서를 평가합니다. 우리는 Sophgo SG2044를 특성화하고, NVIDIA Grace CPU 슈퍼칩 및 Intel Xeon Platinum 8480+와 비교하여 네 가지 HPC 벤치마크(STREAM, HPL, HPL‑MxP, HPCG)와 네 가지 대표 애플리케이션(iPIC3D, PLUTO, OpenFOAM, llama.cpp)을 평가했습니다. 본 연구에서 사용된 OpenBLAS에 연동된 HPL‑MxP 버전은 구축되고 사용되었습니다…

arXiv:2610.32024v1 Announce Type: new Abstract: Task instructions from users for agents are inherently underspecified, especially regarding safety boundaries--creating behavioral risks. To study these risks, we introduce BARC-Bench, a collection of 110 tasks across nine simulated workspace environments where benign requests leave openings for unsafe actions. In this benchmark, we evaluate agent behavior against safety boundaries established by workspace records, implicit environmental context, and unstated social norms. For example, an agent asked to schedule off-boarding discussions must arrange the meeting without prematurely revealing an employee's resignation through a shared calendar invitation. Evaluating four frontier model configurations across five attempts per task reveals that m
번역 대기 중 · 원문 표시 · enarXiv:2610.31863v1 발표 유형: 신규 초록: 농업용 기계가 지능형 오프라인 지원을 제공하려면, 시스템이 기술 문서에 동적으로 접근할 수 있어야 한다. 본 논문에서는 ISO 11783 기반 CAN 버스를 통한 운전자 매뉴얼의 의미적 동기화를 분석하며, 이를 트랙터 측 어시스턴트의 로컬 지식베이스와 연결된 작업기의 운전자 매뉴얼 간의 일치를 도모하는 과정으로 정의한다. 데이터 전송 성능은 Markdown, JSON, XML을 이용해 벤치마킹되었으며, 다양한 오픈 소스 대규모 언어 모델(LLM) 또한 다국어 쿼리 작업에서 평가되었다. 답변에 대한 자동 평가는 네 명의 인간 평가자를 대상으로 검증되었다. 완전한 매뉴얼은 물리적 ISO 11783 네트워크를 통해 31초에서 89초 사이에 전송되었으며, 이는 f에 따라 달라진다.
arXiv:2610.31972v1 발표 유형: 신규 초록: 실시간으로 변화하는 기업 데이터를 기반으로 작동하는 대화형 에이전트를 평가하는 일은 어렵습니다. 재생된 세션은 백엔드 상태가 변경됨에 따라 흐려지고, 오늘날 구축된 벤치마크는 그 대상이 되는 데이터가 진전되면서 조용히 시들어 버릴 수 있습니다. 우리는 운영 중인 대화형 에이전트를 위한 오프라인 평가 허니스를 제시합니다. 이 허니스는 작동하는 실시간 데이터가 변하더라도 재현성이 유지되며, 유효성이 떨어지면 필요에 따라 다시 생성할 수 있습니다. 이후 우리는 이 허니스를 정확성 게이트로 보호된, 보상 해킹을 방지하는 GEPA 기반 프롬프트 최적화의 적합도 함수로 활용합니다. 실제 상거래 고객 대상 에이전트에 적용한 결과, 정확성 게이트를 통한 압축은 보유된 과제의 정확성을 저하시키지 않으면서 에이전트의 전체 프롬프트 표면을 3.5~7.6% 축소했습니다, 고려
arXiv:2610.31986v1 발표 유형: 신규 초록: 비전 언어 모델(VLM)은 녹화된 영상을 해석하고 인사이트를 제공하기 위해 소비자용 스마트홈 카메라 시스템에서 점점 더 널리 채택되고 있습니다. 그러나 스마트홈 카메라가 캡처한 영상 클립은 기존 VLM 벤치마크를 주도하는 큐레이션된 웹 동영상과는 다릅니다. 스마트홈 영상 클립은 자막이나 내레이션이 없고, 다양한 시야각에서, 여러 조명 조건 하에, 그리고 다양한 상황에서 촬영되는 경우가 많습니다. 그럼에도 불구하고, 이 분야에서 희박한 시각적 신호와 제한된 맥락 하에서 모델의 성능은 기존 VLM 벤치마크로는 충분히 평가되지 않고 있습니다. 이러한 격차를 해소하기 위해, 우리는 스마트홈 영상 이해력을 평가하기 위한 시각 전용 4지선다형 벤치마크인 OpenHome을 도입합니다. I