
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

개발자는 AI 시대의 기반 혜택을 어떻게 포착할 수 있을까요? CEIC×1024 선전 특별 행사에서 AI와 홍멍 개발의 신인프라를 해부합니다.

2026년 창사·1024 프로그래머의 날 행사 기간 동안, CEIC 소비자 전자 혁신 컨퍼런스와 CSDN은 선전에서 개발자들을 위한 강력한 기술 축제를 공동으로 개최했습니다. CEIC 조직위원회 상임 부주임 양타오가 인터뷰에서 밝힌 바와 같이: “소비자 전자 분야의 모든 경험 혁신은 결국 우리 프로그래머들이 작성한 코드에서 비롯됩니다.” 현재 기술의 전환점에 있어, 단순한 수기 코드 작성에서부터 지능형 에이전트(Agent)와 풍부한 엣지 측 AP를 활용하는 방식으로...
开发者如何接住AI时代的底座红利?CEIC×1024深圳专场解密AI与鸿蒙开发新基建
진행 상황 및 관련 보도

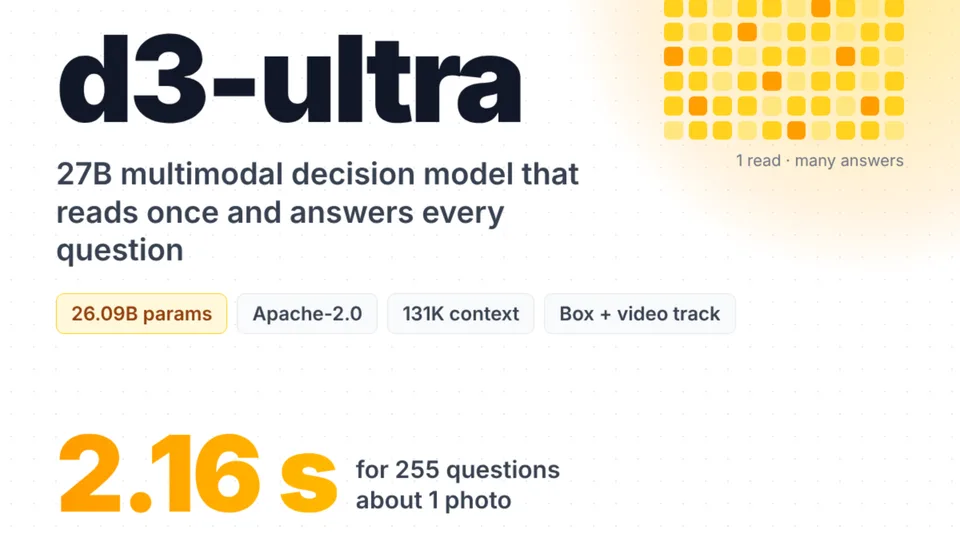
vLLM 시맨틱 라우터, d3-ultra 출시: 27B 규모의 오픈형 멀티모달 의사결정 모델

vLLM 시맨틱 라우터가 27B 규모의 오픈 웨이트 멀티모달 의사결정 모델인 d3-ultra를 출시했습니다. 이 모델은 텍스트, 이미지 및 비디오를 한 번에 처리한 뒤 모든 답변에 대한 확률을 반환하며, 팀의 SR-Text 테스트에서 87.2점을 기록했습니다. 해당 게시물 “vLLM 시맨틱 라우터, 27B 규모의 오픈 멀티모달 의사결정 모델 d3-ultra 출시”는 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

TMA를 언제, 왜 사용해야 하는가: NVIDIA Hopper GPU에서의 텐서 메모리 가속에 대한 워크로드 기반 특성 분석

arXiv:2610.34907v1 발표 유형: 신규 초록: NVIDIA Hopper에서 도입된 텐서 메모리 가속기(TMA)는 실제 생산 환경의 GPU 커널에서 광범위하게 사용되고 있지만, 그 활용은 상당히 선택적입니다. CUTLASS, FlashAttention-3, FlashInfer 등에서 활동하는 전문 커널 개발자들은 커널 내 일부 텐서 피연산자에 대해 TMA를 적용하되, 다른 피연산자에 대해서는 cp.async, 직접 글로벌 로드, 또는 분산 공유 메모리(DSM)로 대체합니다. 벤더 문서에서는 API를 설명하고, 최근의 마이크로벤치마킹 연구에서는 TMA의 처리량을 단독으로 평가하고 있지만, 이러한 접근 방식들은 실무 현장에서 실제로 직면하는 질문에 답하지 못합니다: 커널 내 특정 메모리 피연산자가 주어졌을 때, 이를 TMA로 처리해야 하는지, 그리고 만약 그렇다면 클러스터 멀티캐스트를 함께 사용할 것인지 여부를 결정하는 문제입니다. 우리는 H100을 대상으로 한 워크로드 기반 특성 분석 연구를 통해 이와 같은 간극을 해소하고자 합니다. 우리는 TMA와 다중

진행 상황 및 관련 보도

ASRock 크리에이터 라데온 AI 프로 R9700 리뷰: AMD 스타일의 워크스테이션 추론

오늘은 워크스테이션용 ASRock의 고급형 Radeon AI 추론 카드인 Creator Radeon AI Pro R9700을 살펴봅니다. 32GB의 RAM과 1,700달러의 가격대를 갖춘 이 카드는 로컬 AI 추론을 위한 워크스테이션을 구성하는 데 있어 매우 합리적인 선택입니다. 본 글 ‘ASRock Creator Radeon AI Pro R9700 리뷰: AMD 스타일의 워크스테이션 추론’은 ServeTheHome에 처음 게재되었습니다.

진행 상황 및 관련 보도

블랙스톤의 AI 사업 책임자 자스 카이라: AI 인프라 부채에 대한 우려는 과장되어 있다

블랙스톤의 AI 사업 책임자인 자스 카이라는 테크크런치 디스럽트 컨퍼런스에서, AI 인프라 분야의 막대한 부채에 대한 시장의 공포가 과도하게 확대되었다고 밝혔다. 그의 핵심 논거는 다음과 같다: 해당 부채는 주로 마이크로소프트, 메타 등 신용등급이 높은 고객들과 체결된 장기 계약에 의해 뒷받침되며, 하부 자산(예: GPU 등) 역시 강력한 담보 가치를 지니고 있어 위험 구조가 2008년 은행 시스템과는 본질적으로 다르다는 점이다.

진행 상황 및 관련 보도

VocabX: 비용 가중 어휘 전문화를 통해 도메인 특화 소형 언어 모델의 추론 비용을 77% 절감

Dharma-AI는 VocabX 방법을 제안하여, 포르투갈어 작문 자동 채점과 같은 특정 작업에 맞춰 언어 모델의 어휘표를 재구성함으로써 단어 빈도가 아닌 단어 비용을 최적화 목표로 삼습니다. 모델 구조, 파라미터 또는 학습 프로세스를 수정하지 않은 상태에서, 실험 결과 추론 비용이 77% 감소하는 동시에 평가 점수(bench score)가 0.703에서 0.810으로 향상되었습니다.

진행 상황 및 관련 보도

TorchNeuron 시스템 수준 성능 분석(제1부): AWS Trainium 칩 기반 엔드투엔드 프로파일링

이 글은 Hugging Face와 Amazon이 공동으로 발표한 기술 블로그 시리즈의 첫 번째 편으로, AWS Trainium AI 가속 칩에서 TorchNeuron을 활용한 PyTorch 모델 추론 성능 분석 방법을 체계적으로 소개합니다. 여기에는 Neuron 백엔드 통합 원리, torch.profiler 구성 방법, NeuronConfig 및 NeuronProfiler 도구의 사용법, Neuron Explorer를 이용한 시각적 추적 등이 포함되며, RMSNorm을 사례로 삼아 세 가지 구현 방식(순수 PyTorch, torch.rms_norm 내장형 병합, torch.compile 자동 병합) 간의 장치별 처리 시간 차이를 비교합니다.

진행 상황 및 관련 보도

i14, Laplace 3B 선형 주의 메커니즘 모델 발표: AWS Trainium2와 네이티브 PyTorch를 기반으로 한 고정 상태 메모리 추론 구현

i14는 30.28억 개의 파라미터를 갖는 Laplace 3B 모델을 출시했으며, Softmax 주의 메커니즘을 대체해 게이트 제어 선형 주의(GLA)를 채택했습니다. 이 모델은 추론 시 각 시퀀스의 재귀 상태 크기가 항상 29.5 MB로, 컨텍스트 길이와 무관합니다. 해당 모델은 AWS trn2.48xlarge 인스턴스 한 대(Trainium2 칩 16개 탑재)에서 훈련 및 서비스 검증을 완료했으며, 훈련 처리량은 초당 12만 토큰에 달하고, 서비스 처리량은 초당 11,544 출력 토큰(동시 실행 시퀀스 수 1,280)입니다. 모든 성능 데이터는 i14와 AWS GenAIIC 팀의 내부 실측 결과입니다.

진행 상황 및 관련 보도

SF Compute, 프로그래밍 가능한 데이터센터 구축: 물리적 인도를 기반으로 한 GPU 연산력 거래 시장

SF Compute는 에반 콘래드가 설립한 기업으로, 중립적이고 프로그래밍 가능하며 물리적 인도를 지원하는 GPU 연산력 거래 인프라 구축을 목표로 합니다. 이 회사의 모델은 FLOPS 상품의 추상화를 지양하고 하드웨어의 이기종성, 실제 인도 및 실시간 제약(예: 중단 허용성, InfiniBand 토폴로지, 펌웨어 버전 등)을 강조합니다. 현재까지 수백억 달러 규모의 거래량을 달성했으며, 동적 InfiniBand 서브넷 분할과 같은 기반 기능도 선보였습니다.

진행 상황 및 관련 보도

SF Compute, 프로그래밍 가능한 데이터센터 구축: 물리적 인도를 통해 GPU 연산력 거래의 시장화 촉진

SF Compute는 에반 콘래드가 설립한 기업으로, GPU 연산력에 대한 프로그래밍 가능하고 물리적으로 교환 가능한 거래를 실현하는 데 중점을 두고 있습니다. 이 회사는 자체 데이터센터를 보유하지 않고, 풀스택 기술을 통해 제3자 시설과 협력해 ‘주권형 연산력 클라우드’를 공동 구축하며, 시장 중립성과 인프라의 통제 가능성에 큰 비중을 두고 있습니다. 현재까지 수억 달러 규모의 거래액을 달성했으며, InfiniBand 동적 분할 등 핵심 기능도 실제로 구현했습니다.

진행 상황 및 관련 보도

AnyLanguageModel 1.0 출시: 로컬 및 호스팅 모델을 지원하는 통합 Swift 인터페이스로, Apple 플랫폼의 모든 OS에 완벽히 대응합니다 27

Hugging Face는 AnyLanguageModel 1.0을 정식으로 출시했으며, Apple Foundation Models API와 완전히 호환되는 오픈소스 Swift 프레임워크를 제공합니다. 이 프레임워크는 로컬 모델(MLX, llama.cpp, Core ML)과 호스팅 모델(OpenAI, Anthropic, Gemini, Hugging Face Inference Providers 등) 간의 원활한 전환을 지원하며, 이미지 입력, 도구 호출, 가이드형 생성, 추론 블록 자동 적응 등의 기능도 추가되었습니다.

진행 상황 및 관련 보도

TorchNeuron 공개 베타 출시: Hugging Face 모델이 AWS Trainium의 학습과 추론을 기본 지원

Hugging Face와 AWS가 공동으로 TorchNeuron을 출시했습니다—PyTorch용 원생형 Trainium 백엔드로, 2026년 10월 20일부터 공개 베타 테스트를 시작합니다. 이 기술을 통해 Transformers, Diffusers 등 주요 라이브러리들이 수정 없이 바로 Trainium 칩에서 실행될 수 있게 되어, 텍스트 생성 및 이미지 생성 모델의 사용 편의성과 호환성을 크게 향상시킵니다.

진행 상황 및 관련 보도