
NVIDIA DGX Spark에서 MoE 추론을 향상시키는 3가지 방법
토큰을 더 빠르게 생성하려면 먼저 추론 성능을 제한하는 요인을 파악하는 것부터 시작합니다. NVIDIA에서 Inclusion AI의 Ling-3.0-flash를 대상으로 한 배치 크기 1 평가에서는...
출처, 주제, 시간으로 전체 뉴스에서 관심 소식을 찾아보세요.
토큰을 더 빠르게 생성하려면 먼저 추론 성능을 제한하는 요인을 파악하는 것부터 시작합니다. NVIDIA에서 Inclusion AI의 Ling-3.0-flash를 대상으로 한 배치 크기 1 평가에서는...
Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 개발한 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.
구 버전 순위의 점수는 만점에 근접했지만, 신규 버전의 실전 성적은 집단적으로 낙제점을 기록했다. 대형 모델 평가 자체가 하나의 비즈니스로 전환되면서, 기업들의 선택 기준은 이제 순위를 보는 데서 비용 계산으로 옮겨가고 있다.
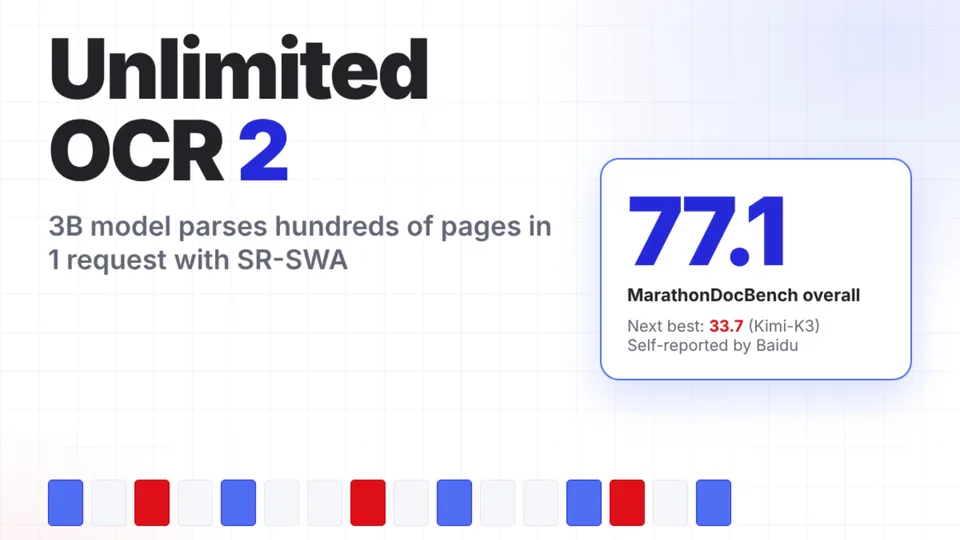
바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.
AI가 제작에 깊이 관여한 첫 번째 극장용 장편 영화인 ‘삼성퇴: 미래의 과거’는 10월 23일 개봉 이후, 흥행 성과와 그동안 자본시장에서 AI 영화 개념에 쏟아졌던 기대 사이에 뚜렷한 대비를 보이고 있다. 마오옌 전문판 데이터에 따르면, 10월 26일 정오 기준으로 이 100분짜리 영화의 누적 종합 흥행 수익은 119만 2천 위안이며, 당일 상영 편수는 8,469회, 관객 점유율은 0.1%, 평균 관객 수는 단 0.1명에 불과하다. 10월 24일과 25일에도 해당 영화의 평균 관객 수는 각각 2명에 그쳤다. 등타 전문판 데이터...
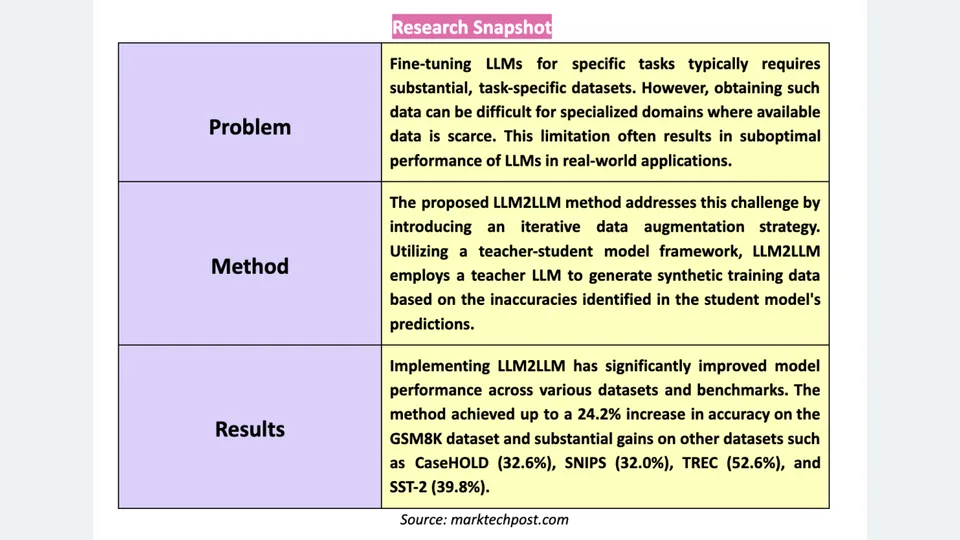
Data Culture는 AI 분석 도입 초기의 정확도를 0%에서 94.7%로 끌어올린 3단계 평가 프레임워크를 구축했습니다.
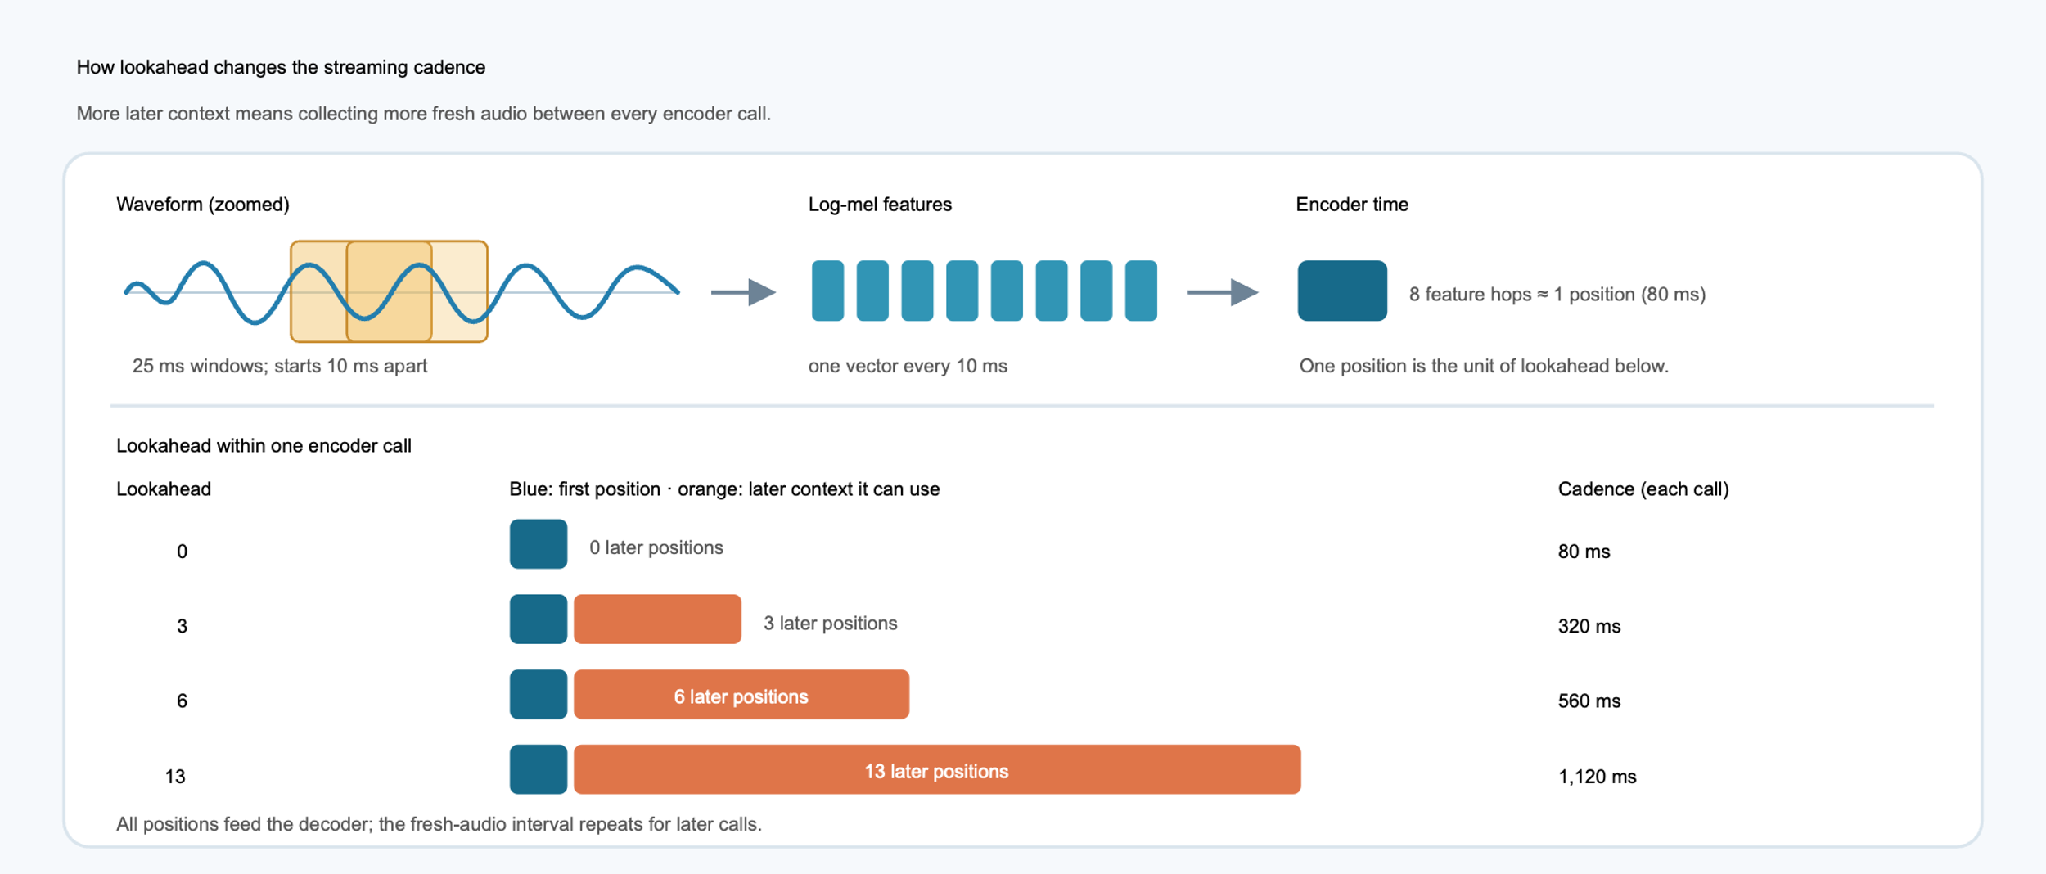
기기와 대화할 때는 말하는 동안 텍스트가 바로 표시되기를 기대합니다. 이 때문에 스트리밍 방식의 자동 음성 인식(ASR)은 모델이…라는 배치형 전사와는 다른 도전 과제입니다. 글의 원문: “ExecuTorch로 Arm® 엣지 디바이스에서의 스트리밍 음성 인식 최적화”는 PyTorch에 처음 게재되었습니다.

AWS는 2026년 10월 26일 블로그를 통해, AWS CDK를 활용해 구축한 엔터프라이즈급 에이전트 기반 검색(Agentic Retrieval)의 참조 구현을 소개했습니다. 이 솔루션은 Amazon Bedrock의 관리형 지식 베이스(Managed Knowledge Base)에 특화되어 있으며, 지식 베이스 간의 시맨틱 라우팅, 반복적 검색, 인용 정보를 포함한 출처 추적 답변 및 7계층 관찰성을 지원합니다.
추천 이유:이 자료는 AWS 공식 기술 블로그(2026년 10월 26일 게시)에 실린 것으로, 2024년 8월에 출시된 관리형 KB 및 AgenticRetrieveStream API와 같은 이미 제공되는 기능, 네 스택 CDK 애플리케이션과 같은 검증 가능한 배포 구조, 지역별 이용 가능성 및 관리형 KB에만 한정된 사용 제한 등 명확한 제약 사항, 그리고 오픈소스 구현 세부사항에 초점을 맞추고 있습니다. 성능에 관한 단언이나 제3자에 의한 신뢰성 보증은 포함되어 있지 않으며, 사실성과 시의성을 충족합니다.
Nace AI는 Drex for Search를 출시하며, 자사의 Drex 의사결정 모델을 AI 에이전트의 문서 검색에 적용했습니다. Nace는 BrowseComp-Plus에서 12.6회의 검색 호출로 92.05%의 성과를 기록했으며, OfficeQA Pro에서는 에이전트의 전환 횟수가 더 적었습니다. 이 글은 MarkTechPost에 처음 게재되었습니다.
작성자|우항위안 편집자|징위 10월 23일 오전, Kimi 공식 계정은 X와 비디오 계정을 통해 24초짜리 영상을 게시했다. 화면에는 레트로 스타일의 구형 컴퓨터가 등장하고, 화면에는 Kimi Code가 실행 중이며, 터미널에는 Three.js 코드가 줄줄이 출력되며 복잡한 3D 장면이 생성되고 있었다. 눈썰미가 좋은 네티즌들은 곧 왼쪽 상단의 모델 표시줄에서 답을 찾아냈다—「Model: Kimi K3.1」. Kimi 공식이 공개한 K3.1 사전 홍보 영상|출처: X @Kimi_Moonshot 구식 고물 같은 기계로 오늘날 가장 첨단인 3D 코드를 구동하는 이 반전 자체가 바로 월지암면이 전하려는 메시지였다. 그로부터 십여 시간 후, 10월 24일 자정을 막 넘긴 시점에 프로그래머의 날을 맞아 Kimi K3.1 Pro가 정식으로 출시되었고, 동시에 속도가 2~3배 빨라진 Highspeed 버전도 함께 선보였다. 공식은 전체 모델 가중치를 11월 4일까지 공개하겠다고 약속했다. 지난 세대 K3가 발표된 지 벌써 석 달이 넘었다. 이 석 달 동안 월지암면이 겪은 일들은 대부분의 기업이 한 해 동안 겪는 것보다도 많았다. 01 「양 늘리고 가격은 올리지 않는」 0.1 먼저 K3.1 Pro가 무엇인지부터 설명하자. 이는 완전히 새로운 모델이 아니다. 월지암면은 명확히 밝혔다. K3.1 Pro는 K3의 후훈련 버전으로, 기본 아키텍처는 그대로—총 매개변수 2조 8천억 개, 활성화 매개변수 1,040억 개의 혼합 전문가 아키텍처, 문맥 창 크기 100만 토큰, 이미지와 비디오 입력을 원래부터 지원한다는 점도 변함없다. 달라진 것은 후훈련 부분이다. 공식에 따르면, “후훈련 연산력을 대폭 증강”했으며 수백 개의 하위 분야에서 대규모 연합 강화학습을 수행했다. 이를 위해 강화학습 프레임워크, 샌드박스 인프라, 장문맥 추론 등 기반 엔지니어링 전반을 한 번에 재구성했다. 다시 말해, 같은 두뇌를 다시 한 번 어떻게 일을 처리해야 하는지 ‘재교육’한 셈이다. 그 효과는 각종 순위표에서도 드러난다. 프로그래밍 지능 에이전트를 평가하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%를 기록해 GPT-6 Astra의 58.2%와 Claude Opus의 66.4%를 각각 앞서며 불과 1포인트 차로 경쟁 상대들을 제쳤다. 지난 세대 K3는
AI 스타트업 Recursive는 오픈소스 코딩 모델 Flint를 출시했으며, 개발 과정의 대부분이 자체 개발한 AI 연구 시스템 Eureka Machine에 의해 이루어졌다고 밝혔다. 이 모델은 파라미터 수가 400억 개에 불과하며, 실제 테스트에서 활성화 수는 25억 개로 확인되었고, M4 Pro MacBook과 같은 일반 노트북에서도 오프라인으로 실행 가능하다. 추론 속도는 초당 131 토큰에 달하며, SWE-Bench 등 벤치마크 테스트에서 동급 규모의 대부분 모델보다 우수한 성능을 보였다.
NVIDIA는 사전 훈련된 관계형 기반 모델인 Kumo Relational을 출시했으며, 이 모델은 기업용 관계형 데이터베이스에서 이탈 예측, 사기 탐지, 수요 예측 등 다양한 예측 작업을 직접 수행할 수 있습니다. 작업 미세조정, 특성 엔지니어링 또는 테이블 평탄화가 필요하지 않습니다. 15개 데이터베이스에 걸친 41개의 벤치마크에서 XGBoost 등 감독 학습 모델을 전면적으로 능가했으며, SAP SALT 기업 벤치마크에서는 MRR 지표에서 AutoGluon보다 8% 앞섰습니다. 또한 5,000억 행 규모의 데이터베이스를 지원하며, Predictive Query Language(PQL)를 통해 코드 없이 예측 호출을 구현할 수 있습니다.
IBM 연구소는 ALTK-Evolve 방법을 제안했으며, GPT-4.1을 활용해 자체 작업 흐름에서 신원 인증, 환불 확인 등과 같은 구조화된 행동 지침을 자동으로 도출하고, 이를 순수 프롬프트 엔지니어링 방식으로 ReAct 에이전트 시스템에 주입함으로써 모델 가중치를 업데이트하거나 인간의 라벨링에 의존하지 않고도 고객 서비스 과제의 정확도와 신뢰성을 크게 향상시켰다. 또한, 이 기술의 리테일 분야 버전은 67.5%의 Pass⁴ 점수로 τ²-bench 2026년 10월 12일 기준 순위 1위를 차지하며, 모든 최첨단 모델 및 미세 조정 시스템을 능가했다.
Learn how OpenAI is improving ChatGPT across low-resource programming languages, with new evaluations for software engineering, SQLite, and COBOL migration.
번역 대기 중 · 원문 표시 · enWe’re launching ReviewBench, a benchmark for code review agents built on representative GitHub pull requests, multi-source ground truth, calibrated evaluation, and production-aligned metrics. The post ReviewBench: An open benchmark for AI code review appeared first on The GitHub Blog.
번역 대기 중 · 원문 표시 · enTTS 리더보드 열기: 다국어 텍스트로 변환할 수 있는 평가 및 Voice Cloning
MentalHealthBench는 현실적인 정신 건강 대화의 맞은편에 도움과 안전한 AI 응답을 평가하는 포괄적인 벤치 마크입니다.
영국 AISI 및 EvalEval은 벤치 마크 결과 재현성
OpenAI는 안전성을 높이기 위해 평가, 보고 및 거버넌스의 조정을 촉구하며, 글로벌 AI 표준 공유를 위한 로드맵을 제시합니다.
오픈 ASR 리더보드는 첫 번째 글로벌 South Language를 추가합니다