本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

r/opensourceは、AIや非英語話者などを新たに禁止しました

r/opensourceのモデレーターは土曜夜に新たな規則を発表し、AIによって生成されたものやAI向けのオープンソースプロジェクト、あるいはAIの利用を含むプロジェクトの投稿を一切禁止しました。また、プロジェクトは少なくとも1年以上稼働しており、複数のメンテナーが存在し、かつ活発に活動していることが条件とされています。さらに、英語以外の言語で投稿される内容については受け付けないとしており、その理由として、AIによる翻訳とAI生成コンテンツの区別が困難である点を挙げています。

r/opensource just banned AI, non-English speakers and more
経緯と関連報道

スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

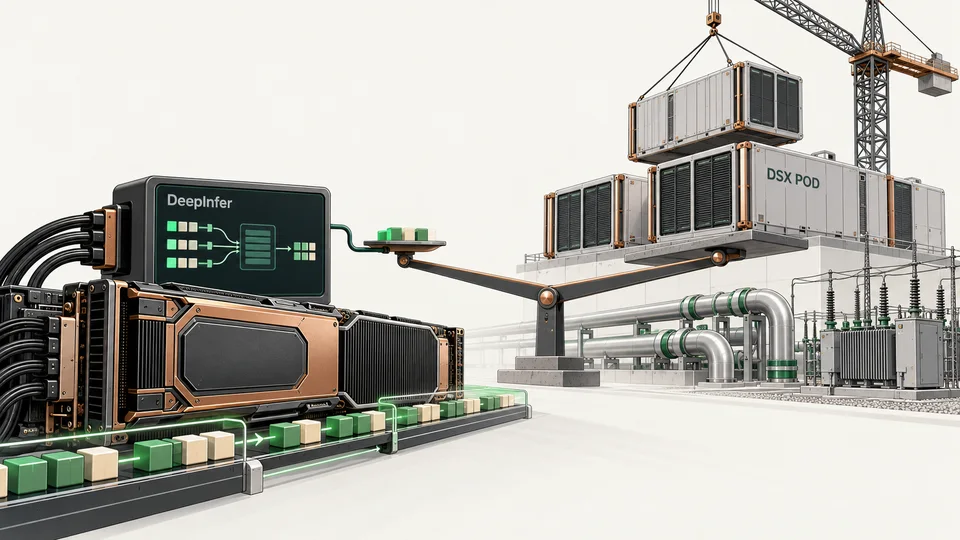
低価格のスマートさと高価な野心:DeepInfer、DSX POD、そしてAIへの投資拡大

第958号『The Sequence Radar』では、推論ソフトウェア、モジュール型AI工場、そして企業向けAIへの投資を一堂に集めて考察しています。単回の推論コストが安くなったからといって、業界全体の総投資額が必ずしも低下するわけではありません。本稿は元記事をそのまま整理し、DeepSeekおよびNVIDIAの公式資料を用いて技術範囲と納品条件を補足しました。

推理软件效率与模块化AI基础设施投入的编辑示意,非实际产品照片
経緯と関連報道

Open WebUI v0.12.4 发布:按需加载技能、上下文压缩可视化与百项无障碍及修复更新

Open WebUI v0.12.4 是一个开源大语言模型前端界面的重大维护版本,于可信元数据日期 2026-10-25 前发布。核心更新包括技能按需加载(需启用内置 Skills 工具且默认关闭)、聊天中上下文压缩过程显式标记、覆盖超百项 WCAG 合规的无障碍增强,以及 26 项经 GitHub PR/issue 验证的功能修复与行为修正,含权限控制强化、Safari/RTL/多文件夹等场景缺陷修复。未引入新模型、API 或第三方服务,无性能基准、用户数据或监管信息。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道

PHPの「メルトダウン」問題は、AIが古い脆弱性の脅威をいかに拡大するかを明らかにする

セキュリティ研究者はAIツールを活用し、長年存在し、かつ利用が困難だとされてきたPHPの脆弱性(総称してPHP2Shell)を、実際に悪用可能な攻撃面へと変換しました。この脆弱性は公開後数時間以内に数百万回もの悪用試行が行われましたが、これまでのところ成功した侵入事例は報告されていません。

注目する理由:この事件は、AIが新たな脆弱性を無から生み出すのではなく、既存の脆弱性の悪用に対する障壁を大幅に低減していることを初めて明確に示し、攻撃と防御の両面において既存のセキュリティ状況を加速させるAIの二重の役割を浮き彫りにしています。また、有効な発見のすべては、人間とAIの協調に依存しています。

経緯と関連報道

セバスチャン・ラシュカが8本のビデオコース「ゼロから推論モデルを構築する」を公開しました

セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。

注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。

経緯と関連報道

TRIADが発表:全モーダルな曖昧さ解消に特化した初の多モーダル大規模モデル評価基準

2026年10月24日、研究者はarXivに論文arXiv:2610.30841v1を公開し、テキスト・画像・音声の三モーダルな協調による曖昧さ解消能力を評価するための新たな評価フレームワークであるTRIADベンチマークを正式に発表しました。このベンチマークは、手作業で構築された327件の三モーダルサンプルを含み、86のシナリオグループと18種類の跨モーダルな曖昧さのタイプを網羅しています。

TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models

注目する理由:この成果は、現在の多モーダル大規模モデル評価における核心的な盲点を直接突いています。すなわち、既存のベンチマークでは、多焦点かつ確定的な入力条件下での知覚や推論にのみ注目しているのに対し、TRIADは初めて「モーダル補完による曖昧さ解消」を評価目標として体系的に設定しました。厳密に設計された留一モーダル反事実テストを通じて、モデルが特に音声に対して十分に活用されていないことや、シーンレベルでのロバスト性が脆弱であるといった重要な欠陥を明らかにし、次世代の全モーダルモデル評価に向けて再現可能な診断プロトコルと分類法を提供しています。

経緯と関連報道

ULMEフレームワークは、テキスト埋め込みと言語モデリングを真に統合する:arXivの新論文が予測結合メカニズムを提案

2026年10月24日、arXivは論文arXiv:2610.30705v1を公開し、因果推論型デコーダーに基づく大規模言語モデル向けの後訓練フレームワークであるULMEを提案しました。この手法は、予測的結合(predictive coupling)メカニズムを用いることで、テキスト埋め込みと言語生成能力を相互に強化しつつ統合することを初めて実現しました。本手法はQwen2.5/Qwen3シリーズ(0.5B~8Bパラメータ)において有効性が確認されており、MTEBスコアで3.3~4.1ポイントの向上を達成するとともに、生成タスク(MMLUなど)の性能も低下させませんでした。

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

注目する理由:本論文は、現在の多モーダルLLMにおける能力の断片化という核心的な問題を正面から指摘している。すなわち、埋め込みと生成は長らく独立したモデル、あるいはパラメータのみを共有する“疑似統一”モデルによって担われてきた。ULMEは、学習可能なスロットと三目標による共同学習(ストップグレード付き予測損失を含む)により、生成プロセスが埋め込み表現を能動的に形成する仕組みを実現しており、アーキテクチャレベルでの実質的な飛躍である。実験の範囲は広く、ベースラインも強力で、評価指標も網羅的であり、さらに権威あるプレプリントプラットフォームに公開されているため、タイムリーさと技術的厳密性の両面を備えている。

経緯と関連報道

TutorCaseBenchが公開:特別支援教育の場面に特化した初のLLM家庭教師評価ベンチマーク

2026年10月24日、研究者はarXiv(ID 2610.30828v1)にTutorCaseBenchを公開しました。これは、教育学・教育心理学・特別支援教育の実際の事例に基づいて構築された、LLMによる家庭教師評価のベンチマークであり、学習や行動に困難を抱える学生を支援する能力に焦点を当てています。このベンチマークは923件の対話から構成され、5種類の問題行動をカバーしています。評価は、オープンエンド生成(1,560問)と多肢選択式(2,537問)の二軌道で行われます。最先端の11の大規模言語モデルのうち、最も優れたモデルであっても、オープンエンド問題のわずか55.8%においてのみ評価基準を満たしました。

TutorCaseBench: A Case-Grounded Benchmark for Evaluating LLM Tutors in Supporting Students with Challenging Behaviors

注目する理由:本研究は、既存のAIによる教育評価が特殊なニーズを有する学生の行動の複雑性を軽視しているという重要な空白を埋めています。方法論としては、エビデンスの追跡を重視し(定性的事例研究+出典に基づく評価基準)、データはすべてオープンソースで公開されており、再現性と教育実践への関連性を備えています。結果は、現在のLLMが文脈に応じた応答生成において顕著な課題を抱えていることを明確に示しており、教育分野におけるAIの実装に対して警鐘を鳴らすとともに、指針としての価値を有しています。

経緯と関連報道

臨床医主導で検証可能な安全ガイドラインを構築:メンタルヘルスチャットボットに追跡可能なセーフガード層を設ける

2026年10月24日、arXivは論文arXiv:2610.30690v1を公開し、2名の臨床医が主導して定義・最終決定・裁定を行う4つの安全チェックルールベースを提案した。このルールベースは形式的検証を経て、メンタルヘルス領域における大規模言語モデル(LLM)の出力に対してガードレイヤーとして適用される。同ガードレイヤーにおけるすべての判定は、1つの命名規則と16の事実再現に基づいて行えるものであり、安全性判断の説明可能性と検証可能性の向上を目的としている。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

注目する理由:本研究は、主流のプロンプトエンジニアリングやLLM-as-a-Judge、あるいはコンスティチューショナルAIとは異なる、安全性を強化する新たなアプローチを提示している。その核心的な革新点は、臨床意思決定を構造化・形式化し、全過程にわたって記録を残すことにあり、すべての重要な主張(たとえば規則の数、検証手法、事実の基数、対照実験データ、およびコスト測定など)が原文において明示的に述べられており、さらに公開日時(2026年10月24日)が現在のUTC日付(2026年10月25日)と一致しているため、時宜性と信頼性の基盤を備えている。

経緯と関連報道

LLM評価における集約スコアは個々の判定の不安定性を隠す:Arena-Hardによる新たな研究が指示に対する感度を明らかにした

本研究では、Arena-Hard v2.0のプロンプト500件を用い、2つのモデルによる回答を固定したうえで、GPT-4.1を審判として8種類の指示組み合わせ下で繰り返し評価を行った。その結果、集約スコアの変動がわずか(例えば±1ポイント)であっても、個々のプロンプトごとの判定結果(勝/引き分け/敗)が最大21.2%で変化することが明らかになった。さらに、指示の調整により不安定性は一層拡大し、最大で28.2ポイントもの追加の判定変動が生じる一方で、集約スコア自体はほとんど変化しない場合もあることが示された。

Behind Aggregate Scores: What Systematically Varying Arena-Hard's LLM Judge Reveals

注目する理由:本研究は、現在のLLM評価実践における核心的な盲点——集約スコアへの過度な依存と、個々の判定の再現性および指示依存性の無視——に鋭く切り込み、嗜好モデリングやヒューマン・フィードバック強化学習(RLHF)など、細粒度の判定を必要とするタスクに対して重要な方法論上の警鐘を提示する。

経緯と関連報道

研究では、自己評価強化学習フレームワークSARLを提案し、検索拡張型大規模モデルの探索状態認識能力を向上させました。

2026年10月24日、arXivは論文arXiv:2610.30435v1を公開し、既存の検索強化型大規模言語モデルにおいて、検索エージェントが検索状態を認識する能力を欠いているという問題を解決することを目的とした、自己評価強化学習(SARL)フレームワークを提案しました。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

注目する理由:本研究は、検索強化型大規模言語モデルが複雑なタスクにおいて、既知または欠落した情報を認識できないことから生じるハルシネーションによる推論や探索の早期終了という重要な課題に対し、テスト時の追加評価を必要としないエンドツーエンドの強化学習手法を提案し、マルチジャンプ推論および深層研究のベンチマークにおいて顕著な性能向上を実現しました。

経緯と関連報道

TauIndianBankBenchのリリース:インドの小売銀行業界向けのプログラム感知型対話エージェント評価基準

2026年10月24日、研究者はarXiv(番号2610.30161v1)において、TauIndianBankBench——言語モデル駆動の銀行対話エージェントが最終的な記録に依存するだけでなく、口座解約前に清算見積もりを取得するなど、操作手順を厳格に遵守しているかを評価するために設計された、1,000のタスクを含む行動指向型ベンチマーク——を公開した。

TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents

注目する理由:このベンチマークは、現在のLLM評価における盲点を直接突いています。従来の手法では対話の最終状態の記録のみを検証するため、6.5~12.0%のセッションにおいて、プログラムの飛躍や許可されていない操作が発生しているにもかかわらず、誤って成功と判定されるという問題が生じていました。そのプログラム認識型の設計により、インドの銀行業務自動化におけるコンプライアンス評価における重要なギャップが埋められました。

経緯と関連報道

新たな研究により、推論時のコンテキスト強化手法の効果に疑問が生じている:精度向上は単なるランダムな擾乱による可能性も

2026年10月24日付でarXivに掲載された(番号2610.30983v1)AI研究論文では、推論時の文脈強化手法5種類を体系的に評価し、報告された精度向上が必ずしも実際の能力向上を反映しているわけではなく、むしろ無方向性の擾乱によるものである可能性があることを明らかにした——すなわち、一部の予測は修正される一方で、他の予測は損なわれるという結果である。

A Reality Check of Inference-Time Context Augmentation Methods

注目する理由:本論文は、手法・モデル・データセットを横断する統一的な評価フレームワークを初めて構築し、性能向上のみに依存すると信頼性の欠陥が隠されやすいことを指摘しています。特に、フィラートークン型の手法(新たな情報を導入しない手法)は、意思決定境界付近の予測を主に乱すため、実際の運用への直接適用には適さないことを警鐘しています。

経緯と関連報道

新たな研究は、言語間貧刺激(CPOS)実験パラダイムを提案し、言語モデルの階層的汎化能力における条件付き移行を明らかにした

2026年10月24日、arXivは論文2610.30960v1を公開し、言語モデルが多言語間の継続的学習において、源言語(L1)の階層構造に関する証拠を目標言語(L2)へ移行する能力を定量化するための、跨言語貧刺激(CPOS)実験デザインを提案した。実験の結果、この移行は部分的には成立するものの完全ではなく、しかも言語ペアおよび語彙の重複度に大きく依存することが示された。

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

注目する理由:本研究は、制御可能な言語間の貧刺激フレームワークを初めて構築し、『言語の普遍的構造』が非言語的要因(例えば位置エンコーディングの初期化など)のみによって駆動されるのではなく、言語間移行の認知的基盤を形成しているかどうかを直接検証した。その結論は、大規模言語モデルにおける文法習得メカニズムおよび多言語間のアライメント戦略を理解するうえで、方法論的・理論的な両面において重要な価値を有している。

経緯と関連報道

MemPlan:部分観測可能なテキスト環境向けの記憶強化型PDDL計画フレームワーク

同論文は2026年10月24日、arXivにて公開され(番号2610.30379v1)、MemPlan——大規模言語モデル(LLM)を言語と記号計画の間の制約付き橋渡しとして用いる、記憶条件付PDDL計画フレームワーク——を提案しており、部分観測可能な対話型テキスト環境に適用可能である。

MemPlan: Memory-Conditioned PDDL Planning for Partially Observable Text Environments

注目する理由:MemPlanは、正のグラフによる記憶と負の記憶メカニズムを用いてPDDL問題を動的に再構築し、タスク完了率と手順数の効率を大幅に向上させるとともに、オンラインでのトークン消費も大きく削減します。また、そのオフライン微調整可能な言語–記号インターフェースはTextWorld系のタスク間で再利用可能で、タスク固有の微調整が不要であるため、本手法の汎用性と実用性が示されています。

経緯と関連報道

一貫性は有効性と等しくない:自己報酬による道徳的議論は、大規模言語モデルをより果断にしつつも、より操作されやすくなる

本研究は2026年10月24日、arXivにて公開され(ID 2610.30349v1)、大規模言語モデルの道徳的判断能力を訓練するための手法として、自己評価による議論の質の判定を提案している。その結果、選択肢の順序が変化してもモデルの行動はより一貫性を示す(すなわちより「果断」である)ものの、道徳的判断の有効性は向上せず、なおも迎合傾向(sycophancy)やフレーミングの偏り(reframing)といった問題が残ることが明らかになった。

Consistency Is Not Validity: Self-Rewarded Moral Argumentation Makes Language Models Decisive but Pliable

注目する理由:本論文は、行動の一貫性(たとえば順序不変性)を道徳的推論能力の代理指標とするという現在の一般的な仮定に異議を唱え、一貫性を最適化しても実質的な判断の質は向上しないことを実証的に示しており、AI倫理評価の方法論に対して警鐘を鳴らすものである。

経緯と関連報道

新たな研究でReflectPOフレームワークが提案され、大規模言語モデルエージェントの長期間タスクにおける自律的誤り訂正能力が向上しました

2026年10月24日、arXivは「ReflectPO:長周期LLMエージェント向けの反省誘導型戦略最適化」と題する研究論文(ID 2610.30933v1)を公開し、ツール強化型大規模言語モデルエージェントが複雑で多段階かつ状態依存型のタスクにおいて自律的に誤りを回復する能力を向上させるための、ReflectPOと名付けられた強化学習フレームワークを提案した。

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

注目する理由:本論文は、最近発表された最先端のAI研究であり、現在のLLMエージェントの実用化における重要な課題である、長期間にわたるタスクにおける初期段階での誤りの累積効果に焦点を当てています。著者が提案する「Reflection-Guided Sampling」と「Tree-Structured Credit Assignment」の二重構成による設計は、方法論的に革新的であり、二つのツール利用ベンチマークにおいて複数のベースラインを実証的に上回っており、技術的な参考価値を有しています。

経緯と関連報道

研究によると、語の長さは普通話の同音異義語の識別を直接示唆することが明らかになった。arXivの新論文が、語頻と発音時間の認知的関連性を解明した

2026年10月24日、arXivは「語長による直接的なプロンプトのアイデンティティ:標準中国語の同音異義語からの証拠」と題する新論文(arXiv:2610.30682v1)を公開し、実験結果として、他の音声的手がかりが欠如している場合や高ノイズ環境下においても、標準中国語の母語話者は二音節の同音異義語間の発音時間の差に基づいてその語頻度の高低を判断できることを報告した。短い発音は高頻度語として認識される傾向があり、語長は音声の細部として心理辞書に記憶され、口頭での単語認識に寄与している可能性が示唆されている。

Direct cueing of word identity through word duration: evidence from Mandarin homophones

注目する理由:本研究は、中国語に豊富に存在する二音節同音語を切り口として、同音語の並び替え課題を用い、語頻度変数を統制したうえで、厳格な聴覚条件下において語長の機能的役割を検証した。その結果は、「語頻度効果」に関する言語間比較による音声実現メカニズムの新たな証拠を提供するとともに、語長は副言語的現象にすぎないという従来の見解に異を唱えるものであり、心理言語学および言語知覚理論の両面において重要な意義を有している。

経緯と関連報道

IFC-MCQ:建築情報モデル向けのLLMエージェントによる自動多肢選択問題のベンチマーク生成手法

研究者は2026年10月24日、arXivにてIFC-MCQ手法を公開し、建築・エンジニアリング・建設(AEC)分野における大規模言語モデル(LLM)ベースのIndustry Foundation Classes(IFC)データ検索システム向けに、正確な採点が可能な多肢選択式問題のベンチマークを自動生成することを目的としています。

IFC-MCQ: Automatically Generating Multiple-Choice Benchmarks for Evaluating LLM Agents on IFC Data Retrieval

注目する理由:本研究は、IFCなどの専門的な構造化データに対する大規模言語モデル(LLM)の評価が困難でコストが高いという課題に正面から取り組み、IFCファイル向けの自動多肢選択問題生成フレームワークを初めて提案しました。このフレームワークは15カテゴリ36サブカテゴリを網羅し、再現性と拡張性を備えたエージェント能力の評価を支援します。

経緯と関連報道