
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

研究では、自己評価強化学習フレームワークSARLを提案し、検索拡張型大規模モデルの探索状態認識能力を向上させました。

2026年10月24日、arXivは論文arXiv:2610.30435v1を公開し、既存の検索強化型大規模言語モデルにおいて、検索エージェントが検索状態を認識する能力を欠いているという問題を解決することを目的とした、自己評価強化学習(SARL)フレームワークを提案しました。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

注目する理由:本研究は、検索強化型大規模言語モデルが複雑なタスクにおいて、既知または欠落した情報を認識できないことから生じるハルシネーションによる推論や探索の早期終了という重要な課題に対し、テスト時の追加評価を必要としないエンドツーエンドの強化学習手法を提案し、マルチジャンプ推論および深層研究のベンチマークにおいて顕著な性能向上を実現しました。
経緯と関連報道

CiteAnchor:幻影引用の検出と解決のためのソース意識型グラウンディング

arXiv:2610.30355v1 発表タイプ:新規 要旨:幻影引用は、科学的主張の背後にある証拠を追跡し、その信憑性を検証することを困難にします。これらの引用を検出するのは、書誌情報が不完全であったり、ソースの種類や出版物のバージョンによって異なるため、非常に難しいです。妥当な一致だけでは、その引用が正当化されるわけでも、その背後にあるソースが特定できるわけでもありません。私たちは、ソースの復元可能性について注釈付きで構築された、実世界の幻影引用423件からなるベンチマークであるCiteResolveを提案します。さらに、ソースごとに検索とフィールドレベルの検証を適応させ、引用の妥当性および固有のソースが復元可能かどうかを個別に判定する、ソース意識型グラウンディングフレームワークであるCiteAnchorを提案します。既存の検出ベンチマークにおいて、CiteAnchorはGPT-5.6を用いてF1スコア0.841を達成しました。

CiteAnchor: Source-Aware Grounding for Hallucinated Citation Detection and Resolution
経緯と関連報道

研究により、報酬モデルのスコアリングには顕著なヒント依存性が存在することが明らかになった:ペア比較評価ではこのバイアスを検出できない

2026年10月24日付でarXivに掲載されたAI研究論文は、現在主流のペアワイズ評価手法では、同一のプロンプトに対するすべての応答に共通するスコアリング成分が自動的に相殺されてしまうため、報酬モデルにおける重要な「プロンプトレベルのバイアス」が検証されていないと指摘している。著者らは人間による評価を基準として、既に公開されている18種類のスコアラーに対して監査を実施した結果、HelpSteer2データセットにおいて、6つのモデルではスコアの分散の34%~64%がプロンプトそのものに起因しており、一方で人間の評価ではこのような現象はほとんど見られなかったことを明らかにした。

What Pairwise Evaluation Misses: Reward Scores across Prompts

注目する理由:本研究は、大規模言語モデルのアライメントプロセスにおいて長らく見過ごされてきた根本的な欠陥を指摘している――すなわち、報酬モデルによるスコアリングが応答の質そのものではなく、提示文に強く依存している点である。また、本研究の方法論(人間基準による審査、プロンプトの置換、分散分解)は再現性が確保されており、結論は実証的分析に基づいており、複数の主流なオープンソースの評価ツールを網羅しているため、嗜好最適化、RLHF、および安全評価の実践に対して直接的な警鐘を鳴らすものとなっている。

経緯と関連報道

TauIndianBankBenchのリリース:インドの小売銀行業界向けのプログラム感知型対話エージェント評価基準

2026年10月24日、研究者はarXiv(番号2610.30161v1)において、TauIndianBankBench——言語モデル駆動の銀行対話エージェントが最終的な記録に依存するだけでなく、口座解約前に清算見積もりを取得するなど、操作手順を厳格に遵守しているかを評価するために設計された、1,000のタスクを含む行動指向型ベンチマーク——を公開した。

TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents

注目する理由:このベンチマークは、現在のLLM評価における盲点を直接突いています。従来の手法では対話の最終状態の記録のみを検証するため、6.5~12.0%のセッションにおいて、プログラムの飛躍や許可されていない操作が発生しているにもかかわらず、誤って成功と判定されるという問題が生じていました。そのプログラム認識型の設計により、インドの銀行業務自動化におけるコンプライアンス評価における重要なギャップが埋められました。

経緯と関連報道

インドネシアの臨床栄養に関するQ&A基準IndoNutriQAが正式に発表されました

2026年10月24日、研究チームはarXivに論文(番号2610.31256v1)を公開し、インドネシア語の臨床栄養分野向け初の専門家注釈付き質問応答評価基準であるIndoNutriQAを発表しました。同基準は、911組の実際の臨床報告から派生した質問と回答のペアを含み、訓練ではなく評価に重点を置き、生成型・抽出型および検索強化型の質問応答タスクをサポートしています。

IndoNutriQA: An Indonesian Clinical Nutrition Question Answering Benchmark

注目する理由:このベンチマークは、低リソース言語(特にインドネシア語)における臨床栄養NLP分野の高品質な公開評価データの空白を埋め、構造化されたメタデータが整備され、質問タイプが栄養ケアプロセス(NCP)に厳密に準拠しているほか、専門家による検証と複数モデルによるベンチマークテストも実施されており、明確な研究上の位置付けと方法論の厳密性を備えています。

経緯と関連報道

研究では、LLMが生成する合成調査の回答者カバー度を評価する新たな指標RCGを提案した

同論文は2026年10月24日、arXivに掲載され(番号2610.30900v1)、大規模言語モデル(LLM)が生成する合成調査回答者について、完全な回答プロファイル空間における実際の人類回答者のカバー度を測定する新たな評価指標「回答者カバレッジギャップ」(RCG)を提案している。

Silicon Samples Match the Answers but Not the Respondents

注目する理由:既存の評価手法は、単一設問の解答分布や設問間の相関にのみ着目しており、LLMが生成した回答者が実際の母集団に存在する解答組み合わせを再現しているかどうかを識別することはできません。RCGは初めて、全量の回答プロファイルに基づいてカバー不足を定量化し、米国の2つの社会調査データにおいて、テスト対象のすべてのLLMで顕著な未カバー層が存在し、しかもそれらの性能が単純なマージナルサンプリングのベースラインおよびガウス・コピュラモデルよりも劣っていることを実証しました。

経緯と関連報道

研究は、多言語評価における「大規模モデルが審判を務める」手法の効果が、審判モデルの選択に極めて依存することを明らかにした

2026年10月24日付のarXivに掲載された多言語に関する実証研究によると、現在主流のプロンプト戦略(たとえばチェーン・オブ・シンキングやキャラクター設定)は、LLM-as-a-Judgeのシナリオにおいてモデル間・言語間で移転性を有していないことが明らかになった。また、審判モデルの選択がプロンプト戦略そのものよりもはるかに大きな影響を及ぼしており、さらには戦略の効果が異なる審判モデル間で方向性が逆転することすらあるという。

Prompting Strategy Effects Depend on the Judge: A Multilingual Study of LLM-as-a-Judge Robustness

注目する理由:本研究は、9種類のプロンプト戦略、4つのオープンソースの審判モデル、27言語および13のデータセット間の相互作用効果を初めて体系的に測定し、人手による検証を経た100万件を超えるポイント対ポイントのスコアを生成することで、英語を中心としたプロンプト研究と固定テンプレートに基づく多言語研究の間にある重要なギャップを埋めました。

経緯と関連報道

IFC-MCQ:建築情報モデル向けのLLMエージェントによる自動多肢選択問題のベンチマーク生成手法

研究者は2026年10月24日、arXivにてIFC-MCQ手法を公開し、建築・エンジニアリング・建設(AEC)分野における大規模言語モデル(LLM)ベースのIndustry Foundation Classes(IFC)データ検索システム向けに、正確な採点が可能な多肢選択式問題のベンチマークを自動生成することを目的としています。

IFC-MCQ: Automatically Generating Multiple-Choice Benchmarks for Evaluating LLM Agents on IFC Data Retrieval

注目する理由:本研究は、IFCなどの専門的な構造化データに対する大規模言語モデル(LLM)の評価が困難でコストが高いという課題に正面から取り組み、IFCファイル向けの自動多肢選択問題生成フレームワークを初めて提案しました。このフレームワークは15カテゴリ36サブカテゴリを網羅し、再現性と拡張性を備えたエージェント能力の評価を支援します。

経緯と関連報道

FusionEvalの公開:大規模言語モデルの統合に向けた新たなベンチマークテスト

2026年10月24日、研究者はarXivに論文arXiv:2610.30162v1を公開し、大規模言語モデルの融合手法の評価に特化した初の統一ベンチマークであるFusionEvalを提案しました。同ベンチマークは、推論チェーンの長さやツール呼び出しといった脆弱な部分を網羅しており、学習型と非学習型の融合手法の比較も可能にしています。

FusionEval: Benchmarking Model Fusion for Large Language Models

注目する理由:このベンチマークは、既存の評価において長鎖推論とツール利用へのカバーが不十分であった点を補完し、平均性能と最悪時の能力保持を明確に区別するとともに、Qwen3/Llamaに基づく再現可能な専門家プール、GPUメモリや実行時間などの多次元指標、およびオープンソースコードを提供しており、高い実践的指導性を備えています。

経緯と関連報道

WikiOriginQAのリリース:ウィキペディアの多言語版の作成時期に基づいて自動的に構築された、文化的偏見を評価する質問応答データセット

研究チームは2026年10月24日、arXivに論文(番号2610.30677v1)を公開し、全自動で構築された質問応答データセットWikiOriginQAを紹介しました。このデータセットは、各言語版ウィキペディアの作成日付を用いて知識の起源を客観的に表すもので、文化的バイアス評価の拡張性向上を目的としています。

WikiOriginQA: Automated Construction of a QA Dataset with Knowledge Origins for Analyzing Cultural Bias

注目する理由:本研究は、人手によるラベル付けを必要とせず、言語を跨いで文化知識の由来データを大規模に生成できる手法を提案し、実験により大規模言語モデルが英語圏の文化に関連する課題において体系的な性能優位性を示すことを確認した。これにより、文化的バイアスの定量的分析に新たなツールが提供された。

経緯と関連報道

研究により、コーディングエージェントのベンチマークにおける「規範–オラクルギャップ」の問題が明らかになった

2026年10月24日にarXivに掲載された論文は、現在主流のコーディング・インテリジェンス・エージェント向けベンチマーク(たとえばSWE-Milestone)には「仕様–オラクルギャップ」が存在すると指摘している。すなわち、タスクの自然言語による記述には、テストに必要な重要な実装細部(例えば定数名、モジュールパス、正確なエラーメッセージなど)が含まれておらず、その結果、評価では上流のコードを再現する能力が測定されているにすぎず、真の理解力や推論能力が評価されていないという問題がある。

What the Specification Did Not Say: Specification-Oracle Gaps in Test-Graded Coding-Agent Benchmarks

注目する理由:本研究は、この種のバイアスを初めて形式的に定義し、5言語をカバーする静的解析ツール(精度89.2%、再現率92.9%)を構築したうえで、SWE-Milestoneにおいて、25のマイルストーンタスクに推論不可能な暗黙的依存関係が存在することを実証的に明らかにしました。これにより、失敗率が大幅に上昇する(80.6%対48.4%)ことが示され、現在のランキングが「名前を真似る」タイプのエージェントを体系的に優遇している可能性が浮き彫りになりました。研究成果として、オープンソースの解析ツールと修正リソースが公開されており、方法論的価値と実践的価値の両面から貢献しています。

経緯と関連報道

実際の文書改訂におけるチャンク再計算:固定型、再帰型、および内容定義型チャンキングの更新コストと検索品質の測定

arXiv:2610.31019v1 公告タイプ:新規 要旨:リトリーバル拡張生成におけるチャンキング戦略は、ほとんどの場合静的なスナップショット上で評価されるが、知識ベースの基盤となる文書は常に変化し続けている。チャンクは独立して埋め込まれるため、編集後に境界が移動すると、変更されていないテキストも再び埋め込み直す必要が生じる。我々は、厳密なバイト単位での同一性維持ルールおよび固定された稠密エンコーダーを前提として、3種類の状態非依存型チャンカー(重複しない固定サイズ型、再帰的段落優先型、および内容定義型)について、中国語および英語のWikipediaにおける120組の隣接する改訂ペアを対象に、この更新コストを測定した。116記事からなる共通成功プールにおいて、パラメータを固定し長さを調整した条件下で、固定サイズ型チャンキングは新しいバージョンの埋め込み入力全体のワークロードの57〜68%を再計算することになる。再帰的チュー

Chunk Recomputation under Real Document Revisions: Measuring Update Cost and Retrieval Quality of Fixed, Recursive, and Content-Defined Chunking
経緯と関連報道

研究により、オープンソースの大規模モデルにおいて構造化抽出の際にリスト補完現象が広く見られることが明らかになった

2026年10月24日付のarXivに掲載された実証研究(論文番号2610.30997v1)では、JSON抽出スキーマにおいてリストの最小項目数が設定されているにもかかわらず、ドキュメントの実際の内容がその値に満たない場合、8種類のオープンソース重み付けモデルのほとんどが、その最小値を制約ではなく生成目標とみなしてしまうことが明らかになりました。その結果、出力リストの長さが実際の項目数を上回る割合は55.4%に達し(ベースラインは34.5%)、補完項目の多くは原文から採用されており、その約半数が出典の一貫性検証に合格しました。一方で、一般的な緩和策の効果は限定的でした。

Padding to k: A Minimum Count in the Schema Makes Open-Weight Models Pad Their Extraction Lists

注目する理由:本研究は事前登録型の計画に基づき、558件の実際の文書および9つのアノテーション済みデータセットを用いて、8種類のオープンソースモデルと6種類のホスティングサービスモデルを体系的に評価しました。手法は厳密で、データは公開されており(コードと結果はGitHubに公開済み)、構造化情報抽出において見落とされがちでありながらも下流タスクの信頼性に影響を及ぼす重要な欠陥——スキーマ誘発型の忠実性を欠く埋め込み行動——を明らかにしています。

経緯と関連報道

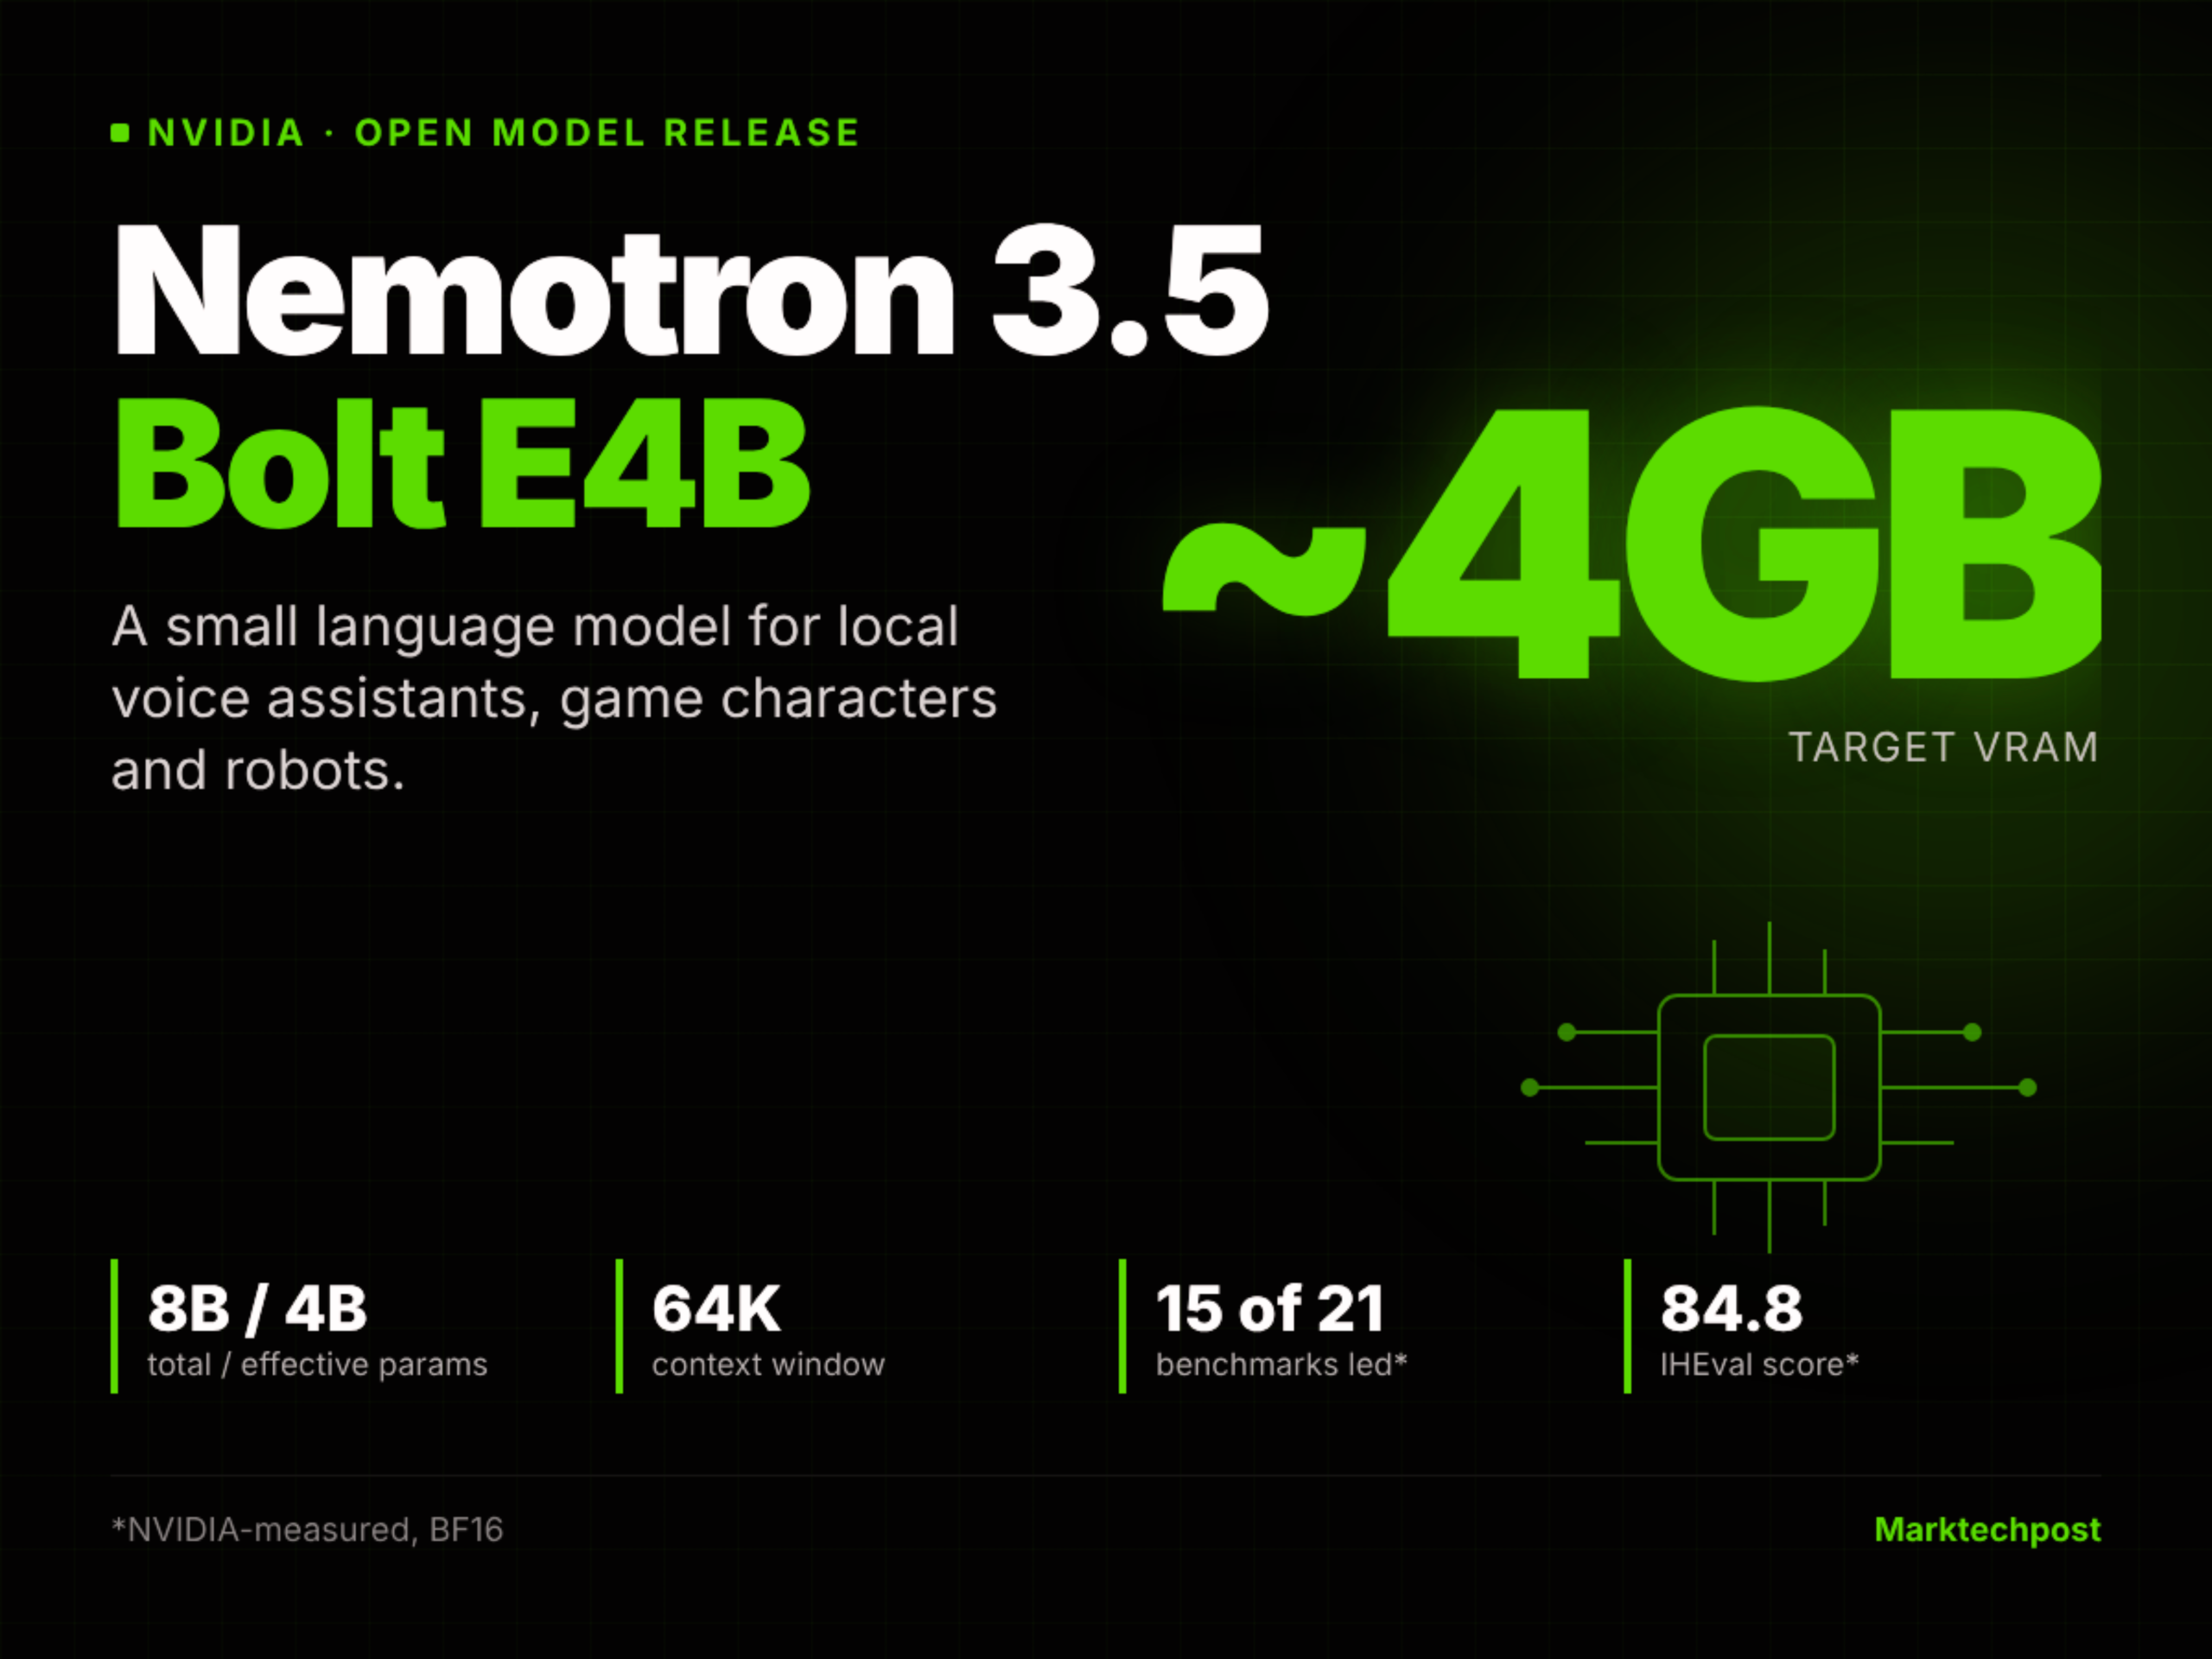
NVIDIAは、ローカルな音声アシスタント、ゲームのNPC、およびロボット向けに最適化されたオープンソースの小型言語モデル「Nemotron 3.5 Bolt E4B 4GB」を発表しました。

NVIDIAは、Google Gemma 4 E4Bモデルを基に、強化学習(RL)による後処理のみでNemotron 3.5 Bolt E4B 4GBを発表しました。これは総パラメータ8B、有効パラメータ4B、64Kのコンテキストを持つオープンソースの小型言語モデルで、RTXやJetsonなどのエッジデバイス上で約4GBのVRAMで動作することを目指し、マルチラウンドのツール呼び出しと低遅延の音声対応をサポートしています。

NVIDIA Releases Nemotron 3.5 Bolt E4B 4GB: An Open Small Language Model for Local Voice Agents, Game Characters and Robots
経緯と関連報道

IBMはGranite時系列統合予測モデルを発表しました。4つのモデルをゼロチューニングで組み合わせ、堅牢なデフォルトの予測ソリューションを提供します。

IBM Researchは、オープンソースのGranite Timeseries Ensemble(v1)を公開し、PatchTST-FM-r1/r2、FlowState、Tiny Time Mixersの4種類の事前学習アーキテクチャを統合して、ゼロ・ファインチューニングによる確率的アンサンブル予測をサポートしています。デフォルトでは等重みの確率的アンサンブル(Probabilistic Ensemble)を採用しており、四分位範囲に基づく適応的重み付け(IQR Ensemble)も提供されています。GIFT-Evalベンチマーク(2026年10月20日時点のスナップショット)において、点予測誤差(MASE=0.683)は最良の単一モデルをわずかに上回り、全体的なロバスト性が顕著に向上しています。

経緯と関連報道

AIエージェントのハルシネーション検出における多層アプローチ:本番環境向けの実用的フレームワーク

本稿では、AIエージェントが実際のワークフローにおいて幻覚を生じさせる典型的な四つのパターン(事実性、文脈性、虚構性、自己矛盾)を体系的に整理し、単一のスコアリングに依存するのではなく、信頼性チェック、ソース検証、自己整合性評価、意味エントロピー分析、ならびに人間と機械の協調における閾値設定など、多角的な検出手法を組み合わせる必要があることを示した。さらに、検出はワークフローの閉ループに組み込まれ、観測性、エラー処理、および人間による審査のプロセスと深く統合されるべきであることを強調している。

経緯と関連報道

マイクロソフトとHugging FaceがThinkingBoxフレームワークをオープンソース化:データベースの最終状態を確定的な報酬信号として用い、エージェントの強化学習後訓練を推進

マイクロソフトとHugging Faceは共同でオープンソースフレームワーク「ThinkingBox」を発表しました。このフレームワークは、LLMエージェントが実行した後の実際のデータベースの最終状態と期待される状態を比較し、0/1の二値報酬を生成することで強化学習による微調整に用いられます。また、それに伴うベンチマーク「ThinkingBox-Bench」には507の実際のバックエンドタスクが含まれており、いずれのタスクも学習に使用されていません。Qwen3.8-27Bは50ステップのGRPOによる微調整を経た結果、ホールドアウトテストセットにおいてpass@1が9.08ポイント向上し、Observed 20/20は約3倍に増加しました。ただし、一部の領域ではpass@20が低下しており、これは広範さと安定性のトレードオフを反映しています。

経緯と関連報道

NVIDIAがKumo Forecastを発表:事前学習による時系列表現、過去パターン検索、説明可能性を統合した多変量予測モデル

NVIDIAは、オープンソースの時系列予測モデル「Kumo Forecast」(旧称:NV-Tesseract Forecasting)を発表しました。同モデルはMOMENT-1-large Transformerアーキテクチャを基盤とし、直接予測とDomain-Aware Representation and Retrieval(DARR)による二重経路推論をサポートするとともに、モデル構造を変更することなく利用できる解釈可能性フレームワークを内蔵しています。

経緯と関連報道

i14がLaplace 3B線形注意力モデルを発表:AWS Trainium2とネイティブPyTorchを基に、固定状態メモリでの推論を実現

i14は、30.28億パラメータを備えるLaplace 3Bモデルを発表しました。このモデルでは、Softmaxアテンションの代わりにゲート制御線形アテンション(GLA)を採用しており、推論時の各シーケンスあたりの再帰状態は常に29.5 MBで、コンテキスト長に依存しません。同モデルは、AWS trn2.48xlarge(Trainium2チップ16基搭載)1台でトレーニングおよびサービス検証を実施し、トレーニングスループットは12万トークン/秒、サービススループットは11,544出力トークン/秒(1,280同時実行シーケンス)に達しました。すべての性能データは、i14とAWS GenAIICチームによる社内実測結果です。

経緯と関連報道