
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。
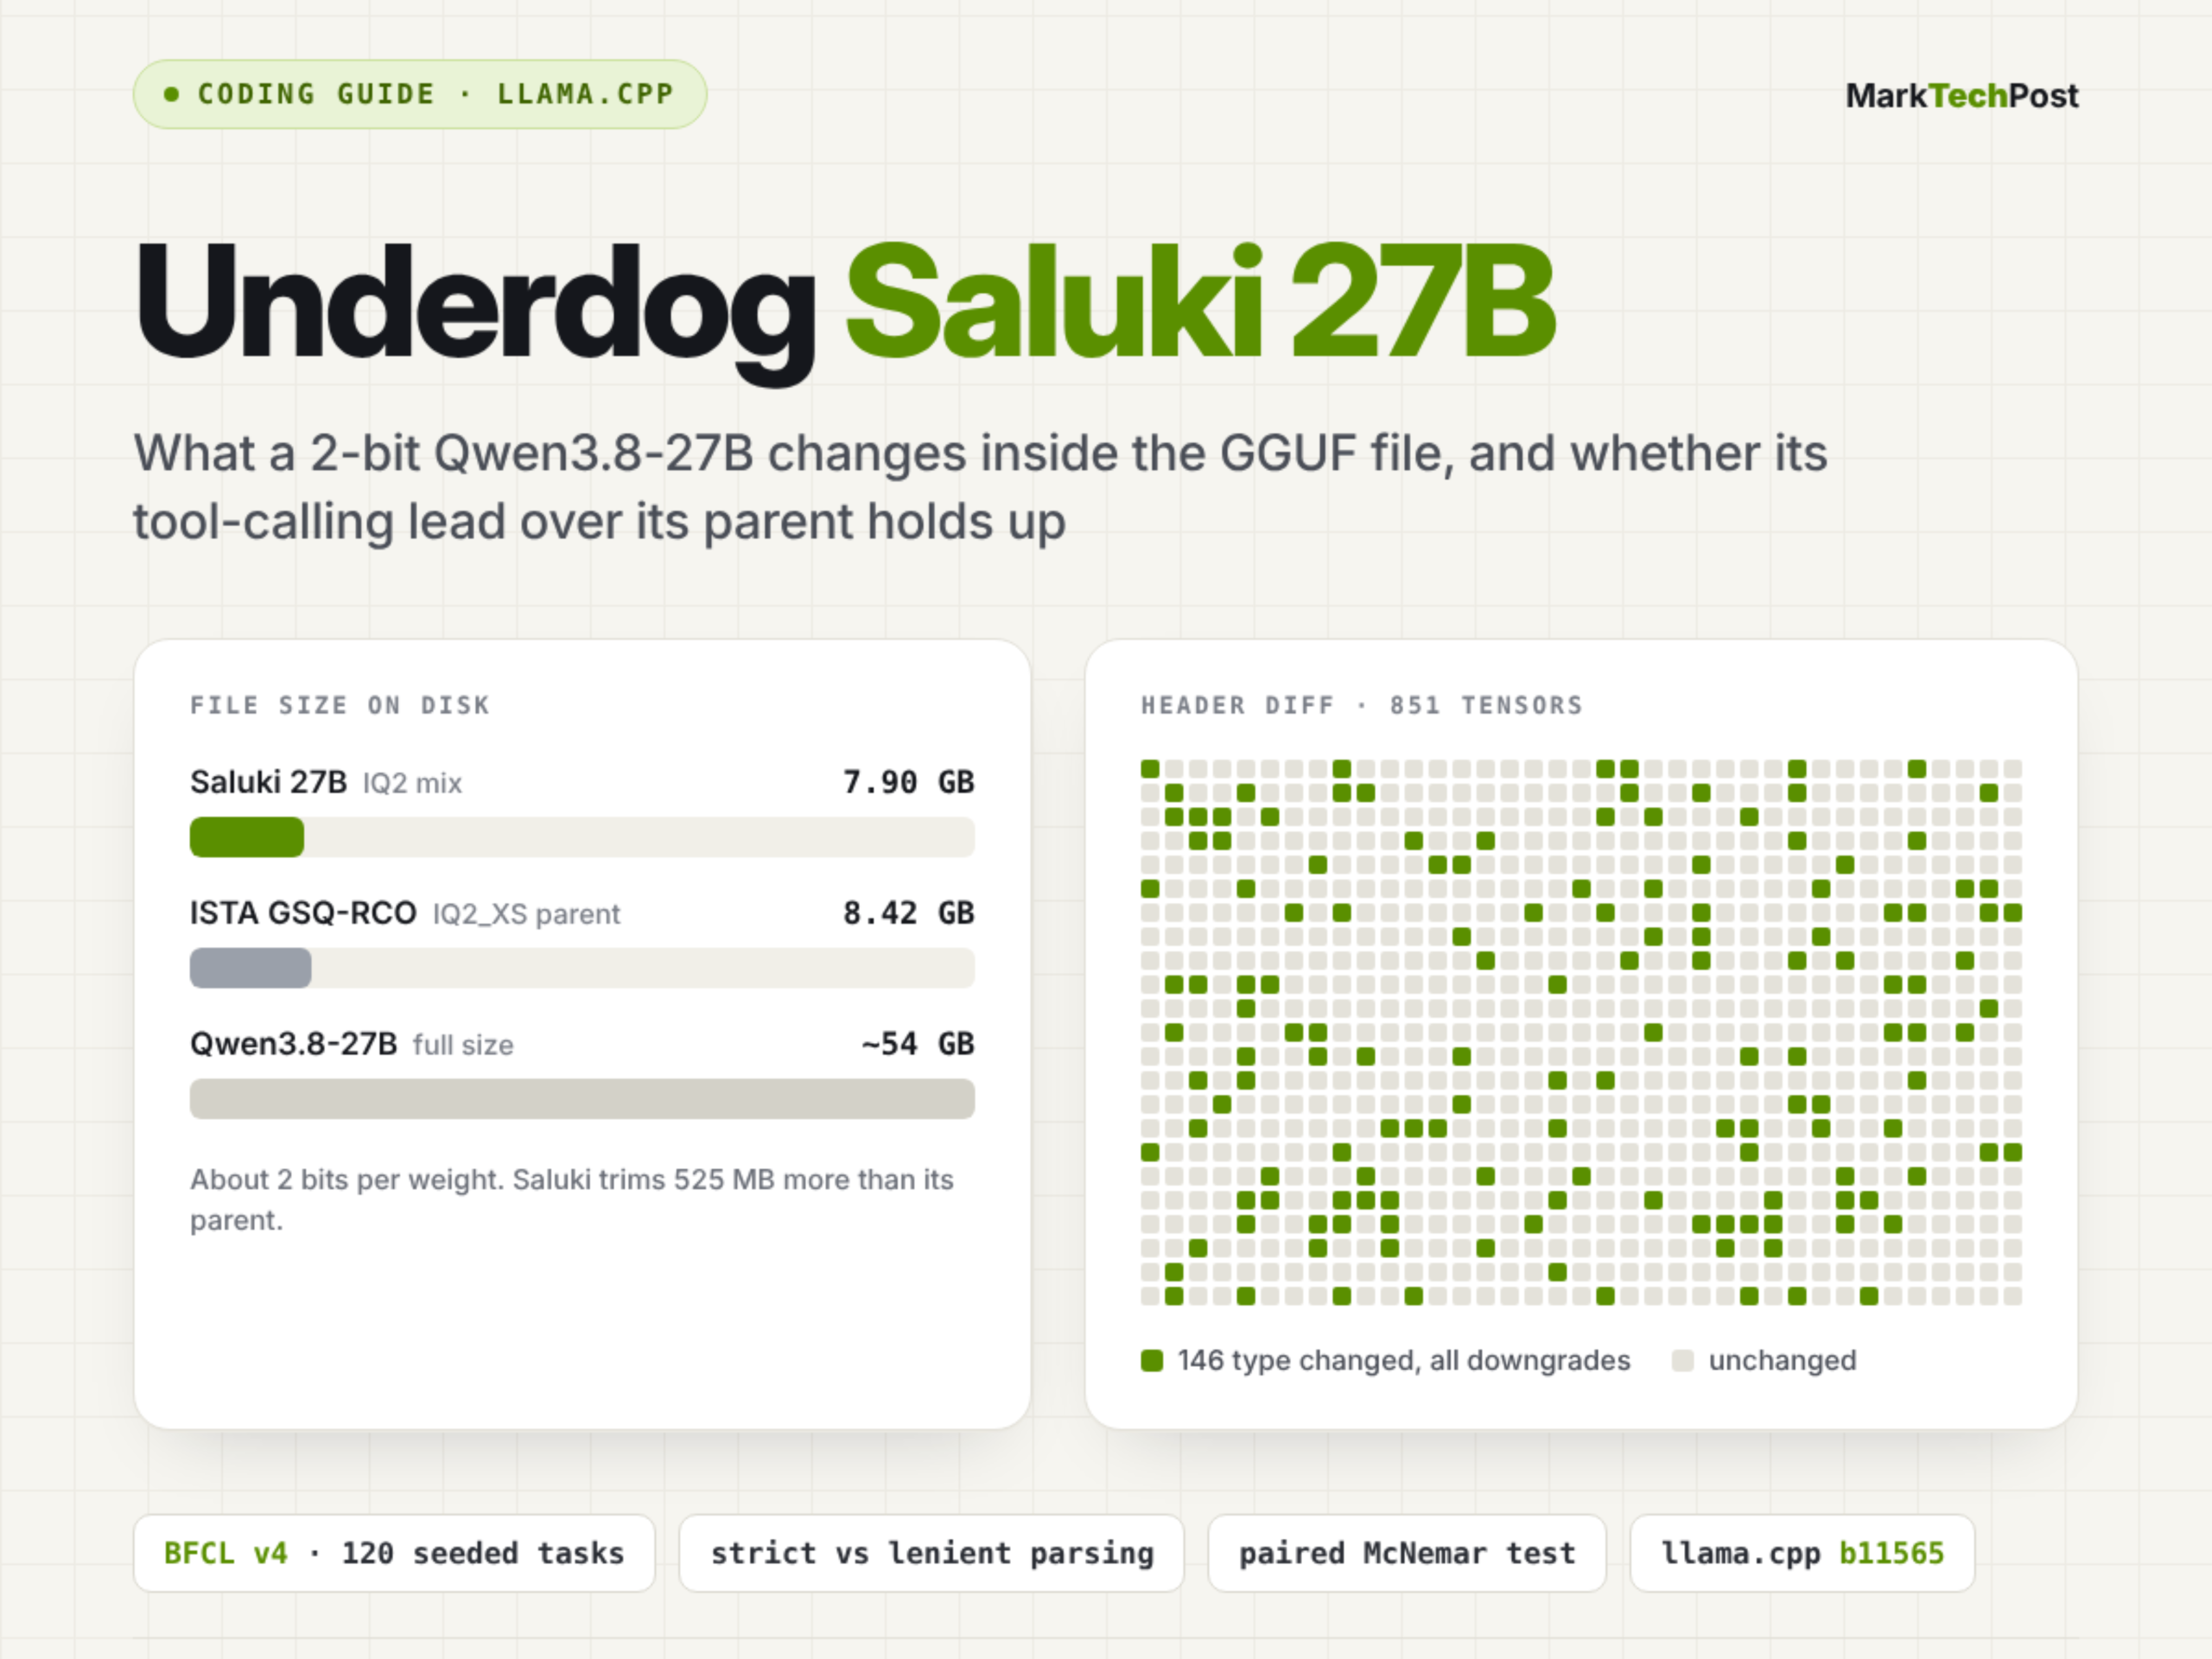
How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

Apple初の折りたたみ式スクリーン搭載iPhone Duoが発売と同時に、画面の集中的な割れ問題が発生している

複数のユーザーから、Apple初の折りたたみ式スマートフォン「iPhone Duo」について、開封後わずかな時間でヒンジの真上部分の画面にひび割れや線状の破損が生じるという報告が寄せられており、故障の発生が極めて集中しているとのことです。オーストラリアおよび中国国内でも同様の事例が確認されており、原因はヒンジの組み付け公差にあると疑われています。Apple公式からのコメントはまだなく、アフターサービスでの判定結果次第で、無償交換か高額な自己負担による修理が決まる見込みです。

注目する理由:本件は、新製品における大規模な初期不良をめぐる事案であり、消費者の権利と企業の責任の境界に直面するものであるとともに、三包法規の適用性やAppleCare+サービスの位置付けといった公共的課題も重なり、典型的な警鐘としての意義と権利救済の参考価値を有している。

経緯と関連報道

セバスチャン・ラシュカが8本のビデオコース「ゼロから推論モデルを構築する」を公開しました

セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。

注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。

経緯と関連報道

研究では、LLMが生成する合成調査の回答者カバー度を評価する新たな指標RCGを提案した

同論文は2026年10月24日、arXivに掲載され(番号2610.30900v1)、大規模言語モデル(LLM)が生成する合成調査回答者について、完全な回答プロファイル空間における実際の人類回答者のカバー度を測定する新たな評価指標「回答者カバレッジギャップ」(RCG)を提案している。

Silicon Samples Match the Answers but Not the Respondents

注目する理由:既存の評価手法は、単一設問の解答分布や設問間の相関にのみ着目しており、LLMが生成した回答者が実際の母集団に存在する解答組み合わせを再現しているかどうかを識別することはできません。RCGは初めて、全量の回答プロファイルに基づいてカバー不足を定量化し、米国の2つの社会調査データにおいて、テスト対象のすべてのLLMで顕著な未カバー層が存在し、しかもそれらの性能が単純なマージナルサンプリングのベースラインおよびガウス・コピュラモデルよりも劣っていることを実証しました。

経緯と関連報道

新たな研究でReflectPOフレームワークが提案され、大規模言語モデルエージェントの長期間タスクにおける自律的誤り訂正能力が向上しました

2026年10月24日、arXivは「ReflectPO:長周期LLMエージェント向けの反省誘導型戦略最適化」と題する研究論文(ID 2610.30933v1)を公開し、ツール強化型大規模言語モデルエージェントが複雑で多段階かつ状態依存型のタスクにおいて自律的に誤りを回復する能力を向上させるための、ReflectPOと名付けられた強化学習フレームワークを提案した。

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

注目する理由:本論文は、最近発表された最先端のAI研究であり、現在のLLMエージェントの実用化における重要な課題である、長期間にわたるタスクにおける初期段階での誤りの累積効果に焦点を当てています。著者が提案する「Reflection-Guided Sampling」と「Tree-Structured Credit Assignment」の二重構成による設計は、方法論的に革新的であり、二つのツール利用ベンチマークにおいて複数のベースラインを実証的に上回っており、技術的な参考価値を有しています。

経緯と関連報道

Amazon SageMaker AIがマルチラウンド強化学習(MTRL)フレームワークを発表し、エージェントによる多段階タスクのエンドツーエンド学習をサポートします

AWSはMulti-Turn Reinforcement Learning(MTRL)機能をリリースし、ユーザーはSageMaker AI上で、ステップ単位のアノテーションなしに、タスク全体の遷移と最終的な結果に基づいて大規模モデルエージェントを訓練できるようになりました。Wordleを例に、AgentCoreのデプロイ、データ準備、PPOトレーニング、報酬設計、コスト分析に至るまで、一連のワークフローを実演しています。

経緯と関連報道

AWS CDKによる再利用可能なコンストラクトの構築により、SageMakerエンドポイントのスケールアップ/スケールダウン更新におけるブロッキング問題を解決

SageMakerのリアルタイムAIエンドポイントがApplication Auto Scalingに登録されている場合、AWS CDKやCloudFormationでインスタンスタイプやインスタンス数などの設定を直接更新すると失敗します。本稿では、カスタムリソースに基づくCDK構築手法を提案し、厳密な依存関係によるオーケストレーションを通じて、エンドポイントの設定とスケーリングポリシーをアトミックかつ手動による更新不要で実現します。

経緯と関連報道

OpenAIは正式にDecisions APIという意思決定モデルを発表し、TypeSafe Jevとの競争に正面から挑んでいる

OpenAIは2026年10月22日前後に、Decisions APIをすべての顧客に公開する予定です。このモデルはChatGPT Lunaを基に再構築されており、ミリ秒単位の低遅延と低コストな推論を特長としています。また、画像理解などのマルチモーダルタスクにおいて優位性を示しています。現在、主流の意思決定モデルベンチマークでは、最新のJevやD1 Ultraといった競合製品に後れを取っていますが、既にBox、Datadog、Speakなどの企業によって実運用での採用が確認されています。

経緯と関連報道

Amazon SageMakerがトレーニングセッションAPIをリリース:ユーザーは独自の大規模モデルの学習ループを記述でき、GPUの管理が不要になります

Amazon SageMakerは、Training Sessions APIをリリースし、ユーザーが純粋なPythonスクリプトでSFT、RLHF、GRPO、KTOなどのカスタム大規模モデルの学習ロジックを実装できるようにしました。GPUリソースのスケジューリング、フォールトトレランス、分散実行、およびチェックポイント管理はすべてサービスによってホストされます。

経緯と関連報道

クラウド展開が迫る:『コール オブ デューティ モダンウォーフェア 4』がGeForce NOWに登場

今週木曜日、GFNでプレイの準備を整えよう。『コール オブ デューティ モダンウォーフェア 4』がローンチと同時にGeForce NOWに登場し、新キャンペーン、マルチプレイヤーアクション、そしてDMZというハイリスクなエクストラクションモードを対応デバイスへ提供します。さらに、キャンペーンのビジュアルも強化されました。Ultimate会員にはGeForce RTX 5080クラスのパフォーマンスが実装され、[…]におけるレイトレーシング機能への対応も加わります。

経緯と関連報道

パナッシュ — モバイル向けベル・エポック時代のRTS

パナッシュ — モバイル向けベル・エポック時代のRTS これは実に嬉しいですね。昨日、Apache 2.0ライセンスのもとで『Battle Drones』をリリースしたところ、すでにフランス語版のフォークが登場し、ゲームの背景をスチームパンク風の1900年代フランスに変更し、アニメーション付きのオープニングも追加されています! パナッシュは、モバイルおよびブラウザ向けのリアルタイムストラテジーゲームで、ベル・エポック期のフランス(1900年頃)を舞台としています。飛行船、蒸気式装甲車、クレウゾー製の装甲艦、軍帽をかぶった自動人形、歩く要塞ガルガンチュア――そして、まさに「パナッシュ」あふれる世界が広がります。 こちらからパナッシュをプレイできます。新しいオープニング映像を体験するだけでも、リンクをクリックする価値があります。現時点では、ゲームプレイの変更というよりは、主にビジュアル面でのアップデートにとどまっています。音楽にもフランスらしいアレンジが施されています。新しいスチームパンク調のモデルはとてもカッコイイですね! こちらのページには…

経緯と関連報道

TenexがAIネイティブなSDLCを構築:フォーチュン2000企業向けのエージェント駆動型開発実践

設立から18か月のAIネイティブソフトウェア企業Tenexは、アウトプット志向の報酬体系、MetaHarnessフレームワーク、そしてOpus 5.5を軸としたAIエージェントのワークフローにより、フォーチュン2000企業のおよそ半数にサービスを提供しています。同社のモデルは、プロセスの標準化、ノンコーディングによる価値の再評価、ならびにエンタープライズ向けAI導入におけるラストマイルの課題解決に焦点を当てています。

経緯と関連報道

TenexがAIネイティブなSDLCを構築:成果報酬型、エージェント主導の開発、そして企業におけるAI導入のラストマイル

Tenexは、2026年時点で設立18か月、従業員数75名のAIネイティブなソフトウェアデリバリー企業であり、フォーチュン2000にランクされる企業の約半数と、同規模の中堅企業を対象にサービスを提供しています。同社の核心的な取り組みには、ストーリーポイントを基準とした動的なエンジニア報酬体系、AI戦略担当者の品質チェック体制、Gitに統合されたコンテキストを活用するMetaHarnessフレームワーク、さらに「非コーディングの高付加価値タスク」に焦点を当てた能力の再定位が含まれます。一方で、企業におけるAIの導入は依然として汎用LLMの展開やエンジニアリング側のエージェントに集中しており、バックオフィス系のプロダクションレベルのAIエージェントの浸透率はわずか約5%にとどまっています。

経緯と関連報道

TorchNeuronシステムレベルの性能分析(第1部):AWS Trainiumチップをベースとしたエンドツーエンドのプロファイリング

本記事は、Hugging FaceとAmazonが共同で公開する技術ブログシリーズの第1弾であり、AWS Trainium AIアクセラレーションチップ上でTorchNeuronを用いたPyTorchモデルの推論性能分析の手法を体系的に紹介します。内容には、Neuronバックエンドの統合原理、torch.profilerの設定方法、NeuronConfigおよびNeuronProfilerツールの利用、Neuron Explorerによる可視化トレースが含まれます。さらに、RMSNormを例に、3つの実装(従来のPyTorch、torch.rms_normの組み込み融合、torch.compileによる自動融合)間のデバイス上での実行時間の差異を比較しています。

経緯と関連報道

3人のJavaチャンピオンがGitHub Copilotで開発効率を向上させる方法:人間とAIの協調と責任の共有に焦点を当てて

Vlad Mihalcea、Patrick Baumgartner、Frank Delporteの3人のベテランJavaチャンピオンが、本番環境およびオープンソースプロジェクトにおけるGitHub Copilotの活用事例を共有しました。彼らは、AIによるコードの自動生成に依存するのではなく、人間主導での問題定義、コンテキストの明確化、反復による検証、そして最終的な責任の所在の明確化を重視しています。

経緯と関連報道

llm-echo 0.5

リリース:llm-echo 0.5 新しいLLMのリリースに向けて作業を進めており、プルリクエストのテストを行う過程でllm-echoデバッグプラグインを改めて確認しました。このプラグインは、実際にはLLMを一切使用せず、単に与えられたプロンプトをそのまま返すだけの「モデル」を提供します。今回の新バージョンでは、ツールコールやシステムプロンプト、推論用トークンも考慮したシミュレートされたトークン使用量のカウントが更新されます。 使用例:uvx --with llm-echo llm -m echo 'hi there' -o thinking 1 --usage 出力結果:まずプロンプトを検討し、次に何を言うかを決定します。 { "prompt": "hi there", "system": "", "attachments": [], "stream": true, "previous": [] } トークン使用量:入力2、出力24 タグ:llm

経緯と関連報道

Reflectionがオープンソースの大規模モデル「Beam」を公開:5,010億パラメータのスパースMoEアーキテクチャで、数百万語規模のコンテキストと多段階の推論制御をサポート

Reflection社は、オープンソースの大規模言語モデル「Beam」(パラメータ数5,010億、実際のアクティベーションは230億/トークン)を発表しました。同モデルは256エキスパートによるスパースMoEアーキテクチャを採用し、100万トークンのコンテキスト長、NVFP4/FP8量化、多段階の推論オプション設定、およびローカルデプロイメントをサポートしています。ただし、すべての技術的主張は第三者による検証を受けておらず、ハードウェア要件も高いため、一般ユーザーには負担が大きいとの見方が広く示されています。

経緯と関連報道

グーグルのAntigravityプラットフォームが抗菌ペプチドの発見を加速:ProtNLMとAlphaFoldを基盤としたエンドツーエンドのAIサイエンスワークフロー

GoogleはAntigravity科学インテリジェントエージェントプラットフォームを発表し、ProtNLMによるタンパク質機能予測モデル、AlphaFoldの構造データベース、およびゲノムコンテキストに基づく推論機能を統合することで、生物学者が一度の対話セッションにおいて、UniProtに収録された数百万もの「ダークマター」配列といった膨大な未注釈タンパク質の中から新規抗菌ペプチド(AMP)を同定・検証し、優先順位付けするまでの全工程を実行できるよう支援します。また、最初の候補分子(UniProt ID: A0A0U0D591)はすでに湿式実験による検証段階に入っています。

経緯と関連報道

Python 3.15によるウェブ編集のプロファイリング:フレームグラフとソースヒートマップ

研究:Python 3.15によるウェブ編集のプロファイリング——フレームグラフとソースヒートマップ GPT-6 Astra Extra High in Codexを使って、私の新しいウェブ編集アプリに対してPython 3.15の新しいプロファイラを試してみました。PyPIから入手した「web-edit」アプリのPython 3.15版のフレームグラフとヒートマップのデモが必要です。まずは調査を行い、その後でこれらのデモを作成してください。以下は、生成されたフレームグラフとヒートマップの例です。タグ:プロファイリング、Python、Codex

経緯と関連報道