本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

TRACEs:分散型科学ワークフローのための細粒度組み込みプロヴェナンス

arXiv:2610.39981v1 発表タイプ:新規 要旨:大規模な科学ワークフローは分散型HPCリソース上で実行されるため、科学データ製品がどのように生成され、なぜ類似のワークフロー実行でも非常に異なる結果が得られるのかを説明することは困難である。既存のシステムは通常、分散ワークフローの実行またはプロヴェナンス管理のいずれかに焦点を当てており、細粒度のプロヴェナンスを分散型科学データアーティファクトの固有の特性として扱うことはほとんどない。我々は、TRACEs(Traceable Runtime for Advanced Containerized Executions)を提案する。これは、生成されるすべてのデータアーティファクトにデータの系譜と実行コンテキストを直接埋め込む、分散型コンテナ化された科学ワークフロー向けのプロヴェナンスアーキテクチャである。プロヴェナンスをワークフロー編成から分離することで、TRACEsはアーティファクト中心のプロヴェナンスを一般化する
経緯と関連報道

異種性はいつ効果を発揮するのか?GPUとWSEシステムの相補性の理解

arXiv:2610.39222v1 発表タイプ:新規 要旨:AIアクセラレータのアーキテクチャがますます多様化する中、異なるアーキテクチャを統一されたシステムに統合することが、新たな異種計算のパラダイムとして浮上している。GPUとWSEは、演算、メモリ、通信の組織形態において大きく異なり、これによりアーキテクチャ間の相補性と追加のオーバヘッドが生じる一方で、この異種性をいかにして実用的な性能向上へと結びつけるかは依然として不明である。このギャップを解消するため、我々はGPU–WSEの異種実行および相補性を活用する条件を評価する階層的ベンチマーク手法を提案するとともに、異種性がボトルネックとなる場合とシステムレベルで性能向上をもたらす場合を特定する解析的性能モデルを提示する。

経緯と関連報道

FlatCake:大規模言語モデルのサービス向けフラットなKVキャッシュストレージアーキテクチャ

arXiv:2610.38355v1 発表タイプ:新規 要旨:KVキャッシュの再利用は大規模言語モデルのサービスを加速させるが、既存のシステムではホストのDRAMとNVMe SSDを階層的なヒエラルキーとして管理しており、DRAMが中間キャッシュとして機能している。しかし、実際の大規模言語モデルのワークロードは、この階層構造の二つの前提をいずれも破っている。第一に、バイモーダルな再利用によりDRAMの時間的フィルタリングが無効化される。というのも、ワークロードは長い再利用距離を持つワンショットブロックか、DRAM容量を超える数ギガバイト規模のエージェントセッションによって支配されており、その結果SSDが重要な読み取りパスに置かれているからである。第二に、DRAMによるステージングと、排出現象に基づくレイアウトがSSDの復元処理をボトルネックにしている。進行中のプレフィックスのためにホストのステージングバッファを保持すると、負荷下で競合が生じてプリフェッチが中断されてしまう一方で、段階的な排出現象によってセッション内のブロックがSSD全体に散らばり、大規模なシーケンシャルリードが妨げられる。我々は…

経緯と関連報道

Seq@K:逐次的フィードバック下での言語モデルの評価

arXiv:2610.37859v1 発表タイプ:新規 要旨:言語モデルエージェントは、文脈における自然言語から学習する能力において、従来の知能システムとは根本的に異なります。この能力により、エージェントはフィードバックに応じて自身の回答を反復的に改善することが可能となり、これは現代のエージェント型ワークフローにおいて広く見られる動作様式です。しかし、コミュニティでは主にPass@1やPass@Kといった指標でモデルを評価しており、それらの指標では、エージェントが過去の試行に対するフィードバックをどのように活用しているかを捉えることはできません。そこで私たちは、Seq@Kという自然な評価プロトコルを提案します。これは、各前の試行が失敗した後にフィードバックを受け取り、K回の逐次的な試行のうちに問題を解決できるかどうかを測定するものです。長期的な計画を検討する多段階のエージェントベンチマークとは異なり、Seq@Kは、フィードバックによる改善という核心的な能力を単独で抽出し、形式化しています。

経緯と関連報道

適応型最適化における勾配補正:適応前の修正

arXiv:2502.02727v4 発表タイプ:置換・交差 要旨:クライアントドリフト補償手法は、フェデレーテッド学習(FL)におけるデータの非均一性の影響を軽減します。確率的勾配降下法(SGD)ベースのFLではドリフト補正が十分に研究されてきましたが、適応型クライアント最適化手法との相互作用についてはまだ十分に解明されていません。Adamなどの適応型最適化手法は、過去の勾配の移動平均を用いて各更新を行います。そのため、最終的な更新方向のみを補正しても、その移動平均とそこに含まれるドリフトは変更されません。私たちは、これらの移動平均に入る前に各勾配を補正する「フェデレーテッド適応型勾配補正({\tt FA-GC})」を提案し、最終的な方向に補正を加える「フェデレーテッド適応型素朴追跡({\tt FA-NT})」と比較しました。実験により、ある理想的な

経緯と関連報道

INC-MoE:エキスパート並列型混合専門家推論における、ネットワーク内コレクティブの重複と専門家計算

arXiv:2610.36339v1 発表タイプ:新規 要旨:エキスパート並列型混合専門家(MoE)のサービスにおいて、ディスパッチは各トークンをその選択された専門家が配置されているアクセラレータへ送り、コンバインは各トークンの所有者に専門家の出力を集約して返します。これら両操作はクリティカルパス上に位置し、マルチノード環境ではMoE層のレイテンシを大きく左右します。本研究では、ディスパッチとコンバインをネットワークスイッチにオフロードし、さらに両コレクティブを相互に、および専門家計算と重ね合わせるエキスパート並列型MoE層であるINC-MoEを提案します。ディスパッチはスイッチ側のマルチキャストによるネットワーク内AllGatherを用い、コンバインはスイッチ側のリダクションによるネットワーク内ReduceScatterを用います。両コレクティブとも、エンドホストとスイッチ間でメッセージセマンティクスを利用します。なお、ネットワーク内コレクティブはそれぞれ逆方向に負荷をかけるため

経緯と関連報道

KORA:AIワークロード向けの決定論優先実行制御

arXiv:2610.35869v1 発表タイプ:新規 要旨:AIアプリケーションは、推論が必要かどうかを判断する前にしばしばモデルを呼び出します。このデフォルト設定は曖昧な生成タスクには有用ですが、構造化され、決定論的で、方針に基づき、照会中心、あるいは直接検証可能な作業には適していません。KORAは、決定論優先の実行制御を導入します。これは、リクエストをタスクパスとして表現し、まず決定論的または構造化された経路を試行し、その結果を検証し、テレメトリを記録した上で、決定論的な処理だけでは不十分な場合にのみモデル候補への経路へとエスカレートする、事前推論用の制御層です。本論文では、KORAを決定論優先の実行制御アーキテクチャとして提示し、再現可能なベンチマークおよび検証ワークロードによる限定的な実証結果を報告します。再

経緯と関連報道

どの方針に対して校正されるのか?介入下における固定世界モデルに対するコンフォーマル不確実性

arXiv:2610.35877v1 発表タイプ:新規 要旨:デプロイメント方針を変更すると、物理的な遷移メカニズムや予測器はそのままでも、世界モデルの不確実性が無効化される可能性がある。一歩先の予測において、源と対象の法則が条件付きメカニズム $P(Y|X)=Q(Y|X)$ を共有している場合、介入は事前結果の測度変化 $w(X)=dQ_X/dP_X$ によって特定される。方針制御された動的系では、この比は状態占有と行動傾向の項に分解される。重み付けされたコンフォーマル校正は、マージナルカバレッジを対象の法則へと移行させる;推定された比 $\hat w$ を用いれば、$P_Q\{Y \in C_{\hat w}(X)\} \ge 1-\alpha-TV(Q,\hat Q) \ge 1-\alpha-E_P|w-\hat w|$ が成立する。ソース対ターゲットのドメイン分類器に対する集団ロスレグレットは、同様の比の誤差を上限付ける。もし $h$ がそのクリッピング

経緯と関連報道

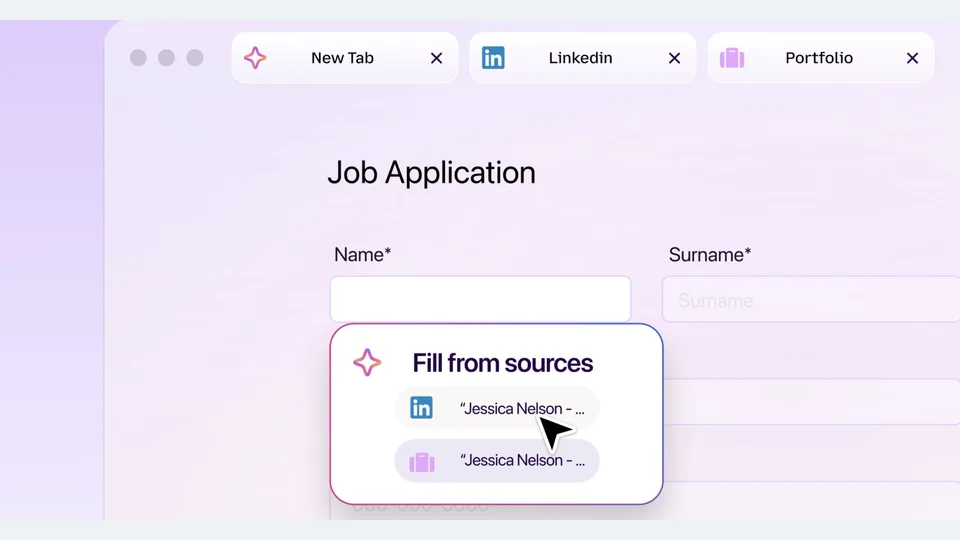
Firefox Smart WindowにAIによるフォーム入力機能が追加され、現在のタブから自動で情報を抽出できるようになりました。

Mozillaは2026年10月27日、FirefoxのAIブラウジング機能「Smart Window」をアップデートし、ユーザーが現在開いているタブに基づいたスマートなフォーム入力機能を新たに搭載しました。これにより、LinkedInやポートフォリオサイトなどのウェブページから情報を抽出し、求人応募書などの複数項目を自動で入力することが可能になります。

新闻源配图 · The Verge · AI

注目する理由:このアップデートは、Firefoxブラウザーにおける最近のAI機能の進化において重要な一歩です。The Vergeが報じており、公開日(2026年10月27日)も明示されています。内容は具体的な操作ロジックや利用シーンに焦点を当て、情報要素は十分に網羅され、出典も明確です。ただし、技術的な実装詳細やデータ処理方法、プライバシー方針については明らかにされておらず、また、この機能が全ユーザーへ展開されているのか、特定のテストチャンネルに限定されているのかも示されていません。

経緯と関連報道

百度が、数百ページに及ぶ文書の解析向けのUnlimited OCR 2をオープンソース化

Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

シスコ・パートナーサミット:AI時代のチャネルを定義する5つの洞察

30年にわたる歴史の大部分において、シスコ・パートナー・サミットは、パートナーがシスコシステムズ社の技術をどのように販売するかに焦点を当ててきました。今年のバンクーバーでのイベントは、これまでとは異なるテーマ——すなわち、取引そのものがもはや主役でなくなった世界において、パートナーがいかにして収益を上げるか——に注目していました。シスコは、同社の株価が[…]という好調な状況下で、このイベントに臨みました。記事「シスコ・パートナー・サミット:AI時代のチャネルを規定する5つの洞察」は、最初にSiliconANGLEに掲載されました。

経緯と関連報道

ProtoEEG:EEGの視覚的デコーディングのための構造化されたプロトタイプアライメント

arXiv:2610.33065v1 発表タイプ:新規 要旨:頭皮上の記録はノイズが多く、空間的に粗く、試行間および被験者間で変動するため、EEGによる視覚デコーディングは依然として困難である。多くのシステムでは、各試行を高密度な画像埋め込みに位置合わせしているが、その埋め込みには意味内容と、インスタンス固有のテクスチャ・姿勢・背景が混在している。このような手法では、EEGには存在しない詳細情報を必要とする上、予測を支える視覚的要因について明示的な説明を提供していない。そこで私たちは、共有可能な学習可能な視覚コードブックに基づくソフトな合成としてEEG–画像の位置合わせを再定式化する、プロトタイプ媒介型フレームワークである\textbf{ProtoEEG}を提案する。学習可能なEEGエンコーダーと固定された視覚教師が、同一の$K=64$個のプロトタイプに対する割り当て分布を生成し、それらの重み付けされた再構成が構造化された表現を形成する。

経緯と関連報道

ヤコビアンレンズの数学的理論

arXiv:2610.31955v1 発表タイプ:新規 要旨:Anthropicによる最近の研究では、ジャコビアンレンズ(J-lens、Gurneeら、2026年)と呼ばれる新たな解釈可能性ツールが導入されました。この手法は、最先端の言語モデルの隠れ状態において、作業記憶に類似した表現を想起させる性質を持つ線形方向を特定しました。しかし、こうした特徴がJ-lensによって検出可能となるメカニズム的特性については依然として不明です。そこで本研究では、J-lensの数学的理論を提案し、同理論が特に一貫性のある特徴――すなわち、空間的に一貫したリヤプノフモードのように働く方向――を優先的に識別することを示します。これらの方向に沿った微小な摂動は層を跨いで増幅し、トークン位置間でほぼ一定に保たれ、異なる文脈間でも一貫しています。一方でw

新闻源配图 · arXiv cs.LG
経緯と関連報道

MANTA:非同期型BFTにおけるDAGの柔軟性を解き放つ

arXiv:2610.34419v1 発表タイプ:新規 要旨:DAGベースのBFTプロトコルは、単一リーダーによる提案経路を、共有グラフで連結された並行なブロック提案へと置き換えることで、コンセンサス設計に大きな転換をもたらしました。このグラフでは、参照がコンセンサスの証拠を表現しています。しかし、異種の広域ネットワーク(WAN)下では、ストラグル効果により、既存の設計はラウンドの長時間化や性能の低下という問題に直面しています。その根本原因は、硬直的なラウンド進行にあります。すなわち、レプリカは同期的にラウンドを進め、前のラウンドからの十分な参照が揃うまで待機した後でようやく次へ進むのです。そこで私たちは、非同期BFTコンセンサス向けの柔軟なDAG成長フレームワークを提案します。私たちの重要な観察は、安全性和活性性のために参照クォーラムは必要であるものの、それがすべてのラウンド進行を阻害する必要はないということです。代わりに、接続性r

経緯と関連報道

PRISM:暗黙的な確率的変調による大規模言語モデルのサンプリング多様性の促進

arXiv:2610.32101v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)は、出力分布が既知の意味的なモードに集中する「モード崩壊」を示す。多様性が失われると、繰り返しサンプリングは発見ではなく意味的な反復となり、稀ではあるがより強力な解が表面化しにくくなるため、自己進化や継続的学習の維持が困難になる。ほとんどの対策は推論時のみに介入し、サンプルを調整するだけで、多様性をモデルの能力として組み込むことはできない。そこで私たちは、訓練時に多様性をモデル内部に内蔵するフレームワークであるPRISMを提案する。PRISMは、(i) 各プロンプトに対し、多様でありながら正解でもある複数の教師モデルによる解答を対応付けるサブモジュラー型キュレーションと、(ii) 特殊トークンの摂動を実行可能な形に変換する確率的埋め込み変調を組み合わせている。

経緯と関連報道

CFBrainAug:解釈可能なfMRIベースの自閉症診断のためのモジュール性による反事実的脳ネットワーク拡張

arXiv:2610.32184v1 発表タイプ:新規 要旨:安静時機能的磁気共鳴画像法(rs-fMRI)に基づく脳ネットワークに対する機械学習は、自閉症スペクトラム障害(ASD)の診断において有望であるが、既存の手法は限られた学習データに対して過剰適合しやすく、事後的な統計的帰属解析では臨床的な解釈可能性が限定的である。本研究では、ラベルを変更した脳ネットワークを学習することで、データ拡張と反事実的説明を統合する反事実的脳ネットワーク学習フレームワークであるCFBrainAugを提案する。従来のラベル保持型拡張とは異なり、CFBrainAugはまずラベルとは逆だがトポロジー的に類似した候補を抽出し、その後、モジュール数制約の下でそれを精緻化する。事実的および反事実的ネットワークを併せて学習することで、学習

経緯と関連報道