
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。
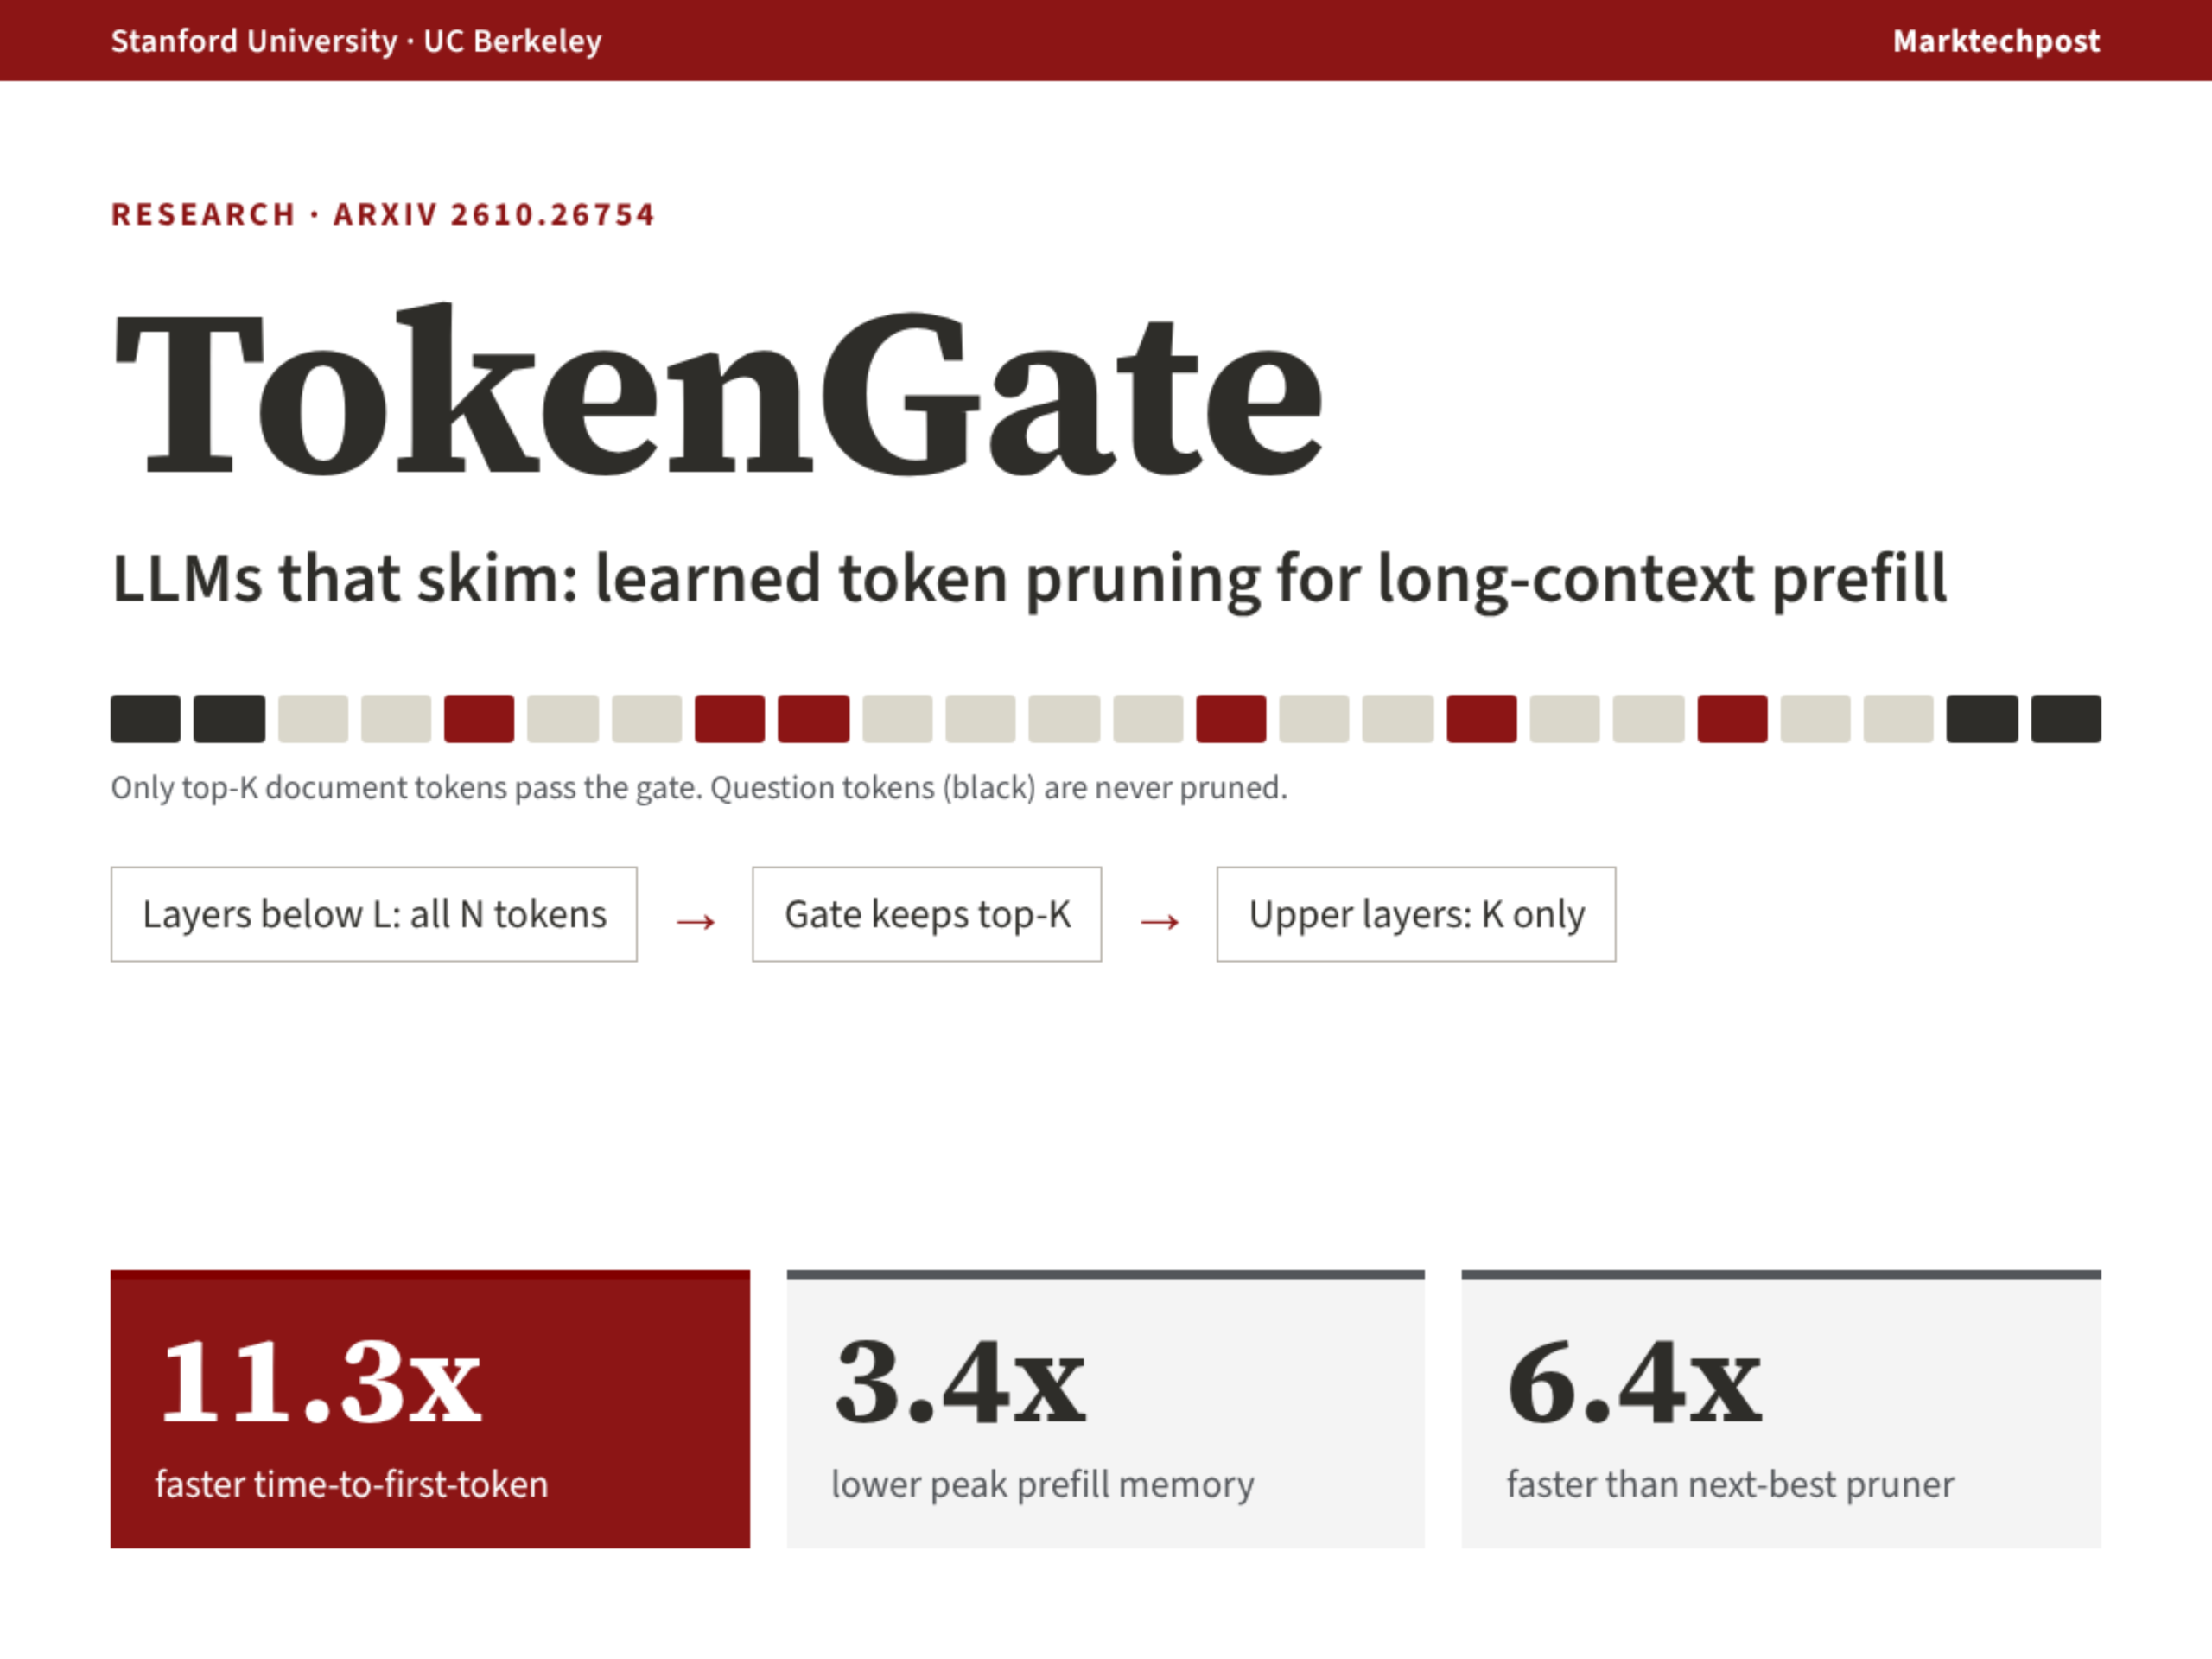
Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

PyTorch 2.15 は MPS を正式にサポート:FP8、MoE の高速化、および Metal カーネルが全面的にアップグレードされました

PyTorch 2.15 は、Apple Silicon Mac に重大な MPS バックエンドのアップグレードをもたらし、macOS 上で初めて FP8 テンソル演算をネイティブにサポートします。また、MoE モデルのデコード速度が 5~6.5 倍に向上し、ビデオ VAE のデコードにおけるピークメモリ使用量は 270 GiB から 8 GiB へと大幅に削減され、さらに多数のオペレーターが MPSGraph から専用の Metal カーネルへ移行されました。

経緯と関連報道