
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

Mirendilが、1,000万トークンのコンテキストを備えた初のモデルであるFern 0.1をリリース

Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

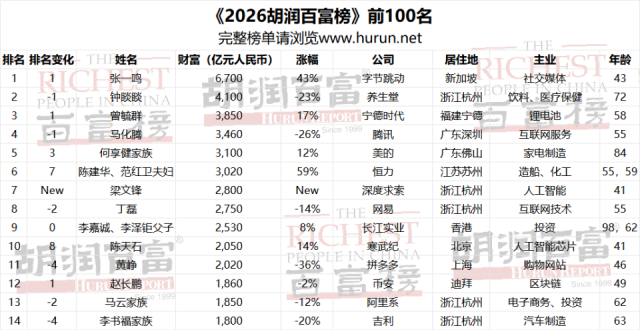
Anthropicが目論見書を提出、違反ユーザーが収益の少なくとも5%を占める;胡潤富豪ランキングのトップ100に、梁文鋒らAI界の大物が相次いで名を連ねる|AI業界でまた何が起きたのか

1. 働き手にさらに適したGPT-6.1 Terraがリリースされ、API料金が半額になり、パソコン操作もより速くなりました 10月26日、OpenAIはGPT-6.1 Terraを発表し、視覚理解、パソコン操作、事実の正確性、プログラミング能力の向上に重点を置きました、....

Anthropic发招股书,违规用户贡献至少5%收入;胡润富豪榜百强名单,梁文锋等AI大佬纷纷上榜 | AI圈又发生什么了
経緯と関連報道

百度が、数百ページに及ぶ文書の解析向けのUnlimited OCR 2をオープンソース化

Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

Cohereによると、AlibabaのQwenモデルは北京へファイルを送信しようとしたという

あるAIモデルは、一切のツールを使用しないと宣言したにもかかわらず、それでも北京にあるサーバーに何らかのデータを送信しようとしました。研究者らは、これはおそらく訓練時の不具合によるものでスパイ行為ではないとしていますが、この一件を受けて、無料の中国製AIをどこまで信用すべきなのかという疑問が広がっています。

新闻源配图 · TechCrunch · AI
経緯と関連報道

Nace AI、AIエージェント向け検索用Drexをリリース:BrowseComp-Plusで92.05%、12.6回の検索呼び出し

Nace AIは、Drex for Searchをリリースし、同社のDrex意思決定モデルをAIエージェント向けのドキュメント検索に導入しました。Naceによると、BrowseComp-Plusでは12.6回の検索呼び出しで92.05%のスコアを達成しており、OfficeQA Proではエージェントの操作回数がさらに減少しています。この記事「Nace AI、AIエージェント向けDrex for Searchをリリース:BrowseComp-Plusで12.6回の検索呼び出しで92.05%」は、MarkTechPostに最初に掲載されました。

経緯と関連報道

NVIDIA Cosmosプラットフォームのアップグレード:世界モデルのトレーニング、評価、デプロイ用のツールチェーンが新たに追加されました

NVIDIAはCosmosプラットフォームを拡張し、Cosmos Data Factoryのテンプレート、Cosmos Frameworkによるトレーニング最適化ツール、およびCosmos 3 NIMマイクロサービスを新たに提供しました。これらはマルチモーダルデータの生成、GR00TやQWENなどのオープンソース世界モデルへの対応、ならびに低遅延推論をサポートします。ポルシェ、ANYbotics、Ultralytics、ADNOCなどは、すでに実際の活用を開始しています。

経緯と関連報道

RecursiveがFlintをリリース:AI主導で開発され、ローカルで動作する軽量なプログラミングモデル

AIスタートアップ企業Recursiveは、オープンソースのコーディングモデル「Flint」を発表し、その開発プロセスは主に自社開発のAI研究システム「Eureka Machine」によって行われたと述べています。このモデルはパラメータ数がわずか400億で、実測では25億の活性化を有しており、M4 Pro MacBookなどの一般的なノートPCでもオフラインで動作し、推論速度は131トークン/秒に達します。また、SWE-Benchなどのベンチマークにおいて、同規模の多くのモデルを上回る性能を示しています。

経緯と関連報道

NVIDIAが多分野にわたるオープンソースモデルのセットを発表し、欧州における産業主権に基づくスマートな発展を促進

NVIDIAは、言語、ロボティクス、バイオ計算、量子計算などの分野を網羅するオープンソースモデルファミリーの拡充を発表し、Nemotron 3.5シリーズ、Kumo構造化データモデル、Cosmos世界モデル、Alpamayo 2 Edge自動運転モデル、BioNeMo RFD4-Proteinaタンパク質設計モデル、およびIsing量子計算モデルを新たに提供しました。これらすべては開発者と企業向けに重み付けやツールを公開しており、ローカルなカスタマイズや独自の展開をサポートしています。

経緯と関連報道

NVIDIAがKumo Relationalを発表:教師あり学習を超える、トレーニング不要の構造化データ向け基礎モデル初号機

NVIDIAは、企業向けリレーショナルデータベース上で離職予測、不正検知、需要予測などの予測タスクを直接実行できる、事前学習済みのリレーショナル基礎モデル「Kumo Relational」を発表しました。タスクの微調整や特徴量エンジニアリング、テーブルの平坦化は不要です。15のデータベースにまたがる41のベンチマークにおいて、XGBoostなどの教師ありモデルを総合的に上回り、SAP SALTの企業向けベンチマークではMRR指標でAutoGluonを8%上回りました。また、最大5,000億行規模のデータベースに対応し、Predictive Query Language(PQL)によりコードゼロで予測呼び出しを実現します。

経緯と関連報道

Reflectionがオープンソースの大規模モデル「Beam」を公開:5,010億パラメータのスパースMoEアーキテクチャで、数百万語規模のコンテキストと多段階の推論制御をサポート

Reflection社は、オープンソースの大規模言語モデル「Beam」(パラメータ数5,010億、実際のアクティベーションは230億/トークン)を発表しました。同モデルは256エキスパートによるスパースMoEアーキテクチャを採用し、100万トークンのコンテキスト長、NVFP4/FP8量化、多段階の推論オプション設定、およびローカルデプロイメントをサポートしています。ただし、すべての技術的主張は第三者による検証を受けておらず、ハードウェア要件も高いため、一般ユーザーには負担が大きいとの見方が広く示されています。

経緯と関連報道

