本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

FlatCake:大規模言語モデルのサービス向けフラットなKVキャッシュストレージアーキテクチャ

arXiv:2610.38355v1 発表タイプ:新規 要旨:KVキャッシュの再利用は大規模言語モデルのサービスを加速させるが、既存のシステムではホストのDRAMとNVMe SSDを階層的なヒエラルキーとして管理しており、DRAMが中間キャッシュとして機能している。しかし、実際の大規模言語モデルのワークロードは、この階層構造の二つの前提をいずれも破っている。第一に、バイモーダルな再利用によりDRAMの時間的フィルタリングが無効化される。というのも、ワークロードは長い再利用距離を持つワンショットブロックか、DRAM容量を超える数ギガバイト規模のエージェントセッションによって支配されており、その結果SSDが重要な読み取りパスに置かれているからである。第二に、DRAMによるステージングと、排出現象に基づくレイアウトがSSDの復元処理をボトルネックにしている。進行中のプレフィックスのためにホストのステージングバッファを保持すると、負荷下で競合が生じてプリフェッチが中断されてしまう一方で、段階的な排出現象によってセッション内のブロックがSSD全体に散らばり、大規模なシーケンシャルリードが妨げられる。我々は…


経緯と関連報道

KORA:AIワークロード向けの決定論優先実行制御

arXiv:2610.35869v1 発表タイプ:新規 要旨:AIアプリケーションは、推論が必要かどうかを判断する前にしばしばモデルを呼び出します。このデフォルト設定は曖昧な生成タスクには有用ですが、構造化され、決定論的で、方針に基づき、照会中心、あるいは直接検証可能な作業には適していません。KORAは、決定論優先の実行制御を導入します。これは、リクエストをタスクパスとして表現し、まず決定論的または構造化された経路を試行し、その結果を検証し、テレメトリを記録した上で、決定論的な処理だけでは不十分な場合にのみモデル候補への経路へとエスカレートする、事前推論用の制御層です。本論文では、KORAを決定論優先の実行制御アーキテクチャとして提示し、再現可能なベンチマークおよび検証ワークロードによる限定的な実証結果を報告します。再

経緯と関連報道

Mirendilが、1,000万トークンのコンテキストを備えた初のモデルであるFern 0.1をリリース

Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

左手にオープンソースモデル、右手にクリエイティブエージェント――Hi3DのAI 3D後半戦

著者|シンシア 編集|鄭玄 2026年のAI3D分野は、まさに微妙な転換点に立っている。一次市場の熱気は依然として高まり続けており、新しいモデルやスタートアップが次々と登場している。単一画像から3Dを生成する手法による正面レンダリングの品質は、ほぼ本物と見紛うほどにまで達している。しかし、華やかなデモの外殻を剥がしてみると、生成結果のほとんどは依然として「回転台での展示」に留まっている。洗練されたキャラクターや機械モデルが照明のもとでゆっくりと回転し、鱗片や衣褶、金属の刻み目まで生き生きと表現される――だが、こうした細部がゲームエンジンへの組み込みや産業シミュレーション、さらには3Dプリントによる実際の製造プロセスに移行すると、たちまち本来の問題が露呈する。構造の破損、背面の崩れ、細部のくっつき、メッシュの編集不可といった課題が一気に噴出しており、膨大な手作業による修正コストが、AIがもたらした効率向上の恩恵をむしろ食い尽くしてしまっている。正面ビューの忠実度だけでは3Dの品質を担保できない――これが新たな業界の共通認識となっている。AI3Dの競争は、「生成できるか」という前半戦から、「実際に活用できるか」という後半戦へと移行しつつある。まさにこの局面において、トッププレイヤーのHi3Dが二枚の布石を打った。生産現場での検証を経たHi3D V1.0基盤を正式にオープンソース化するとともに、クリエイター中心のHi3D Agentを発表。一方では産業の基盤とつながり、もう一方ではリアルな創作ワークフローの全工程に深く根ざすという戦略だ。これに先立ち、設立からまだ3年にも満たない同社は、着実な成果をすでに示していた。半年間で2回のラウンドを連続して完遂し、総額は約5,000万ドルに達した。紅杉中国、IDGキャピタル、美団龍珠など一流投資家が相次いで参画。傘下のHi3Dプラットフォームは120以上の国と地域、200万人超のクリエイターをカバーし、拓竹科技やxToolといった主要デバイスメーカーとも深い統合を進めている。希薄幾何学技術における学術的ブレイクスルーから、プロダクションレベルのモデルのオープンソース化、さらにAgent創作システムによる全工程のフルリンクまで、Hi3Dは3D生成の後半戦への切符を手にしたのだ。 01 3D生成:過大評価されるデモと、過小評価される生産とのギャップ 単一画像から3Dを生成する手法の根本的なロジックには、視点の偏りが内在している。ULIPやUni3Dなどの指標が繰り返し刷新されるなかで、正面重視・全体軽視、外観重視・内部ロジック軽視という傾向が、ここ数年の業界の共通した姿となっていた。しかし、3Dアセットの本質は、回転可能で編集可能、加工可能な立体オブジェクトである。一枚のキャラクター画像の中に、垂

経緯と関連報道

百度が、数百ページに及ぶ文書の解析向けのUnlimited OCR 2をオープンソース化

Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

溶媒:多段階逆合成における長期的視野による推論

arXiv:2610.32308v1 発表タイプ:新規 要旨:多段階の逆合成反応では、目的分子を連続する反応ステップを通じて購入可能な構成要素へと再帰的に変換する必要があります。近年の研究では、この課題に取り組むために大規模言語モデル(LLM)による推論が活用され始めています。その最新の進化において、LLMによる推論は長期的な視野の領域へと拡張されました。すなわち、モデルは相互依存的な各ステップにわたって目標を追求し、環境と相互作用しながらフィードバックに適応します。このような変化により、AI主導の数学研究における画期的な成果が示されるなど、LLMの能力は著しく向上しています。この最先端の領域において、我々はSolventを提案します。これは8B規模のLLMであり、長期的な視野での推論を多段階の逆合成反応へと効果的に拡張することに成功しました。二段階の事後訓練カリキュラムを通じて、Solventは反復的な処理を織り交ぜる能力を習得します

経緯と関連報道

歴史文書の文字起こしにおけるOCRシステムのエンティティ認識対応評価

arXiv:2610.33004v1 発表タイプ:新規 要旨:光学文字認識(OCR)は歴史的アーカイブのデジタル化において不可欠であるが、文字誤り率(CER)などの標準的な評価指標だけでは、氏名や日付、識別子といった有意義な情報が確実に保持されているかどうかを必ずしも反映しない。本研究では、歴史文書におけるOCR品質を評価するための補完的な視点として、OCRエラーのエンティティレベルでの分析を検討する。公開されているBerruttiアーカイブの175件の文書から構成されるベンチマークを用い、受理後に公開予定の手動でアノテーションされた5,209件のエンティティ言及を追加することで、逐次認識型OCRシステム、OCR専用のビジョン・ランゲージモデル、および汎用のビジョン・ランゲージモデルを比較する。全体的な転写精度にとどまらず

経緯と関連報道

Cohereによると、AlibabaのQwenモデルは北京へファイルを送信しようとしたという

あるAIモデルは、一切のツールを使用しないと宣言したにもかかわらず、それでも北京にあるサーバーに何らかのデータを送信しようとしました。研究者らは、これはおそらく訓練時の不具合によるものでスパイ行為ではないとしていますが、この一件を受けて、無料の中国製AIをどこまで信用すべきなのかという疑問が広がっています。

新闻源配图 · TechCrunch · AI
経緯と関連報道

OpenAIが、より高速で性能の高いAIエージェントを半額で提供するGPT-6.1 Terraを発表

OpenAIグループPBCは本日、最先端の人工知能システム群におけるミドル層モデルのアップグレード版であるGPT-6.1 Terraを発表しました。新モデルはGPT-5.6 Terraの後継にあたり、価格は約50%安くなる一方で、コンピュータ利用タスクをより高速かつ高精度に処理します。TerraはOpenAIのラインナップにおいて日常的な用途向けモデルとして位置付けられ、設計されています[…] この記事「OpenAI、より高速で性能の高いAIエージェントを半額で提供するGPT-6.1 Terraを発売」は、元々SiliconANGLEに掲載されたものです。

経緯と関連報道

AWSがCDKベースのホステッドBedrock知識ベースによるスマート検索のリファレンス実装を公開

AWSは2026年10月26日、AWS CDKを用いて構築された企業向けのアジェンティック・リトリーブ(agentic retrieval)のリファレンス実装を紹介するブログ記事を公開しました。これはAmazon Bedrockのマネージド・ナレッジベース専用で、ナレッジベース間のセマンティックルーティング、反復検索、引用付きのソース追跡による回答、さらには7層の観測性をサポートしています。

注目する理由:本資料はAWS公式技術ブログ(2026年10月26日公開)に基づき、既に提供されている機能(例:2024年8月にリリースされたManaged KBやAgenticRetrieveStream API)、検証可能なデプロイ構造(四スタックCDKアプリケーション)、明示的な制限事項(リージョンの可用性、Managed KBのみ利用可能)およびオープンソース実装の詳細に焦点を当てています。性能に関する断言や第三者による保証は一切含まれておらず、事実に基づく正確性と時効性の要件を満たしています。

経緯と関連報道

Nace AI、AIエージェント向け検索用Drexをリリース:BrowseComp-Plusで92.05%、12.6回の検索呼び出し

Nace AIは、Drex for Searchをリリースし、同社のDrex意思決定モデルをAIエージェント向けのドキュメント検索に導入しました。Naceによると、BrowseComp-Plusでは12.6回の検索呼び出しで92.05%のスコアを達成しており、OfficeQA Proではエージェントの操作回数がさらに減少しています。この記事「Nace AI、AIエージェント向けDrex for Searchをリリース:BrowseComp-Plusで12.6回の検索呼び出しで92.05%」は、MarkTechPostに最初に掲載されました。

経緯と関連報道

改ざんされた機械学習:大規模言語モデルによる機械学習研究の評価

arXiv:2610.32114v1 公表タイプ:新規 要旨:AIアライメントの進展を加速する一つの手法は、アライメント研究そのものの一部を自動化することである。そのためには、研究提案における欠陥の特定や、提案された実験が意図した主張を支持するかどうかの評価といった、監督が困難な研究課題に対しても信頼性高く機能するシステムが必要となる。この能力を評価するため、我々はTampered MLを導入する。これは、公開されている機械学習論文から再構成された実験提案と、目的とした方法論的欠陥を導入した最小限に編集された対照案からなる、1,858組の項目ペアからなるベンチマークである。モデルは、提示順序に関わらず、より方法論的に妥当な提案を識別しなければならない。層化抽出サンプルに基づく人間による検証研究では、全体の86%が…

経緯と関連報道

InferSlice:通信事業者の広域ネットワーク上でのSLO主導型LLM推論向けリファレンスアーキテクチャ

arXiv:2610.32638v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)の推論は、企業向けおよび対話型アプリケーションの基幹サービスとしてますます導入されていますが、主権・コンプライアンス・遅延・リソースの局所性といった要件により、集中型クラウド展開の適応性が制限されることがあります。通信事業者は、これらの制約に対処するため、地理的に分散した計算およびネットワークインフラを提供しています。しかし、既存のLLMサービスフレームワークは、緊密に結合されたデータセンター向けに設計されており、地理的に分散し多様なリソースの調整には十分なサポートを提供していません。そこで私たちは、通信事業者インフラ上でサービスレベル目標(SLO)主導型のLLM推論を実現するためのリファレンスアーキテクチャであるInferSliceを提案します。本アーキテクチャは、ネットワークスライシング、GPUパーティショニング、エラスティックなサービス提供、ならびに可観測性を統合しています。

InferSlice: A Reference Architecture for SLO-driven LLM Inference over a Telco Wide-Area Network
経緯と関連報道

クエリの抽象度が古典アラビア詩の検索精度を左右する:BM25と稠密エンコーダーの性能は、クエリの抽象度に応じて顕著に分かれる

2026年10月26日付のarXivに掲載された最新の研究(arXiv:2610.31821v1)によれば、古典アラビア詩の検索タスクにおいては、ユーザーの詩句の記憶残存度(例えば半行を覚えているかどうか)が、モデルの性能よりも検索精度を決定する上でより重要な要因であることが示されています。BM25は、「舌尖効果」系のクエリでは、8Bパラメータの最先端モデルを含むすべての稠密符号化器を上回る一方で、抽象的なクエリでは大きく劣後することが明らかになりました。

新闻源配图 · arXiv cs.CL

注目する理由:本研究は、二重コーパス、三重インデックス方式、および二重評価プロトコルによる体系的なベンチマークテストを通じて、クエリの抽象度が異なる検索パラダイム(形態素ベース対稠密ベクトル)に与える支配的な影響を初めて定量的に明らかにし、人間のアノテーターとオープンソースの重み付けモデルによる二重検証を経て、その結論は方法論的普遍性と実証的堅牢性を備えている。

経緯と関連報道

エッジによるLLMトレーニングの民主化:課題・システム・今後の展望

arXiv:2610.32215v1 発表タイプ:新規 要旨:現代のGPUデータセンターにおける計算能力の向上により、一部の産業大手企業が膨大なデータを用いて大規模言語モデル(LLM)を訓練し、展開できるようになりました。しかし、これらのモデルとその学習データの圧倒的な規模は、集中型の開発をますます維持困難にすると同時に、関連するプライベートデータを保有しながら同等のインフラを持たない小規模機関を排除しています。本論文では、分散型LLMトレーニングに関する我々の立場を、事前学習および微調整のパラダイムを中心に整理し、フェデレーテッド学習、スプリット学習、そして分散型アプローチを取り上げ、それらが地理的に分散した環境下で、多様なハードウェアや信頼性の低い接続状況においてどの程度実用可能かを評価します。さらに、我々は「統一された」システムを提案します。

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
経緯と関連報道

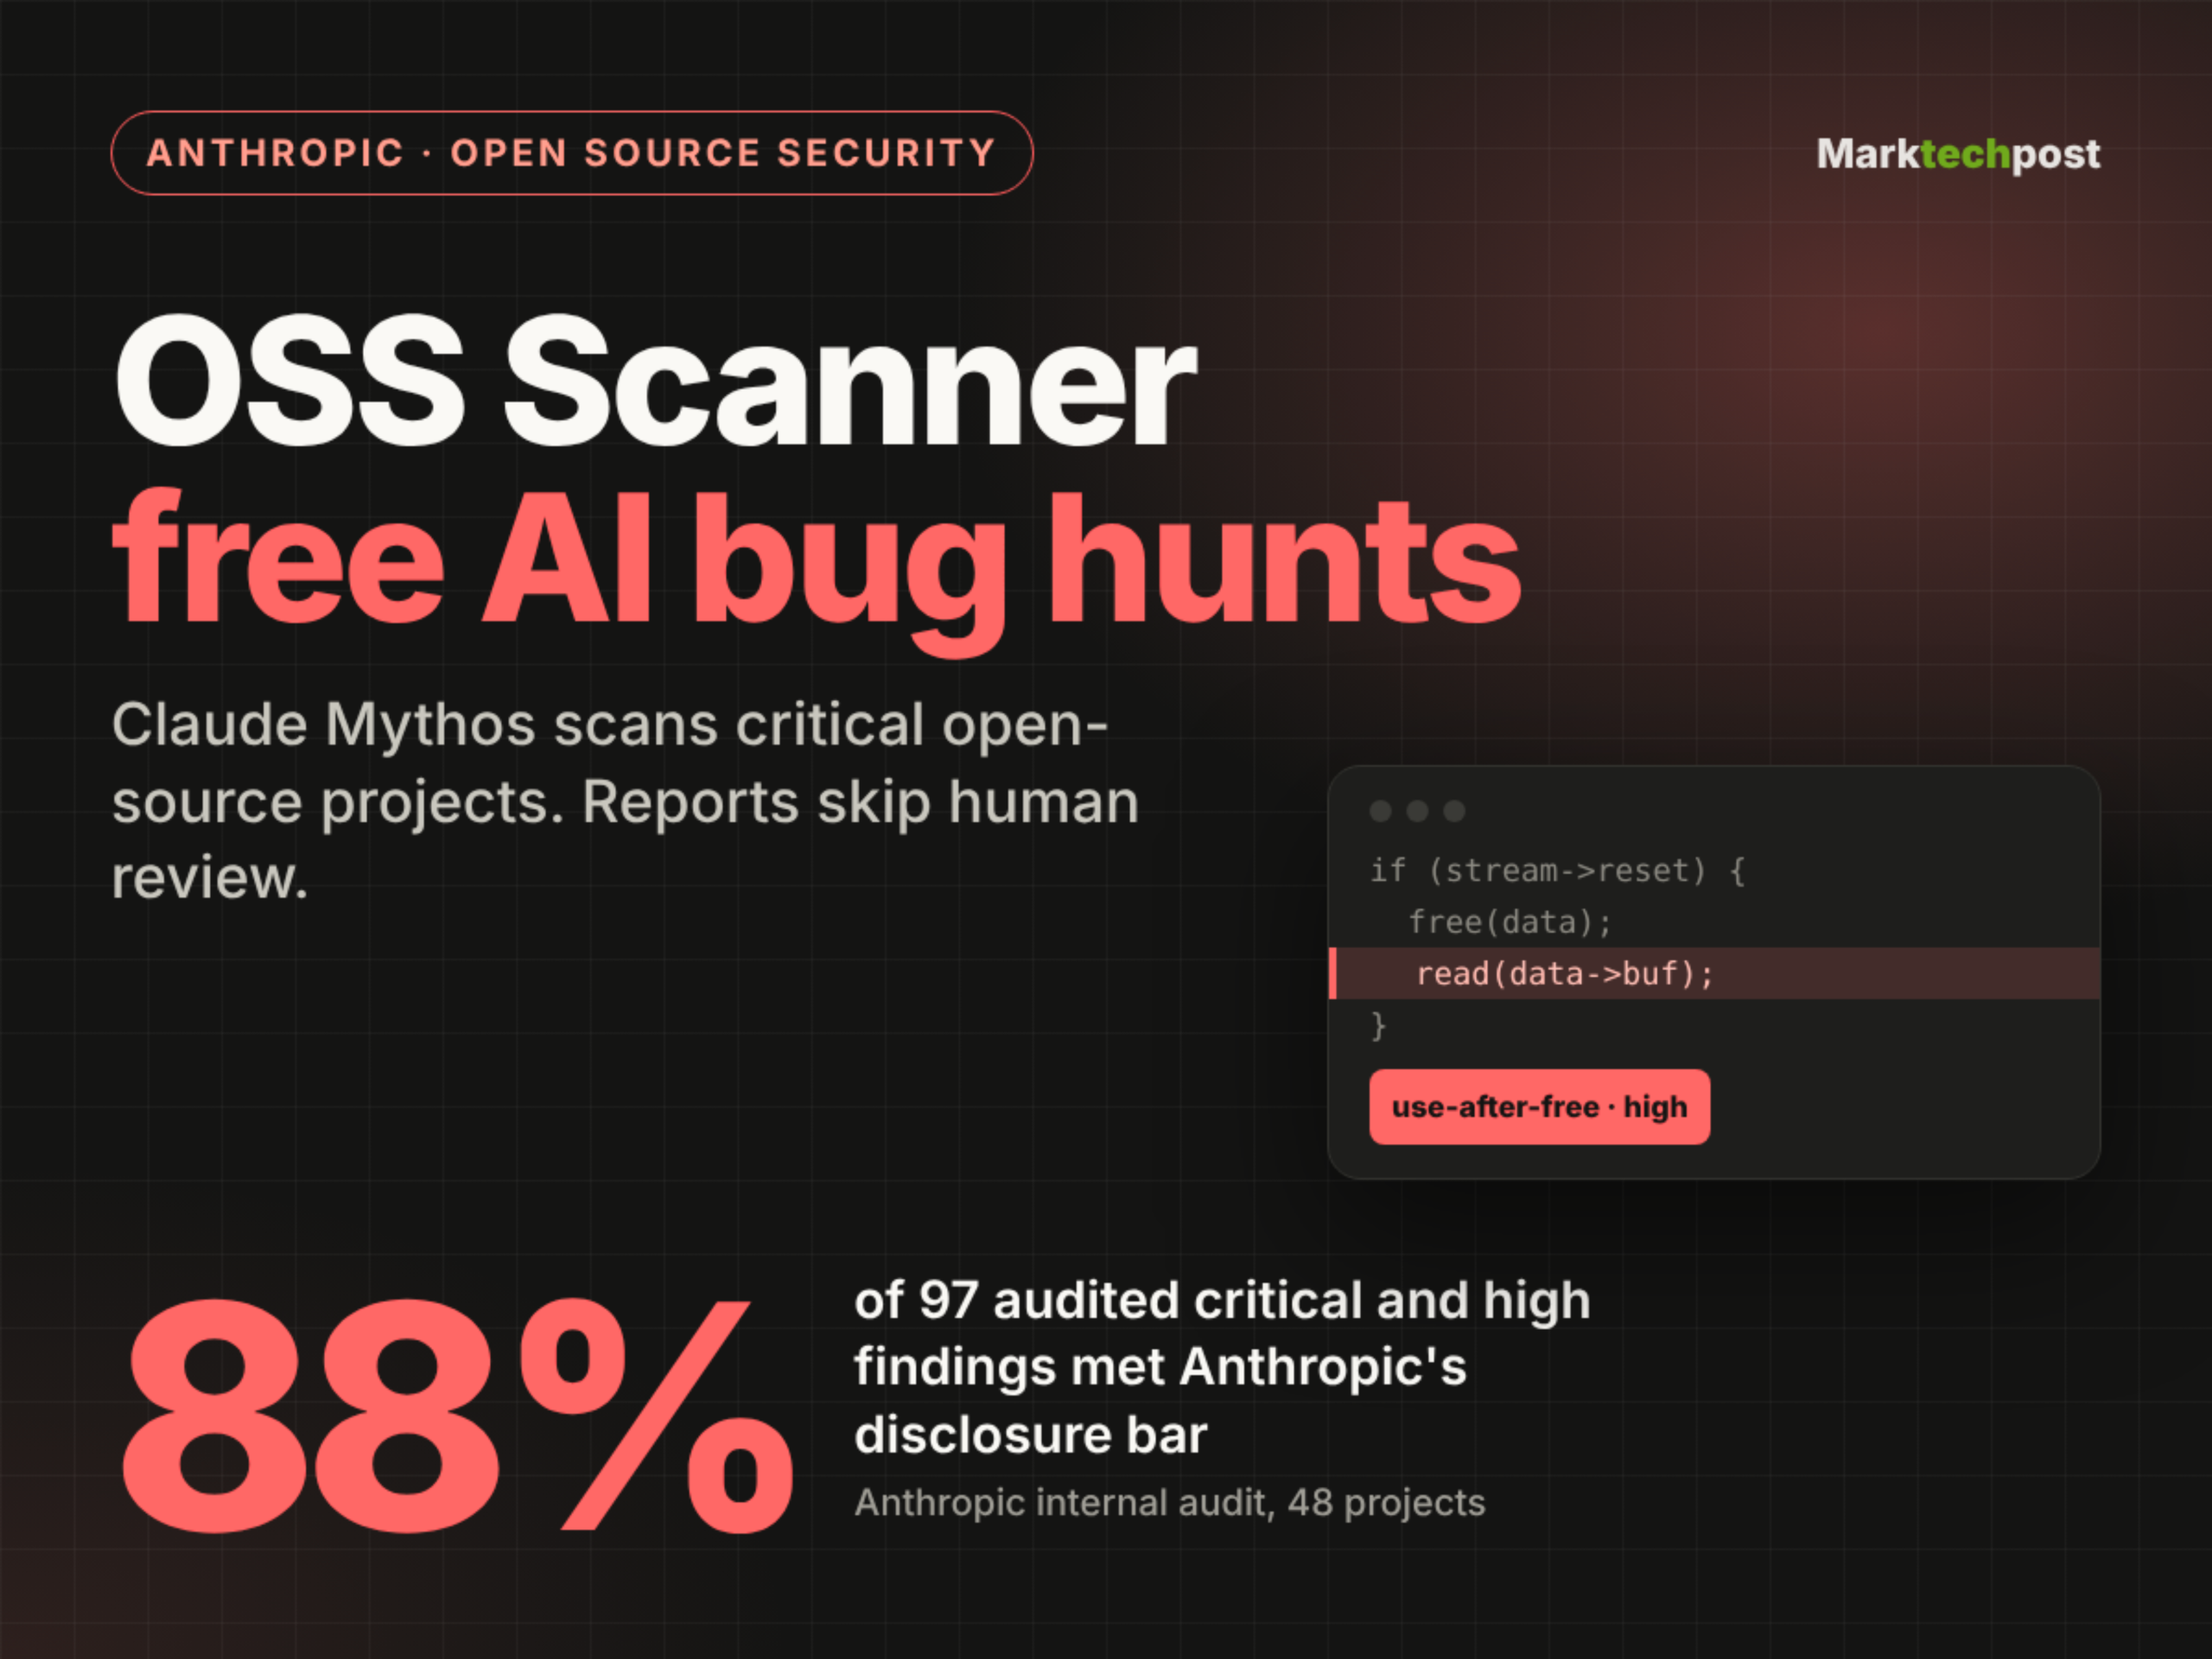
Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。

経緯と関連報道

CiteAnchor:幻影引用の検出と解決のためのソース意識型グラウンディング

arXiv:2610.30355v1 発表タイプ:新規 要旨:幻影引用は、科学的主張の背後にある証拠を追跡し、その信憑性を検証することを困難にします。これらの引用を検出するのは、書誌情報が不完全であったり、ソースの種類や出版物のバージョンによって異なるため、非常に難しいです。妥当な一致だけでは、その引用が正当化されるわけでも、その背後にあるソースが特定できるわけでもありません。私たちは、ソースの復元可能性について注釈付きで構築された、実世界の幻影引用423件からなるベンチマークであるCiteResolveを提案します。さらに、ソースごとに検索とフィールドレベルの検証を適応させ、引用の妥当性および固有のソースが復元可能かどうかを個別に判定する、ソース意識型グラウンディングフレームワークであるCiteAnchorを提案します。既存の検出ベンチマークにおいて、CiteAnchorはGPT-5.6を用いてF1スコア0.841を達成しました。

CiteAnchor: Source-Aware Grounding for Hallucinated Citation Detection and Resolution
経緯と関連報道

新たな研究は、言語間貧刺激(CPOS)実験パラダイムを提案し、言語モデルの階層的汎化能力における条件付き移行を明らかにした

2026年10月24日、arXivは論文2610.30960v1を公開し、言語モデルが多言語間の継続的学習において、源言語(L1)の階層構造に関する証拠を目標言語(L2)へ移行する能力を定量化するための、跨言語貧刺激(CPOS)実験デザインを提案した。実験の結果、この移行は部分的には成立するものの完全ではなく、しかも言語ペアおよび語彙の重複度に大きく依存することが示された。

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

注目する理由:本研究は、制御可能な言語間の貧刺激フレームワークを初めて構築し、『言語の普遍的構造』が非言語的要因(例えば位置エンコーディングの初期化など)のみによって駆動されるのではなく、言語間移行の認知的基盤を形成しているかどうかを直接検証した。その結論は、大規模言語モデルにおける文法習得メカニズムおよび多言語間のアライメント戦略を理解するうえで、方法論的・理論的な両面において重要な価値を有している。

経緯と関連報道

Lighthouse:米国民権運動史に特化した信頼性の高いデジタルアシスタントが初公開

論文arXiv:2610.30158v1は2026年10月24日に公開され、南カロライナ州のアーカイブデータに基づく米国民権運動期の歴史を探索するための初の専用デジタルアシスタント「Lighthouse」について紹介しています。その核心的な革新点は、信頼できるコンテンツとユーザーへの危害軽減を設計原則として掲げ、ニューラル・シンボリックハイブリッドアーキテクチャを採用し、大規模言語モデルと規則ベースのシンボリック推論を統合していることです。

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

注目する理由:本研究は、AIを活用した歴史探求を初めて公民権運動という敏感かつ重要な歴史的時期に焦点を当て、一般的なチャットボットとは異なり、「信頼性」と「被害モデリング」という二重の制約を明示しました。その方法論(ニューラル・シンボリック統合)、評価手法(専門家による合意に基づく主観的設問のゴールドスタンダードを含む)、およびデータ規模(1万8千件を超える一次資料)はいずれも学術的な模範的価値を有しています。

経緯と関連報道