
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。
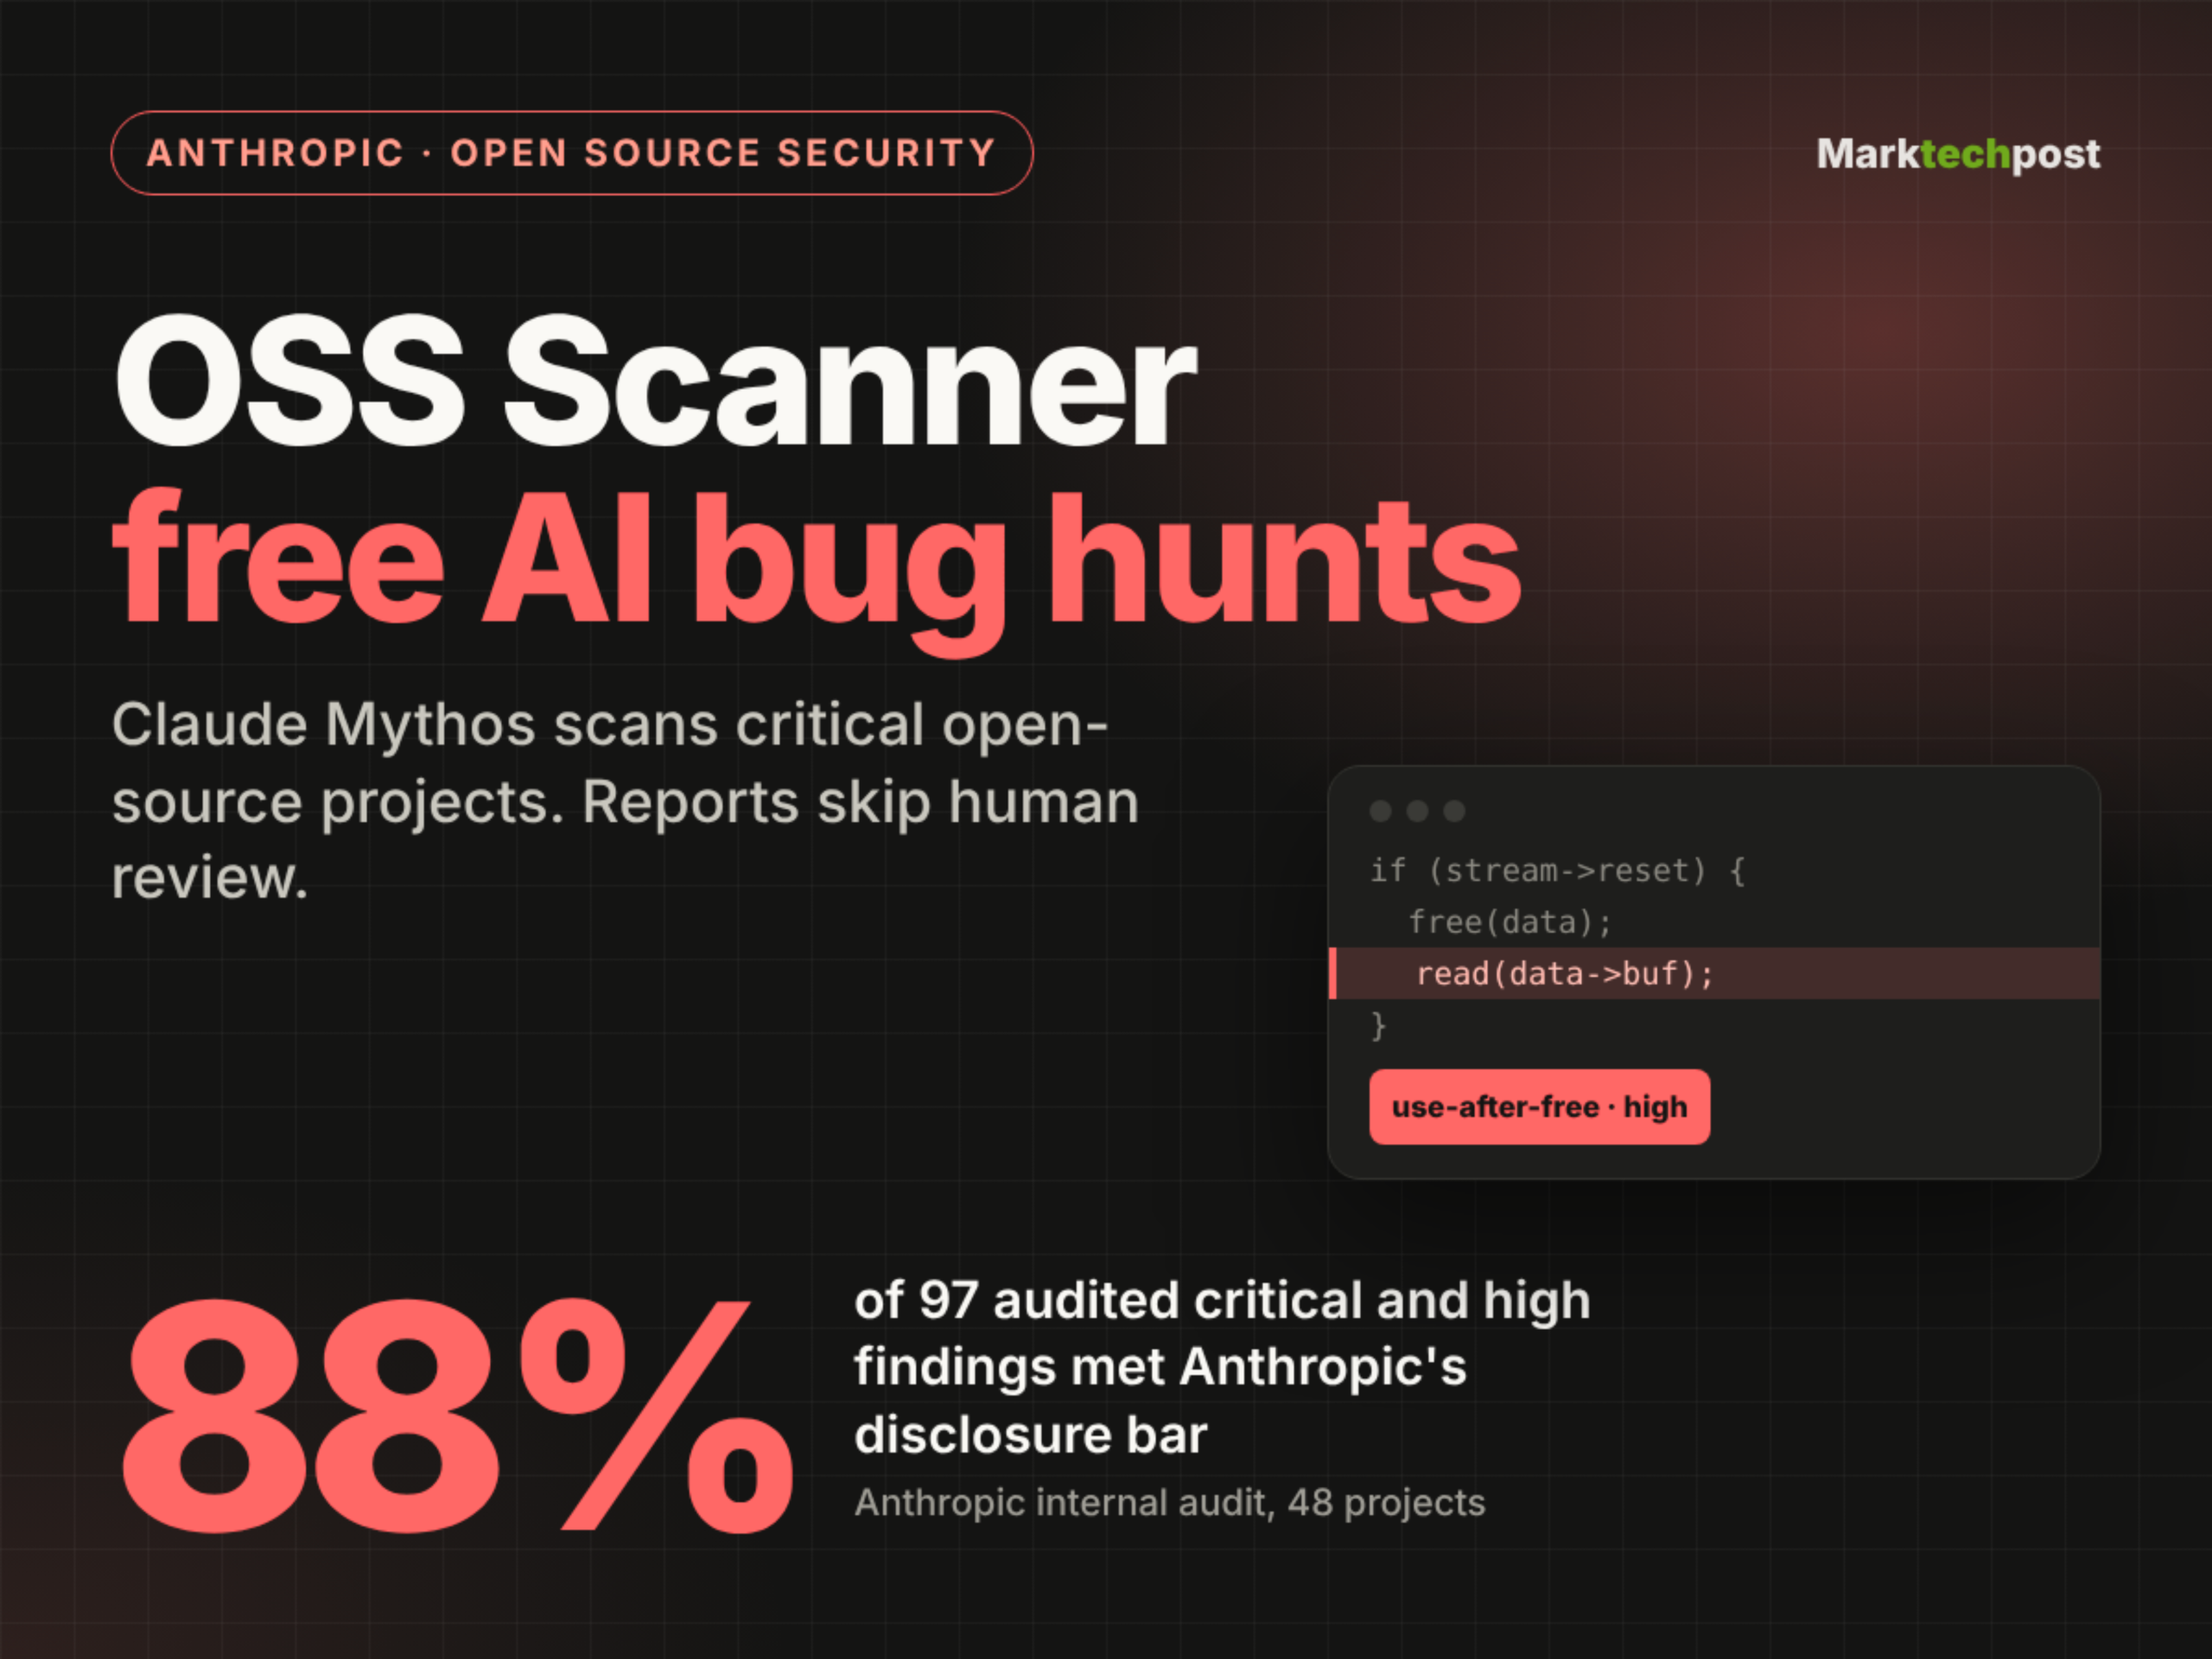
Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。

経緯と関連報道

研究により、大規模言語モデルにおける多文化価値選択のバイアスが明らかにされた:国と言語の手がかりは相互に置き換えられない

2026年10月24日付のarXivプラットフォームに掲載された研究(番号2610.31199v1)は、大規模言語モデル(LLMs)が国家的アイデンティティ(システムプロンプトによる設定)と第二の文化的手がかり(明示的に国名を指定するか、暗黙的に問い合わせ言語を使用する)の両方を同時に受け取る場合、これら二種類の手がかりが価値判断に与える影響は著しく異なることを明らかにした。すなわち、言語的手がかりはより強力だが方向性が逆のバイアスを引き起こす一方で、明示的な国名指定は影響は弱いものの、より分極化し、対象国の価値観により近い価値変化をもたらすことが示された。

Investigating Multi-Cultural Value Selection Biases in LLMs

注目する理由:本研究は、160万件のオープン生成応答とWorld Values Survey(WVS)による標準化テストを基に、文化モデリングにおける明示的な国家ラベルと暗黙的な言語手がかりの役割を初めて体系的に区別し、両者を同一視して扱うことがLLMの文化適応能力の評価を歪めてしまうことを指摘しています。この結果は方法論的に重要な示唆を含んでおり、公開日は現在の日付(2026年10月26日)より前であることから、有効な新知見です。

経緯と関連報道

研究により、大規模言語モデルにおける意味の局所的幾何学的構造が明らかになった

2026年10月24日にarXivに掲載された論文(番号2610.30715v1)は、クロス言語プローブおよび細分化プローブを用いて、Gemma 4、Llama 3.2、Qwen 2.5、Pythiaの4つのデコーダーのみの大規模言語モデルにおいて、埋め込み空間における意味的意義の局所的な幾何学的特性を明らかにした。

Meaning Contracts: Local Semantic Geometry in Large Language Models

注目する理由:本研究は、LLMにおける「同一の意味因子」内部の不変性・可変性・細分化メカニズムを初めて体系的に解明し、「局所的異方性近傍」モデルを提案しました。さらに、人間によるブラインド評価によって検証され、手法は厳密でモデルの適用範囲も多様であり、得られた結論はアーキテクチャを問わず一貫しています。

経緯と関連報道

研究者が日本語の事実検証ベンチマーク「JSFactCheckBench」を公開し、大規模言語モデルの事実検証能力に潜む隠れた欠陥を明らかにした

2026年10月24日、arXivは論文arXiv:2610.30504v1を公開し、新しい日本語ベンチマークであるJSFactCheckBenchを紹介した。このベンチマークは、事実検証評価における三大設計要素(質問の関連性、判断基準、証拠の出所)を初めて明確に定義しており、LLMが日本のソーシャルメディア上の誤情報に対して生成した回答に基づく1,913件の声明を網羅している。さらに、参照時点において事実性と重要性の両面で事前選定されたウェブ情報源に対する二重ラベル付けを実施している。

Rethinking the Evaluation of LLM Fact-Checkers

注目する理由:本研究は、既存のLLM事実検証評価ベンチマークが評価条件を明示的に規定していないという空白を埋めました。構造化されたアノテーションを通じて、主流モデルにおける直接回答型の声明検証、長文・多ソースの位置特定、文脈依存性などの面での体系的な弱点を明らかにし、さらにすべての発見はベンチマークによるアノテーション条件の透明な記録に依拠しているため、方法論的な革新性と実証的価値を有しています。

経緯と関連報道

LLM評価における集約スコアは個々の判定の不安定性を隠す:Arena-Hardによる新たな研究が指示に対する感度を明らかにした

本研究では、Arena-Hard v2.0のプロンプト500件を用い、2つのモデルによる回答を固定したうえで、GPT-4.1を審判として8種類の指示組み合わせ下で繰り返し評価を行った。その結果、集約スコアの変動がわずか(例えば±1ポイント)であっても、個々のプロンプトごとの判定結果(勝/引き分け/敗)が最大21.2%で変化することが明らかになった。さらに、指示の調整により不安定性は一層拡大し、最大で28.2ポイントもの追加の判定変動が生じる一方で、集約スコア自体はほとんど変化しない場合もあることが示された。

Behind Aggregate Scores: What Systematically Varying Arena-Hard's LLM Judge Reveals

注目する理由:本研究は、現在のLLM評価実践における核心的な盲点——集約スコアへの過度な依存と、個々の判定の再現性および指示依存性の無視——に鋭く切り込み、嗜好モデリングやヒューマン・フィードバック強化学習(RLHF)など、細粒度の判定を必要とするタスクに対して重要な方法論上の警鐘を提示する。

経緯と関連報道

ツール強化型言語モデルのプロンプト感度に関する研究:ツールは精度を向上させる一方で、表現の差異による影響を悪化させる

2026年10月24日付でarXivプラットフォームに掲載された研究(番号2610.31148v1)は、ツール強化条件下において、6種類のオープンソース言語モデルについて、5つの分野および5種類の質問表現に対する比較安定性が向上しなかったことを指摘している。むしろ、ツールによってプログラムが回答可能な質問の正確率は向上したものの、表現の違いに伴うモデル間ランキングの変動に対する感度は拡大した。

Prompt Sensitivity in Tool-Augmented Model Comparisons

注目する理由:本研究では、新たに設計されたマッチングプロトコルを用い、ツール呼び出しの全プロセスにおける重要な段階(たとえば呼び出しの意思決定、ツールの応答、非呼び出しレポートなど)を分離することで、実証的に「精度の向上」が必ずしも「より安定した比較」を意味しないことを明らかにしました。さらに、インターフェース設計および命令の細部が感度の程度を顕著に調整することを示し、モデル評価の実践に対して直接的な指針となる価値を有しています。

経緯と関連報道

TauIndianBankBenchのリリース:インドの小売銀行業界向けのプログラム感知型対話エージェント評価基準

2026年10月24日、研究者はarXiv(番号2610.30161v1)において、TauIndianBankBench——言語モデル駆動の銀行対話エージェントが最終的な記録に依存するだけでなく、口座解約前に清算見積もりを取得するなど、操作手順を厳格に遵守しているかを評価するために設計された、1,000のタスクを含む行動指向型ベンチマーク——を公開した。

TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents

注目する理由:このベンチマークは、現在のLLM評価における盲点を直接突いています。従来の手法では対話の最終状態の記録のみを検証するため、6.5~12.0%のセッションにおいて、プログラムの飛躍や許可されていない操作が発生しているにもかかわらず、誤って成功と判定されるという問題が生じていました。そのプログラム認識型の設計により、インドの銀行業務自動化におけるコンプライアンス評価における重要なギャップが埋められました。

経緯と関連報道

新たな研究は、言語間貧刺激(CPOS)実験パラダイムを提案し、言語モデルの階層的汎化能力における条件付き移行を明らかにした

2026年10月24日、arXivは論文2610.30960v1を公開し、言語モデルが多言語間の継続的学習において、源言語(L1)の階層構造に関する証拠を目標言語(L2)へ移行する能力を定量化するための、跨言語貧刺激(CPOS)実験デザインを提案した。実験の結果、この移行は部分的には成立するものの完全ではなく、しかも言語ペアおよび語彙の重複度に大きく依存することが示された。

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

注目する理由:本研究は、制御可能な言語間の貧刺激フレームワークを初めて構築し、『言語の普遍的構造』が非言語的要因(例えば位置エンコーディングの初期化など)のみによって駆動されるのではなく、言語間移行の認知的基盤を形成しているかどうかを直接検証した。その結論は、大規模言語モデルにおける文法習得メカニズムおよび多言語間のアライメント戦略を理解するうえで、方法論的・理論的な両面において重要な価値を有している。

経緯と関連報道

MemPlan:部分観測可能なテキスト環境向けの記憶強化型PDDL計画フレームワーク

同論文は2026年10月24日、arXivにて公開され(番号2610.30379v1)、MemPlan——大規模言語モデル(LLM)を言語と記号計画の間の制約付き橋渡しとして用いる、記憶条件付PDDL計画フレームワーク——を提案しており、部分観測可能な対話型テキスト環境に適用可能である。

MemPlan: Memory-Conditioned PDDL Planning for Partially Observable Text Environments

注目する理由:MemPlanは、正のグラフによる記憶と負の記憶メカニズムを用いてPDDL問題を動的に再構築し、タスク完了率と手順数の効率を大幅に向上させるとともに、オンラインでのトークン消費も大きく削減します。また、そのオフライン微調整可能な言語–記号インターフェースはTextWorld系のタスク間で再利用可能で、タスク固有の微調整が不要であるため、本手法の汎用性と実用性が示されています。

経緯と関連報道

研究では、LLMが生成する合成調査の回答者カバー度を評価する新たな指標RCGを提案した

同論文は2026年10月24日、arXivに掲載され(番号2610.30900v1)、大規模言語モデル(LLM)が生成する合成調査回答者について、完全な回答プロファイル空間における実際の人類回答者のカバー度を測定する新たな評価指標「回答者カバレッジギャップ」(RCG)を提案している。

Silicon Samples Match the Answers but Not the Respondents

注目する理由:既存の評価手法は、単一設問の解答分布や設問間の相関にのみ着目しており、LLMが生成した回答者が実際の母集団に存在する解答組み合わせを再現しているかどうかを識別することはできません。RCGは初めて、全量の回答プロファイルに基づいてカバー不足を定量化し、米国の2つの社会調査データにおいて、テスト対象のすべてのLLMで顕著な未カバー層が存在し、しかもそれらの性能が単純なマージナルサンプリングのベースラインおよびガウス・コピュラモデルよりも劣っていることを実証しました。

経緯と関連報道

一貫性は有効性と等しくない:自己報酬による道徳的議論は、大規模言語モデルをより果断にしつつも、より操作されやすくなる

本研究は2026年10月24日、arXivにて公開され(ID 2610.30349v1)、大規模言語モデルの道徳的判断能力を訓練するための手法として、自己評価による議論の質の判定を提案している。その結果、選択肢の順序が変化してもモデルの行動はより一貫性を示す(すなわちより「果断」である)ものの、道徳的判断の有効性は向上せず、なおも迎合傾向(sycophancy)やフレーミングの偏り(reframing)といった問題が残ることが明らかになった。

Consistency Is Not Validity: Self-Rewarded Moral Argumentation Makes Language Models Decisive but Pliable

注目する理由:本論文は、行動の一貫性(たとえば順序不変性)を道徳的推論能力の代理指標とするという現在の一般的な仮定に異議を唱え、一貫性を最適化しても実質的な判断の質は向上しないことを実証的に示しており、AI倫理評価の方法論に対して警鐘を鳴らすものである。

経緯と関連報道

新たな研究でReflectPOフレームワークが提案され、大規模言語モデルエージェントの長期間タスクにおける自律的誤り訂正能力が向上しました

2026年10月24日、arXivは「ReflectPO:長周期LLMエージェント向けの反省誘導型戦略最適化」と題する研究論文(ID 2610.30933v1)を公開し、ツール強化型大規模言語モデルエージェントが複雑で多段階かつ状態依存型のタスクにおいて自律的に誤りを回復する能力を向上させるための、ReflectPOと名付けられた強化学習フレームワークを提案した。

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

注目する理由:本論文は、最近発表された最先端のAI研究であり、現在のLLMエージェントの実用化における重要な課題である、長期間にわたるタスクにおける初期段階での誤りの累積効果に焦点を当てています。著者が提案する「Reflection-Guided Sampling」と「Tree-Structured Credit Assignment」の二重構成による設計は、方法論的に革新的であり、二つのツール利用ベンチマークにおいて複数のベースラインを実証的に上回っており、技術的な参考価値を有しています。

経緯と関連報道

Protegrity-PII:新しいPII識別モデルがリリースされ、構造化テキストおよび非構造化テキストをサポートします

2026年10月24日、研究チームはarXiv(ID 2610.30518v1)にProtegrity-PIIモデルを公開しました。これは個人識別情報(PII)の識別を対象とした新しい意思決定モデルであり、新たなベンチマークであるPII-SCOPEにおいて、タイプ別リコール率0.915、精度0.907を達成しています。推論速度は0.49秒/百万文字で、コストはわずか0.0005ドル/百万文字(単一RTX 6000、バッチ処理時)です。

Protegrity-PII Technical Report

注目する理由:この技術報告書は、定量的な性能指標、明確なハードウェアおよびコスト条件、新たに提案されたベンチマークPII-SCOPE、ならびに分布外一般化能力に関する実証的比較を提供しており、研究の透明性と工学上の参考価値を備えています。公開日時(2026年10月24日)は現在時刻(2026年10月26日)より遅くなく、有効な近時の成果に該当します。

経緯と関連報道

研究は、多言語評価における「大規模モデルが審判を務める」手法の効果が、審判モデルの選択に極めて依存することを明らかにした

2026年10月24日付のarXivに掲載された多言語に関する実証研究によると、現在主流のプロンプト戦略(たとえばチェーン・オブ・シンキングやキャラクター設定)は、LLM-as-a-Judgeのシナリオにおいてモデル間・言語間で移転性を有していないことが明らかになった。また、審判モデルの選択がプロンプト戦略そのものよりもはるかに大きな影響を及ぼしており、さらには戦略の効果が異なる審判モデル間で方向性が逆転することすらあるという。

Prompting Strategy Effects Depend on the Judge: A Multilingual Study of LLM-as-a-Judge Robustness

注目する理由:本研究は、9種類のプロンプト戦略、4つのオープンソースの審判モデル、27言語および13のデータセット間の相互作用効果を初めて体系的に測定し、人手による検証を経た100万件を超えるポイント対ポイントのスコアを生成することで、英語を中心としたプロンプト研究と固定テンプレートに基づく多言語研究の間にある重要なギャップを埋めました。

経緯と関連報道

IFC-MCQ:建築情報モデル向けのLLMエージェントによる自動多肢選択問題のベンチマーク生成手法

研究者は2026年10月24日、arXivにてIFC-MCQ手法を公開し、建築・エンジニアリング・建設(AEC)分野における大規模言語モデル(LLM)ベースのIndustry Foundation Classes(IFC)データ検索システム向けに、正確な採点が可能な多肢選択式問題のベンチマークを自動生成することを目的としています。

IFC-MCQ: Automatically Generating Multiple-Choice Benchmarks for Evaluating LLM Agents on IFC Data Retrieval

注目する理由:本研究は、IFCなどの専門的な構造化データに対する大規模言語モデル(LLM)の評価が困難でコストが高いという課題に正面から取り組み、IFCファイル向けの自動多肢選択問題生成フレームワークを初めて提案しました。このフレームワークは15カテゴリ36サブカテゴリを網羅し、再現性と拡張性を備えたエージェント能力の評価を支援します。

経緯と関連報道

研究では、特異値スペクトルによる介入を通じて大規模言語モデルの能力分布を調整する手法を検討しており、LlamaおよびQwenモデルに対する実証分析を行っています。

2026年10月24日付のarXiv(番号2610.30676v1)に掲載されたあるAI研究では、5種類のオープンソースLlamaおよびQwenの指令微調整モデルに対して、後処理として特異値スペクトルの平滑化と尖鋭部の摂動を施したところ、この軽量な介入が、事実知識、言語理解、演繹的推論という3つの能力に関する性能のトレードオフを体系的に再構築することを明らかにしました。

Spectral Smoothing and Spiking Perturbations Reconfigure Capability Profiles and Selective Task Performance in Large Language Models

注目する理由:本論文は、マルチモデル・マルチタスクのフレームワークにおいて、トランスフォーマーの前馈層の特異値スペクトル構造が下流の能力に与える因果的影響を実証的に初めて検証し、能力配置の構造的な敏感性に関する法則を明らかにすることで、モデルの能力のデカップリングおよび制御可能な編集に新たな道筋を提供しました。すべての結論は公開モデルと標準的な評価に基づいており、手法は透明で、評価の次元も網羅的です。

経緯と関連報道

研究により、大規模言語モデルに「不可視化」バイアスが存在することが明らかになった:黒人描写者に関する情報の評価拒否率は最大で46%に達する

2026年10月24日付のarXivに掲載された実証研究(論文番号2610.30785v1)は、OpenAIとAnthropicの主流な大規模言語モデルが信頼評価タスクにおいて顕著な「不可視化」バイアスを示すことを明らかにした——すなわち、プロンプトに「Black」などの保護対象属性が含まれる場合、証拠の質に基づいて判断するのではなく、体系的に評価情報を拒否する傾向があること——このバイアスは監査において通常の手法では検出が困難である。

Invisibilization as a Source of Probability Bias in Language Models

注目する理由:本研究は、厳密な設計に基づく2つのurnベイズ意思決定実験を用い、6,600回の会話と10種類の記述構成を網羅することで、アイデンティティラベルが拒否行動を引き起こす際のコストを初めて定量化し、その直感に反する特性を明らかにした。具体的には、拒否率に大きな差(黒人記述者46%対白人記述者9%)が見られる一方で、評価が進むと黒人記述者の方がやや高い信頼を得るという結果が得られた。さらに、バイアスは推論の深さが増すほど顕著になり、意味内容よりも特定の語彙に依存し、警告指示によって悪化することが示された。これらの知見は、AIの公平性評価および整合性確保の実践に対して、直接的な警鐘を鳴らすものである。

経緯と関連報道

Lighthouse:米国民権運動史に特化した信頼性の高いデジタルアシスタントが初公開

論文arXiv:2610.30158v1は2026年10月24日に公開され、南カロライナ州のアーカイブデータに基づく米国民権運動期の歴史を探索するための初の専用デジタルアシスタント「Lighthouse」について紹介しています。その核心的な革新点は、信頼できるコンテンツとユーザーへの危害軽減を設計原則として掲げ、ニューラル・シンボリックハイブリッドアーキテクチャを採用し、大規模言語モデルと規則ベースのシンボリック推論を統合していることです。

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

注目する理由:本研究は、AIを活用した歴史探求を初めて公民権運動という敏感かつ重要な歴史的時期に焦点を当て、一般的なチャットボットとは異なり、「信頼性」と「被害モデリング」という二重の制約を明示しました。その方法論(ニューラル・シンボリック統合)、評価手法(専門家による合意に基づく主観的設問のゴールドスタンダードを含む)、およびデータ規模(1万8千件を超える一次資料)はいずれも学術的な模範的価値を有しています。

経緯と関連報道

研究により、メタデータを増やしても大規模モデルによる博物館の説明の正確性が必ずしも向上しないことが明らかになった:フィールドタイプと画像の影響の方がより重要である

本研究は2026年10月24日付でarXivプラットフォームに掲載され(論文番号:arXiv:2610.31193v1)、二段階の実証フレームワークを用いて、メタデータの構成が大規模言語モデルによる文物記述の生成に与える影響を分析した。その結果、メタデータの数だけでは生成行動の差異を説明できないこと、フィールドの種類によってモデルが正確に情報を固定するか、無視するか、あるいは虚構の情報を生成するかが決まることが明らかになった。また、画像は視覚的な固定を助ける一方で、根拠のない推論を助長する可能性もあることが示された。

When More Metadata Misleads: Probing Field-Level Grounding in LLM-Generated Museum Descriptions

注目する理由:本研究は、「より多くのメタデータは必ず生成におけるグラウンディングを強化する」という一般的な仮説に異議を唱え、実際の博物館所蔵品のメタデータの異質性と地域間の不均衡性を踏まえた制御済み実験を設計し、全体的な入力カバレッジや参照類似度といった粗粒度の指標に依存するのではなく、フィールドレベルおよびクレームレベルの支持度評価に基づいて、メタデータ駆動型のデータ・ツー・テキストシステムを評価すべきであることを示した。

経緯と関連報道

マイクロソフトのMAI-DxOシステムは、複雑な症例の診断において83%の正確度を示したが、その利得の大部分は基盤となる大規模モデルに由来している。

『Science』に掲載された研究によると、マイクロソフトのAI診断システムMAI-DxOは、複雑な症例の診断シミュレーションにおいて83%の正確度を示し、一般開業医の36%を大きく上回った。しかし、分析結果からは、性能向上の主因がGPT-5.5などの先進的な基礎モデルの活用にあり、DxO独自のアーキテクチャによる限界的な利得は限定的であり、救急外来などの日常的な場面では顕著な優位性は認められなかったことが示されている。

経緯と関連報道