
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

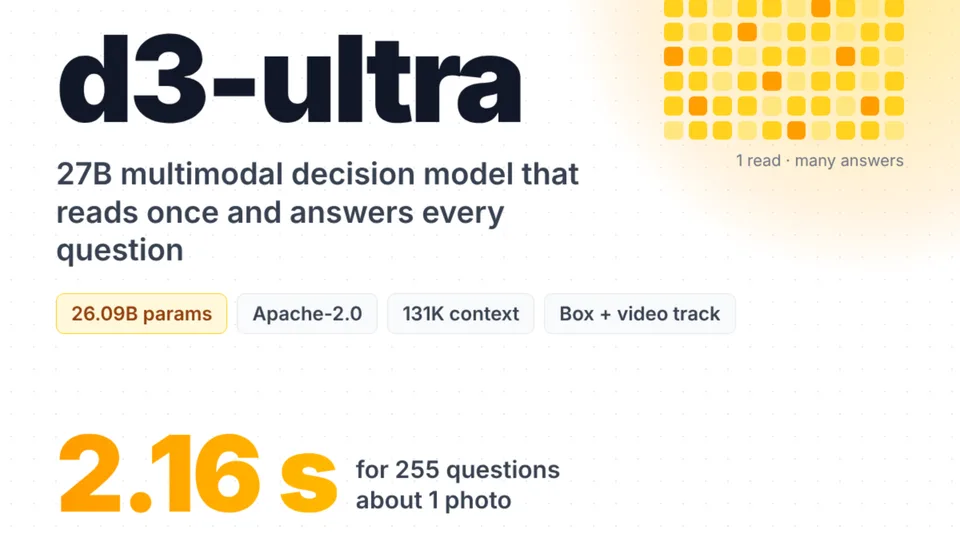
vLLM セマンティックルーターが d3-ultra をリリース:270億パラメータのオープンなマルチモーダル意思決定モデル

vLLMセマンティックルーターは、270億パラメータ規模のオープンウェイトなマルチモーダル意思決定モデルであるd3-ultraをリリースしました。同モデルはテキスト、画像、動画を一度に読み込み、各回答に対する確率を返却し、チームのSR-Textテストで87.2点を獲得しています。この記事「vLLMセマンティックルーター、270億パラメータ規模のオープンマルチモーダル意思決定モデルd3-ultraをリリース」は、MarkTechPostに最初に掲載されました。
新闻源配图 · MarkTechPost
経緯と関連報道

DualPace:大規模言語モデルの推論における、非同期スケジューリングとGPU–CPU協調デコード

arXiv:2610.33501v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)のサービスでは、推論スループットを向上させるためにバッチ処理が用いられるが、キー値(KV)キャッシュはシーケンス長に応じて増大し、GPU上での並行処理能力を制限する要因となっている。CPUオフロードによりホストメモリを活用してKV容量を拡張することは可能だが、既存のシステムは依然として大部分がGPUに依存しており、CPU上に常駐するリクエストが進捗するのは、GPUスケジューラが適切なオーバーラップの機会を提供した場合に限られる。その結果、ホストメモリとCPU計算は独立したサービス資源として機能せず、負荷下ではCPU側の進捗が断続的になり、末端のトークン間遅延(ITL)が過剰に増大するという問題が生じる。本稿では、ホストを独立してスケジュール可能なデコードエンジンへと変える、LLM向けの実行時環境であるDualPaceを提案する。DualPaceは、スケジューリング権限を二つのエンジン間に分割し、GPUエンジン

経緯と関連報道

AI需要の高まりを背景に、マーベルの初期の半導体製造への賭けが実を結ぶ

8年前、チップメーカーのマーベル・テクノロジー社はナノメートル単位での技術革新を一気に進めることを決断し、以来その成長軌道は着実に上向き続けている。半導体製造において、ナノメートル表記はトランジスタの正確な物理寸法を示すのではなく、プロセスノードと呼ばれるチップ製造技術の世代を指すものである。先進的なプロセスノードは一般に、より高いトランジスタ密度と性能の向上を実現する[…] 「AI需要の高まりの中で、マーベルの初期のチップ製造への賭けが実を結ぶ」という記事は、最初にSiliconANGLEに掲載された。

経緯と関連報道

NVIDIAが欧州の小売業界の変革を推進:オープンモデルと物理インテリジェンスをeコマース、倉庫管理、バーチャル試着に実装

欧州の小売企業は、NVIDIAが加速するオープンな大規模モデルと物理AI技術を活用し、デジタル商品の発見、スマート倉庫シミュレーション、バーチャル試着、研究開発の加速といった場面で大規模な導入を実現しています。Shopify、Zooplus、L’Oréal、Otto Groupなどの企業は、NemotronシリーズのモデルやOmniverseによるデジタルツイン、ALCHEMIによる分子シミュレーションなどのツールを通じて、推論コストの大幅な削減、検索精度の向上、研究開発期間の短縮を実現しており、さらにコンバージョン率の向上と売上成長の効果も確認しています。

経緯と関連報道