本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

vLLM セマンティックルーターが d3-ultra をリリース:270億パラメータのオープンなマルチモーダル意思決定モデル

vLLMセマンティックルーターは、270億パラメータ規模のオープンウェイトなマルチモーダル意思決定モデルであるd3-ultraをリリースしました。同モデルはテキスト、画像、動画を一度に読み込み、各回答に対する確率を返却し、チームのSR-Textテストで87.2点を獲得しています。この記事「vLLMセマンティックルーター、270億パラメータ規模のオープンマルチモーダル意思決定モデルd3-ultraをリリース」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

TMAを使用するべきタイミングと理由:NVIDIA Hopper GPUにおけるテンソルメモリアクセラレーションのワークロードに基づく特性評価

arXiv:2610.34907v1 発表タイプ:新規 要旨:NVIDIA Hopperで導入されたテンソルメモリアクセラレータ(TMA)は、実運用のGPUカーネルにおいて広く用いられているにもかかわらず、その使用状況は極めて選択的である。CUTLASS、FlashAttention-3、FlashInferなどの専門的なカーネル開発者たちは、カーネル内の一部のテンソルオペランドに対してTMAを適用する一方で、他のオペランドについてはcp.asyncや直接グローバルロード、あるいは分散共有メモリ(DSM)に回帰している。ベンダーのドキュメントではAPIが説明され、最近のマイクロベンチマークによる研究ではTMAのスループットが単独で評価されているが、実際の実務者が直面する問いにはいずれも答えられていない。すなわち、カーネル内で特定のメモリオペランドが存在する場合、それをTMAで処理すべきなのか、また、もしTMAを使うならクラスタマルチキャストを併用すべきか否かという問題である。本研究では、H100を対象としたワークロードに基づく特性評価を通じて、このギャップに取り組む。我々はTMAの利用状況を体系的に整理し、多

経緯と関連報道

清華大学と香港中文大学が共同でAKVをオープンソース化:LLMエージェント向けのKVキャッシュエンジニアリングサービスシステム

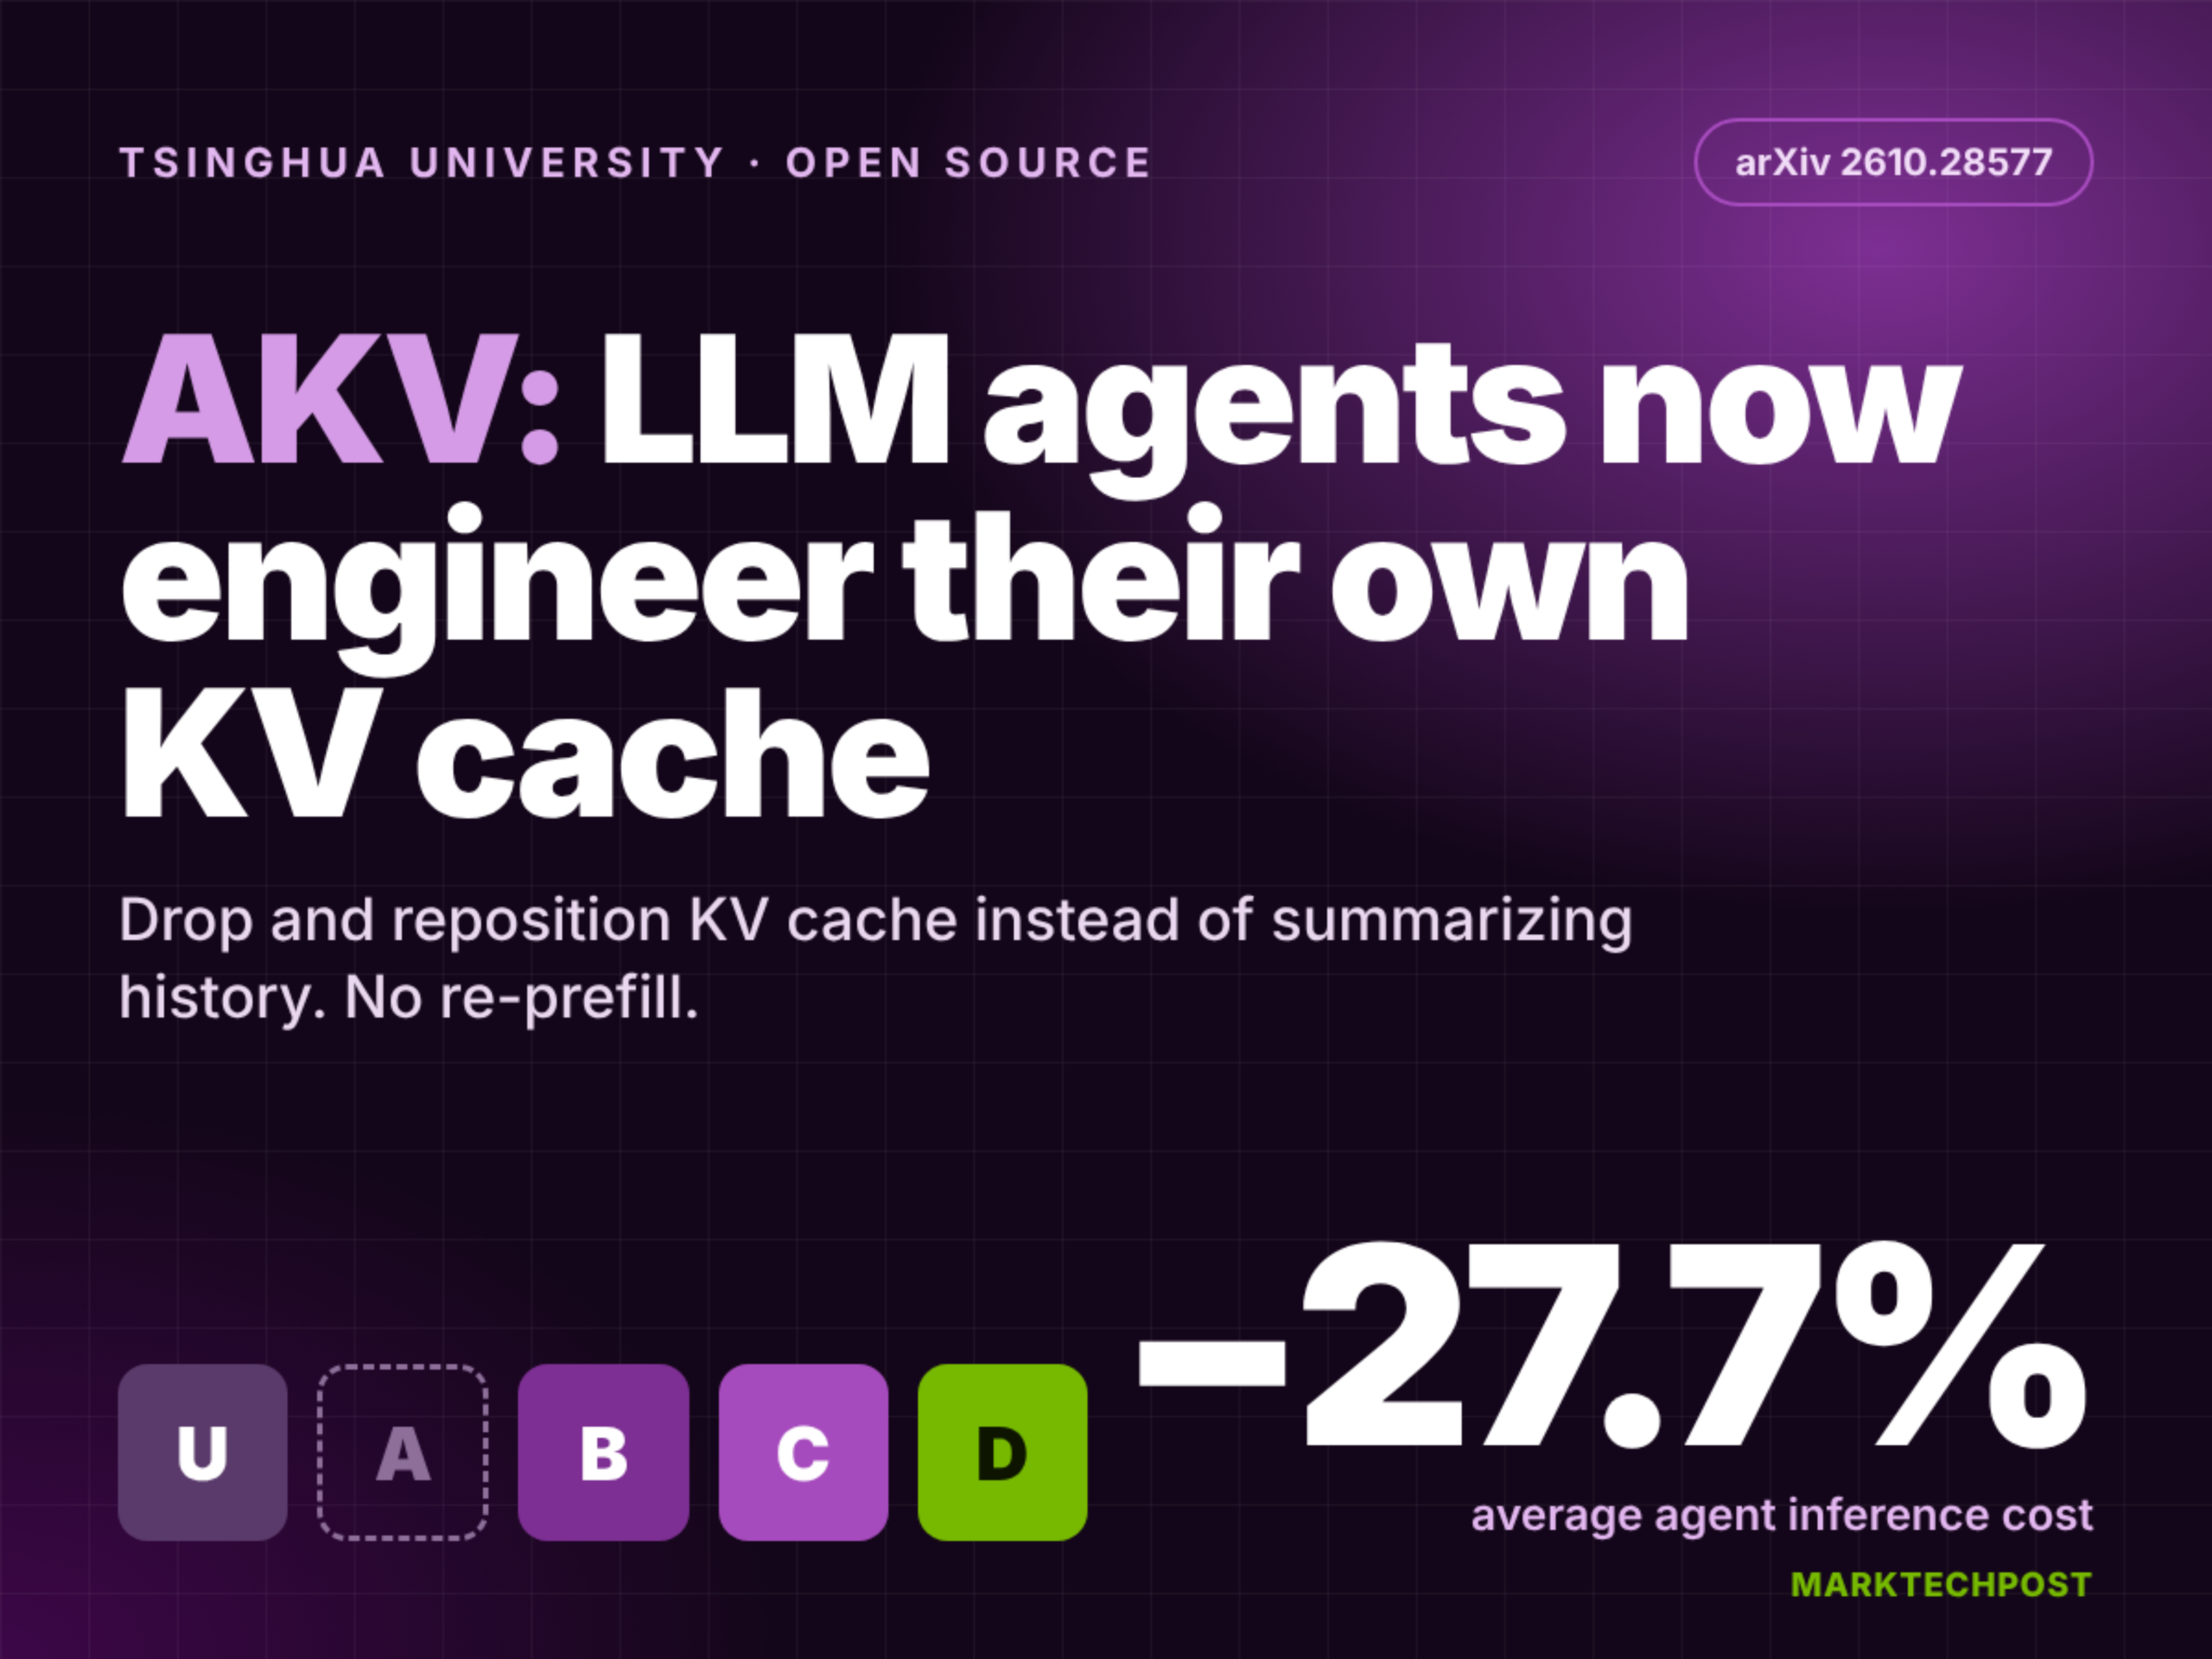
清華大学と香港中文大学の研究者らは、2026年10月26日、SGLangを基盤とし、大規模言語モデル(LLM)エージェント向けに設計されたKVキャッシュ用のエンジニアリングサーバーであるAKVをオープンソース化しました。このシステムは、従来のテキスト履歴の要約ではなく、エージェントが自らKVキャッシュを積極的に破棄・再配置することで、4つのエージェントベンチマークにおいて推論コストを平均27.7%削減し、タスクの平均スコアを1.7ポイント向上させました。コードはApache-2.0ライセンスのもとで公開されており、現在はQwen、GPT-OSS-120B、MiniMax-M2.7などのモデルをサポートしています。

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

注目する理由:この成果は、LLMエージェントによる効率的な推論の新たなパラダイムを示しています。テキストの切り捨てや要約に依存する「コンテキストエンジニアリング」とは異なり、AKVはKVキャッシュ状態を直接操作することで、重複したプリフィルを回避し、長距離間の相互作用におけるKV負荷を大幅に軽減します。実測では、高並行負荷下でP95遅延が229.9秒から30.6秒へと短縮され、明確な工学的価値と再現性を備えています。情報源はMarkTechPostが公開した権威ある技術レポートであり、公開日時(2026-10-26T07:56:45Z)は現在時刻と一致しており、最新の公表進展です。


経緯と関連報道

i14がLaplace 3B線形注意力モデルを発表:AWS Trainium2とネイティブPyTorchを基に、固定状態メモリでの推論を実現

i14は、30.28億パラメータを備えるLaplace 3Bモデルを発表しました。このモデルでは、Softmaxアテンションの代わりにゲート制御線形アテンション(GLA)を採用しており、推論時の各シーケンスあたりの再帰状態は常に29.5 MBで、コンテキスト長に依存しません。同モデルは、AWS trn2.48xlarge(Trainium2チップ16基搭載)1台でトレーニングおよびサービス検証を実施し、トレーニングスループットは12万トークン/秒、サービススループットは11,544出力トークン/秒(1,280同時実行シーケンス)に達しました。すべての性能データは、i14とAWS GenAIICチームによる社内実測結果です。

経緯と関連報道