
NVIDIA DGX SparkにおけるMoE推論を強化する3つの方法
トークンの生成をより高速化するには、まず推論性能を制限している要因を特定することから始まります。NVIDIA上でInclusion AIが実施したLing-3.0-flashのバッチサイズ1による評価では…
出典・テーマ・日時から、気になるニュースを見つけられます。
トークンの生成をより高速化するには、まず推論性能を制限している要因を特定することから始まります。NVIDIA上でInclusion AIが実施したLing-3.0-flashのバッチサイズ1による評価では…
K3.1 Proのリリース後、多くのユーザーからクォータの消費が速すぎるというフィードバックを受け、月之暗面は緊急に公告を出し、「問題は私たち側にあり、本来はもっと早く修正すべきでした」と述べました。補償クォータを提供するとともに、月之暗面は「不要なサブエージェントの呼び出しや出力長さを削減する」方針も示しました。モデルの公開わずか2日前には、Anthropicが『Building agents: When to fold subagents into your main agent loop』というタイトルの記事を発表し、その内容はまさにサブエージェントに関するものでした。Anthropicの結論は、複数の企業が展開するClaudeを比較した結果、スキルを備えたエージェントの方が、「一群の…」よりもむしろ品質が優れていることを明らかにした、というものでした。
著者:Evin 編集:劉致呈 審査:徐徐 発行:インターネット江湖 このところ、MetaのAIエージェント「Muse」が話題になっています。 どのくらい話題になっているのかというと、米国でのダウンロード数は1,000万件を超え、……
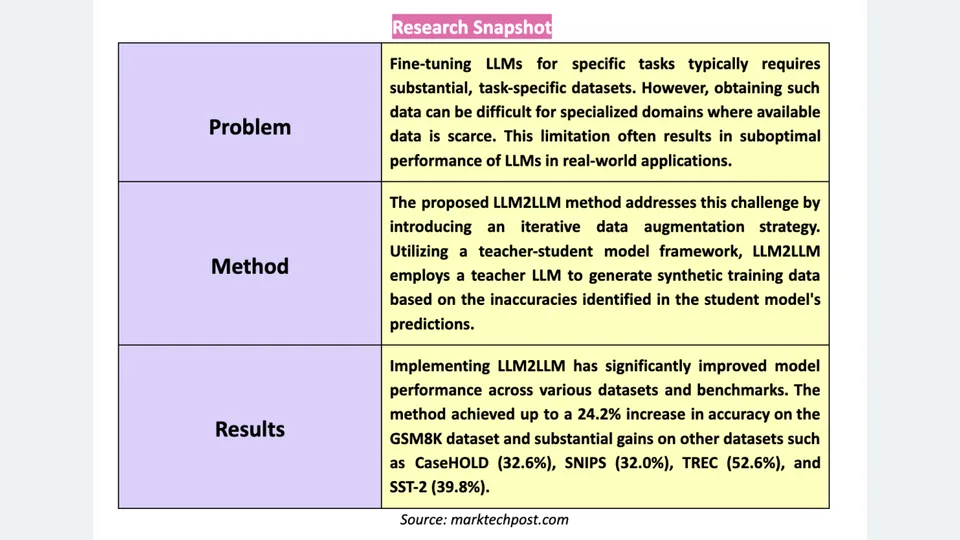
Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。
1. 働き手にさらに適したGPT-6.1 Terraがリリースされ、API料金が半額になり、パソコン操作もより速くなりました 10月26日、OpenAIはGPT-6.1 Terraを発表し、視覚理解、パソコン操作、事実の正確性、プログラミング能力の向上に重点を置きました、....
旧ランキングのスコアは満点に迫るも、新ランキングの実戦評価では軒並み不合格。大規模モデルの評価自体がビジネス化するなか、企業の選定基準はランキングを見る時代から、コスト計算へと移りつつある。
従来の「競馬+短期間の評価」方式では、もはや持続不可能となっている。
闫德利 Tencent社のシニアエキスパート LLMは確率モデルであり、因果関係を理解していない。大規模言語モデル(LLM)は言語を理解しているわけではなく、あくまで次のトークンを予測するだけである。それは単調な「言葉の連想ゲーム」を行う機械にすぎず、一歩進むたびにその都度計算を行い、後戻りはしない。LLMは本質的に確率モデルであり、統計的な共起構造から「何がしばしば何と一緒に現れるか」を学習し、出力されるのは「通常そうである」という結果に過ぎない。なぜそうなるのかという「理由」は理解していない……
AIランキングの首位は入れ替わりますが、ユーザーが毎日利用する製品は必ずしも変わりません。大規模モデルにおける次の競争は、単にどのモデルがより強いかというだけでなく、一度の利用を習慣へと変えることにあるのです。
MiniMaxは2026年10月19日、低価格の大規模モデルM3.1Flashを発表し、総合評価スコアは42点、コストは前世代比で70%削減されたと公表したが、直後に「出題内容の丸暗記」疑惑に直面した――AA公開の旧問題では満点に近い得点を獲得しつつ、問題文を改変しても依然として元の解答を出力するという事例が指摘された。また、猫老板やBinkgらの評価者からは、新旧問題に対する性能の乖離、トークン消費の異常、知識テストにおける幻覚率が92.8%に達するといった問題点が指摘されている。10月23日、MiniMaxはモデルの重み付けをオープンソース化し、独立した再検証を可能としたが、問題認識メカニズムや中国語・英語間での応答差異の原因については依然として明確になっていない。
注目する理由:同報道は、複数の実測(Binkgによる改題実験、著者による再現、AAとPlotly-Milaによる二重評価比較)、検証可能なデータ(トークン数、価格、正答率/幻覚率)およびモデル挙動の矛盾点(英語では誤り・中国語では正しい、古い問題では安定・新しい問題では崩れる)に基づき、現在の大規模モデル評価における信頼性危機の核心的な症候を体系的に示している。すなわち、高得点が必ずしも強力な汎化能力を意味するわけではなく、低価格という優位性と能力の真偽との間に緊張関係が生じている。情報源は钛媒体が許諾して公開した詳細な調査で、原始的なテスト手順、スクリーンショットによる裏付け、タイムスタンプを含み、時事性と細部の密度の両面で高い水準を備えている。
著者|シンシア 編集|鄭玄 2026年のAI3D分野は、まさに微妙な転換点に立っている。一次市場の熱気は依然として高まり続けており、新しいモデルやスタートアップが次々と登場している。単一画像から3Dを生成する手法による正面レンダリングの品質は、ほぼ本物と見紛うほどにまで達している。しかし、華やかなデモの外殻を剥がしてみると、生成結果のほとんどは依然として「回転台での展示」に留まっている。洗練されたキャラクターや機械モデルが照明のもとでゆっくりと回転し、鱗片や衣褶、金属の刻み目まで生き生きと表現される――だが、こうした細部がゲームエンジンへの組み込みや産業シミュレーション、さらには3Dプリントによる実際の製造プロセスに移行すると、たちまち本来の問題が露呈する。構造の破損、背面の崩れ、細部のくっつき、メッシュの編集不可といった課題が一気に噴出しており、膨大な手作業による修正コストが、AIがもたらした効率向上の恩恵をむしろ食い尽くしてしまっている。正面ビューの忠実度だけでは3Dの品質を担保できない――これが新たな業界の共通認識となっている。AI3Dの競争は、「生成できるか」という前半戦から、「実際に活用できるか」という後半戦へと移行しつつある。まさにこの局面において、トッププレイヤーのHi3Dが二枚の布石を打った。生産現場での検証を経たHi3D V1.0基盤を正式にオープンソース化するとともに、クリエイター中心のHi3D Agentを発表。一方では産業の基盤とつながり、もう一方ではリアルな創作ワークフローの全工程に深く根ざすという戦略だ。これに先立ち、設立からまだ3年にも満たない同社は、着実な成果をすでに示していた。半年間で2回のラウンドを連続して完遂し、総額は約5,000万ドルに達した。紅杉中国、IDGキャピタル、美団龍珠など一流投資家が相次いで参画。傘下のHi3Dプラットフォームは120以上の国と地域、200万人超のクリエイターをカバーし、拓竹科技やxToolといった主要デバイスメーカーとも深い統合を進めている。希薄幾何学技術における学術的ブレイクスルーから、プロダクションレベルのモデルのオープンソース化、さらにAgent創作システムによる全工程のフルリンクまで、Hi3Dは3D生成の後半戦への切符を手にしたのだ。 01 3D生成:過大評価されるデモと、過小評価される生産とのギャップ 単一画像から3Dを生成する手法の根本的なロジックには、視点の偏りが内在している。ULIPやUni3Dなどの指標が繰り返し刷新されるなかで、正面重視・全体軽視、外観重視・内部ロジック軽視という傾向が、ここ数年の業界の共通した姿となっていた。しかし、3Dアセットの本質は、回転可能で編集可能、加工可能な立体オブジェクトである。一枚のキャラクター画像の中に、垂
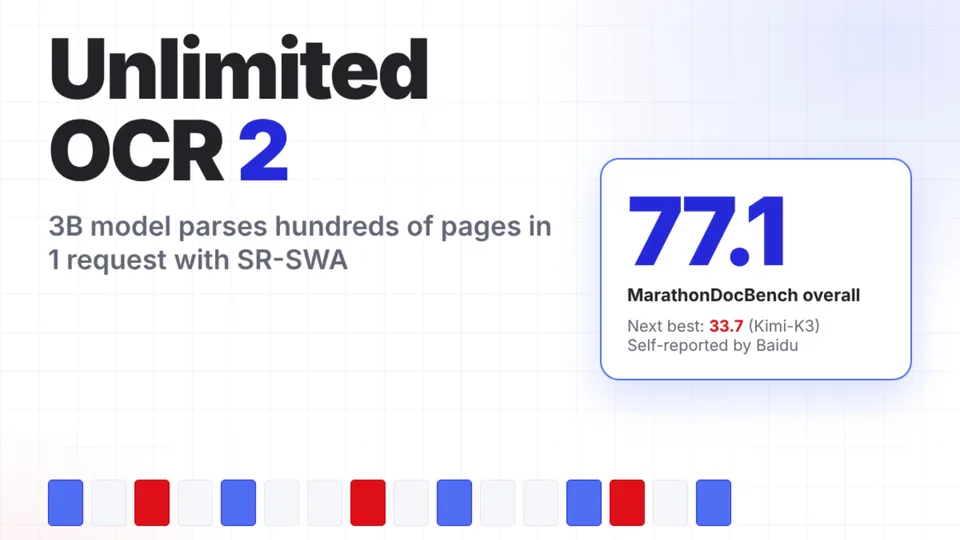
Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。
OpenAIがまた、大規模モデルのコストパフォーマンスを大きく引き上げました。#愛範兒の公式WeChatアカウント「愛範兒」(WeChat ID:ifanr)をぜひフォローしてください。さらに詳しいコンテンツをいち早くお届けします。
arXiv:2610.33015v1 発表タイプ:新規 要旨:長期記憶は、大規模言語モデル(LLM)エージェントが個別化されかつ時間的に一貫した対話を維持することを可能にするが、記憶の取り込み・抽出・整理のためにLLMによる推論を繰り返すと、大きなコストと遅延が生じる。本研究では、顕著性に基づく取り込みと述語中心の情報抽出を組み合わせた軽量な記憶フレームワークSLICE-Memを提案する。コンパクトな分類器が保持すべきユーザの発話ターンを識別し、意味依存関係に基づく抽出器が取り込まれたターンを簡潔な記憶エントリに変換する。このオンライン処理パイプラインは生成型LLMへの呼び出しを一切必要とせず、エントリ間の照合はオフラインの統合段階に委ねられる。我々はMemoraおよびLongMemEval-Sの週次サブセットに対して、8B aを用いてSLICE-Memを評価する。
arXiv:2610.33017v1 発表タイプ:新規 要旨:英語主体のコーパスで学習された多言語トークナイザーは、しばしばインド系言語を過剰に分割し、その結果、トークン列が長くなり、各文字体系間でのトークナイズ化の不均衡が拡大する。本研究では、Unicode正規化による前処理と明示的なインド系結合文字処理、文字体系意識に基づくルーティング、さらに小規模なTransformer言語モデルと共同で学習されるバイト単位の境界予測を組み合わせた、インド系言語に特化した適応型トークナイゼーション拡張であるAdaptTok-Indicを提案する。ベンガル語およびヒンディー語において評価を行い、さらにグジャラート語、タミル語、テルグ語についても追加評価を実施した結果、AdaptTok-Indicは、インド系言語向けのベースラインであるSentencePiece BPEおよび独立して実装されたMAGNETスタイルのベースラインよりも低いトークン肥沃度を達成した。5つの記録済みの
arXiv:2610.32429v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)エージェントは、サブエージェントが実行中にメインエージェントが作業を継続し、その結果が到着する前にタスク状態が変化することもあり、ますます非同期的にタスクを実行するようになっています。メインエージェントは、禁止された変更を避ける一方で、どの処理を更新または保持し、どのチェックを再実行すべきかを判断しなければなりません。タスクの最終的な成功だけでは、これらの結果が正しく処理されたかどうかを示すものではなく、自然な非同期的な到着パターンは再現が困難です。私たちは、LLMエージェントにおける非同期タスク実行のベンチマークであるAsync-RBenchを提案します。このベンチマークには、8つのシナリオを網羅する200の実行可能なタスクが含まれています。シナリオコントローラーは、事前に定義されたタスク状態条件に基づいて結果の配信を制御し、イベント応答契約(ERC)は各応答が何を意味するかを明示します
arXiv:2610.33012v1 発表タイプ:新規 要旨:ツール利用を備えた大規模言語モデル(LLM)エージェントは、同一の状態から独立した実行を行った際、異なるツールを呼び出したり、矛盾する出力を生成したり、互いに異なる戦略を採用したりと、一貫性のない挙動を示します。この変動性は時間の経過とともに累積し、デプロイメントの信頼性を損ないます。既存の評価指標は主に完了ベースのスコアによってタスクの正しさを測定しており、実行間におけるエージェントの振る舞いの一致性を捉えられていません。一方で、エージェントの振る舞いは、確率分布を用いたトークンレベルでの分析や、意味クラスタリングによる単一応答レベルでの分析が行われていますが、いずれも軌跡上の将来のターンにわたって不一致がどのように伝播していくかを捉えることはできません。そこで私たちは、Recursive Semantic Divergence(RSD)という手法を提案します。これは未使用の…
arXiv:2610.33007v1 発表タイプ:新規 要旨:統合された地上系および非地上系(TN/NTN)6Gネットワークにおける自然言語によるサービスインテントは、不完全であったり曖昧だったり、一貫性を欠いていたりするため、信頼性の高いネットワーク向けオーケストレーションを実現するには、制約のないLLMによる生成が困難です。本論文では、文法に基づく制約付き意味解析と知識グラフ(KG)駆動型の明確化ループを組み合わせた、知識主導型LLMフレームワークを提案し、代表的な4つのサービスクラスにわたって検証済みでオーケストレーションに適したサービスプロファイルを生成します。200サンプルからなるインテントデータセットにおいて、このフレームワークは89%の分類精度と95%のポリシー妥当性を達成し、リクエストあたり平均0.66回の明確化ターンを実現しました。純粋なLLMベースラインと比較すると、提案するフレームワークはポリシーの妥当性を向上させ、共…
arXiv:2610.33039v1 発表タイプ:新規 要旨:私たちは、ローカルなエージェント型ワークロードにおいて、使用するメモリ1GBあたりの速度と知能を最適化したハイブリッドMamba-Transformer視覚言語モデルであるNemotron 3.5 Bolt 74B-A9B 24GBを紹介します。Nemotron 3.5 Super VL 120B-A12Bモデルファミリーを基に構築されたNemotron 3.5 Bolt 74B-A9B 24GBは、メモリ制約下での展開向けに、Star Elastic圧縮と2ビット量子化意識型蒸留を組み合わせています。本モデルは推論、エージェントによるツール利用、およびウェブや端末との対話に最適化されています。また、当社は本モデルと同時に公開するLiLiCorrスペキュラティブドラフト生成器も訓練し、目標とする推論速度の達成を目指しました。その結果得られたモデルは、一般的なエージェント型タスクに関する多数のベンチマークにおいて、同程度のメモリフットプリントと速度を持つ最先端モデルよりも高い精度を実現しています。

arXiv:2610.33014v1 発表タイプ:新規 要旨:交渉支援システムは、相手の反応を正確に予測しなくても良好な取引を成立させることができる。そこで、社会的世界モデルに対する評価がその予測を直接検証しているのかという疑問を提起する。1999年から2026年にかけて発表された113件の研究を調査したところ、9件の主要な評価では、システムまたは実験者が選択した行動に対する実際の人の反応が測定されていた。そのうち、明示的な反応予測と実際の反応を比較しているのはわずか2件であり、しかもそれらの予測手法は行動選択時に利用可能な情報を用いており、評価対象の反応は適合過程から除外されていた上、介入手法もランダム化されていた。さらに、言語モデルに関する25件の研究について全文を個別に確認した結果、これらの条件を満たす実験は見当たらなかった。他の評価は、現状推論やタスク成功、あるいは予測機能の評価を行っているにすぎない。