
跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

Anthropic开源OS级沙箱sandbox-runtime:为AI代理提供无容器的文件与网络隔离

Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。
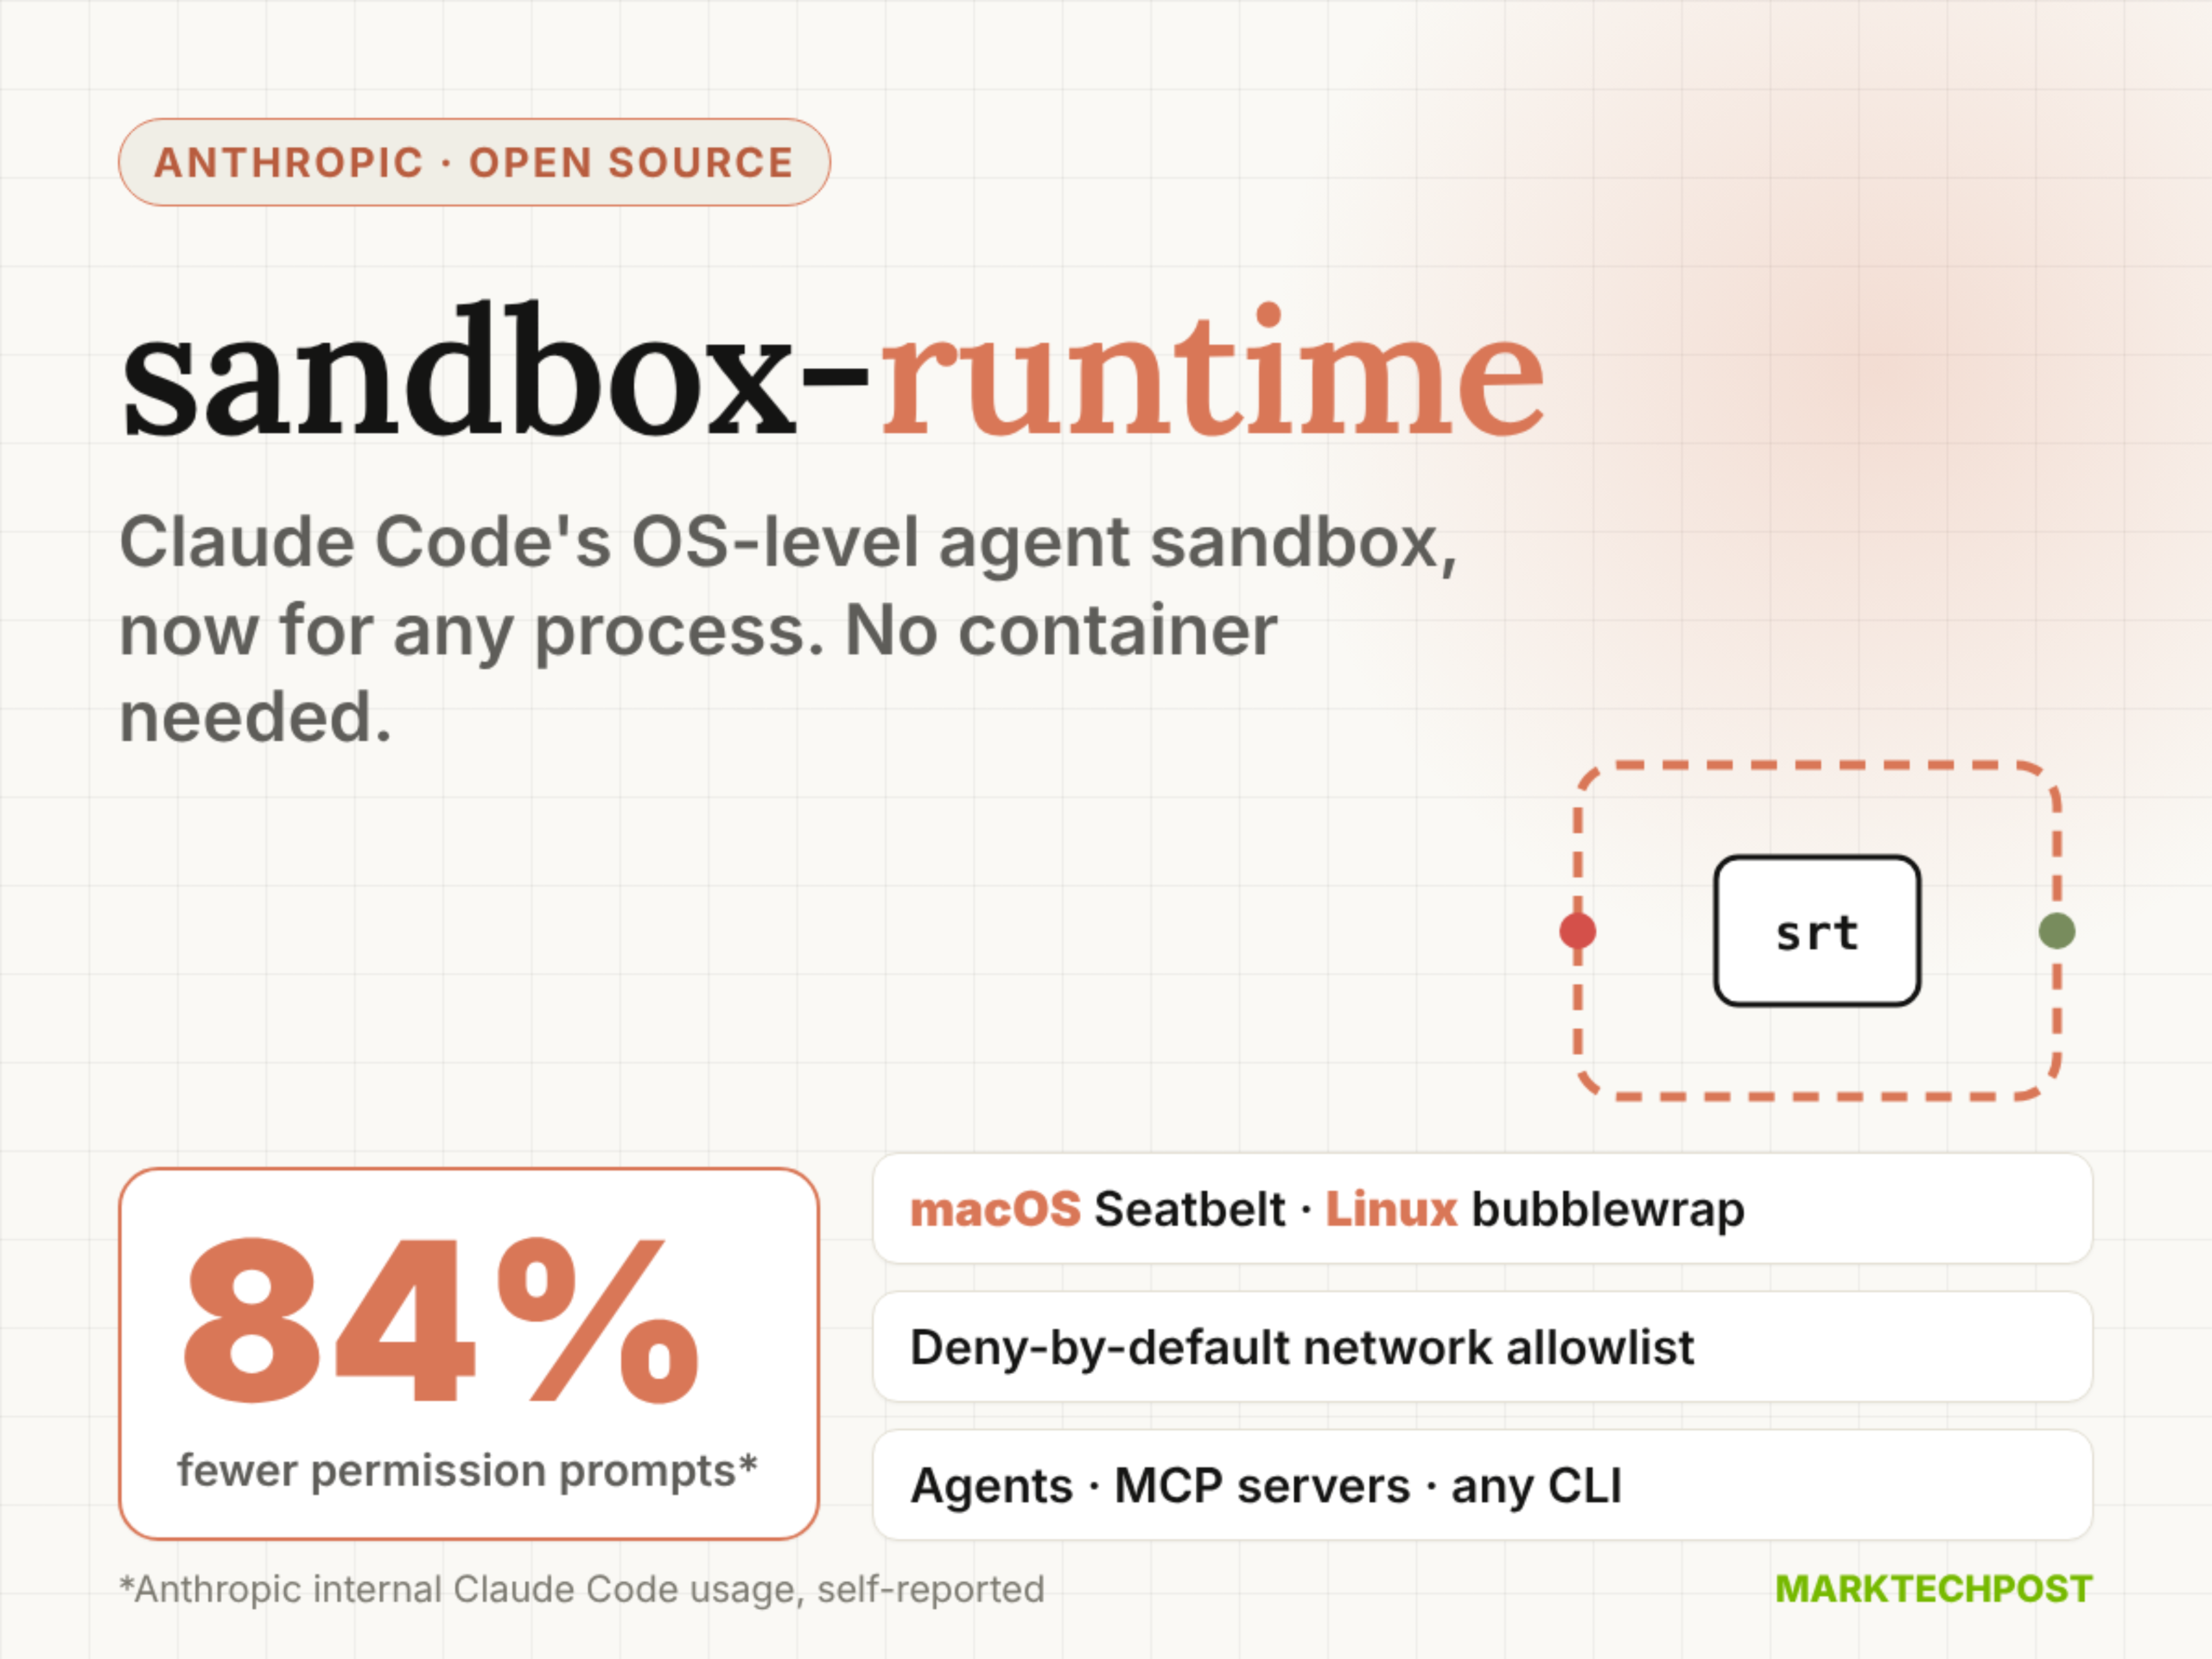
Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。
事件进展与其他报道

Letta平台发布有状态工程协作者构建教程:支持核心记忆、共享状态与可移植工作流

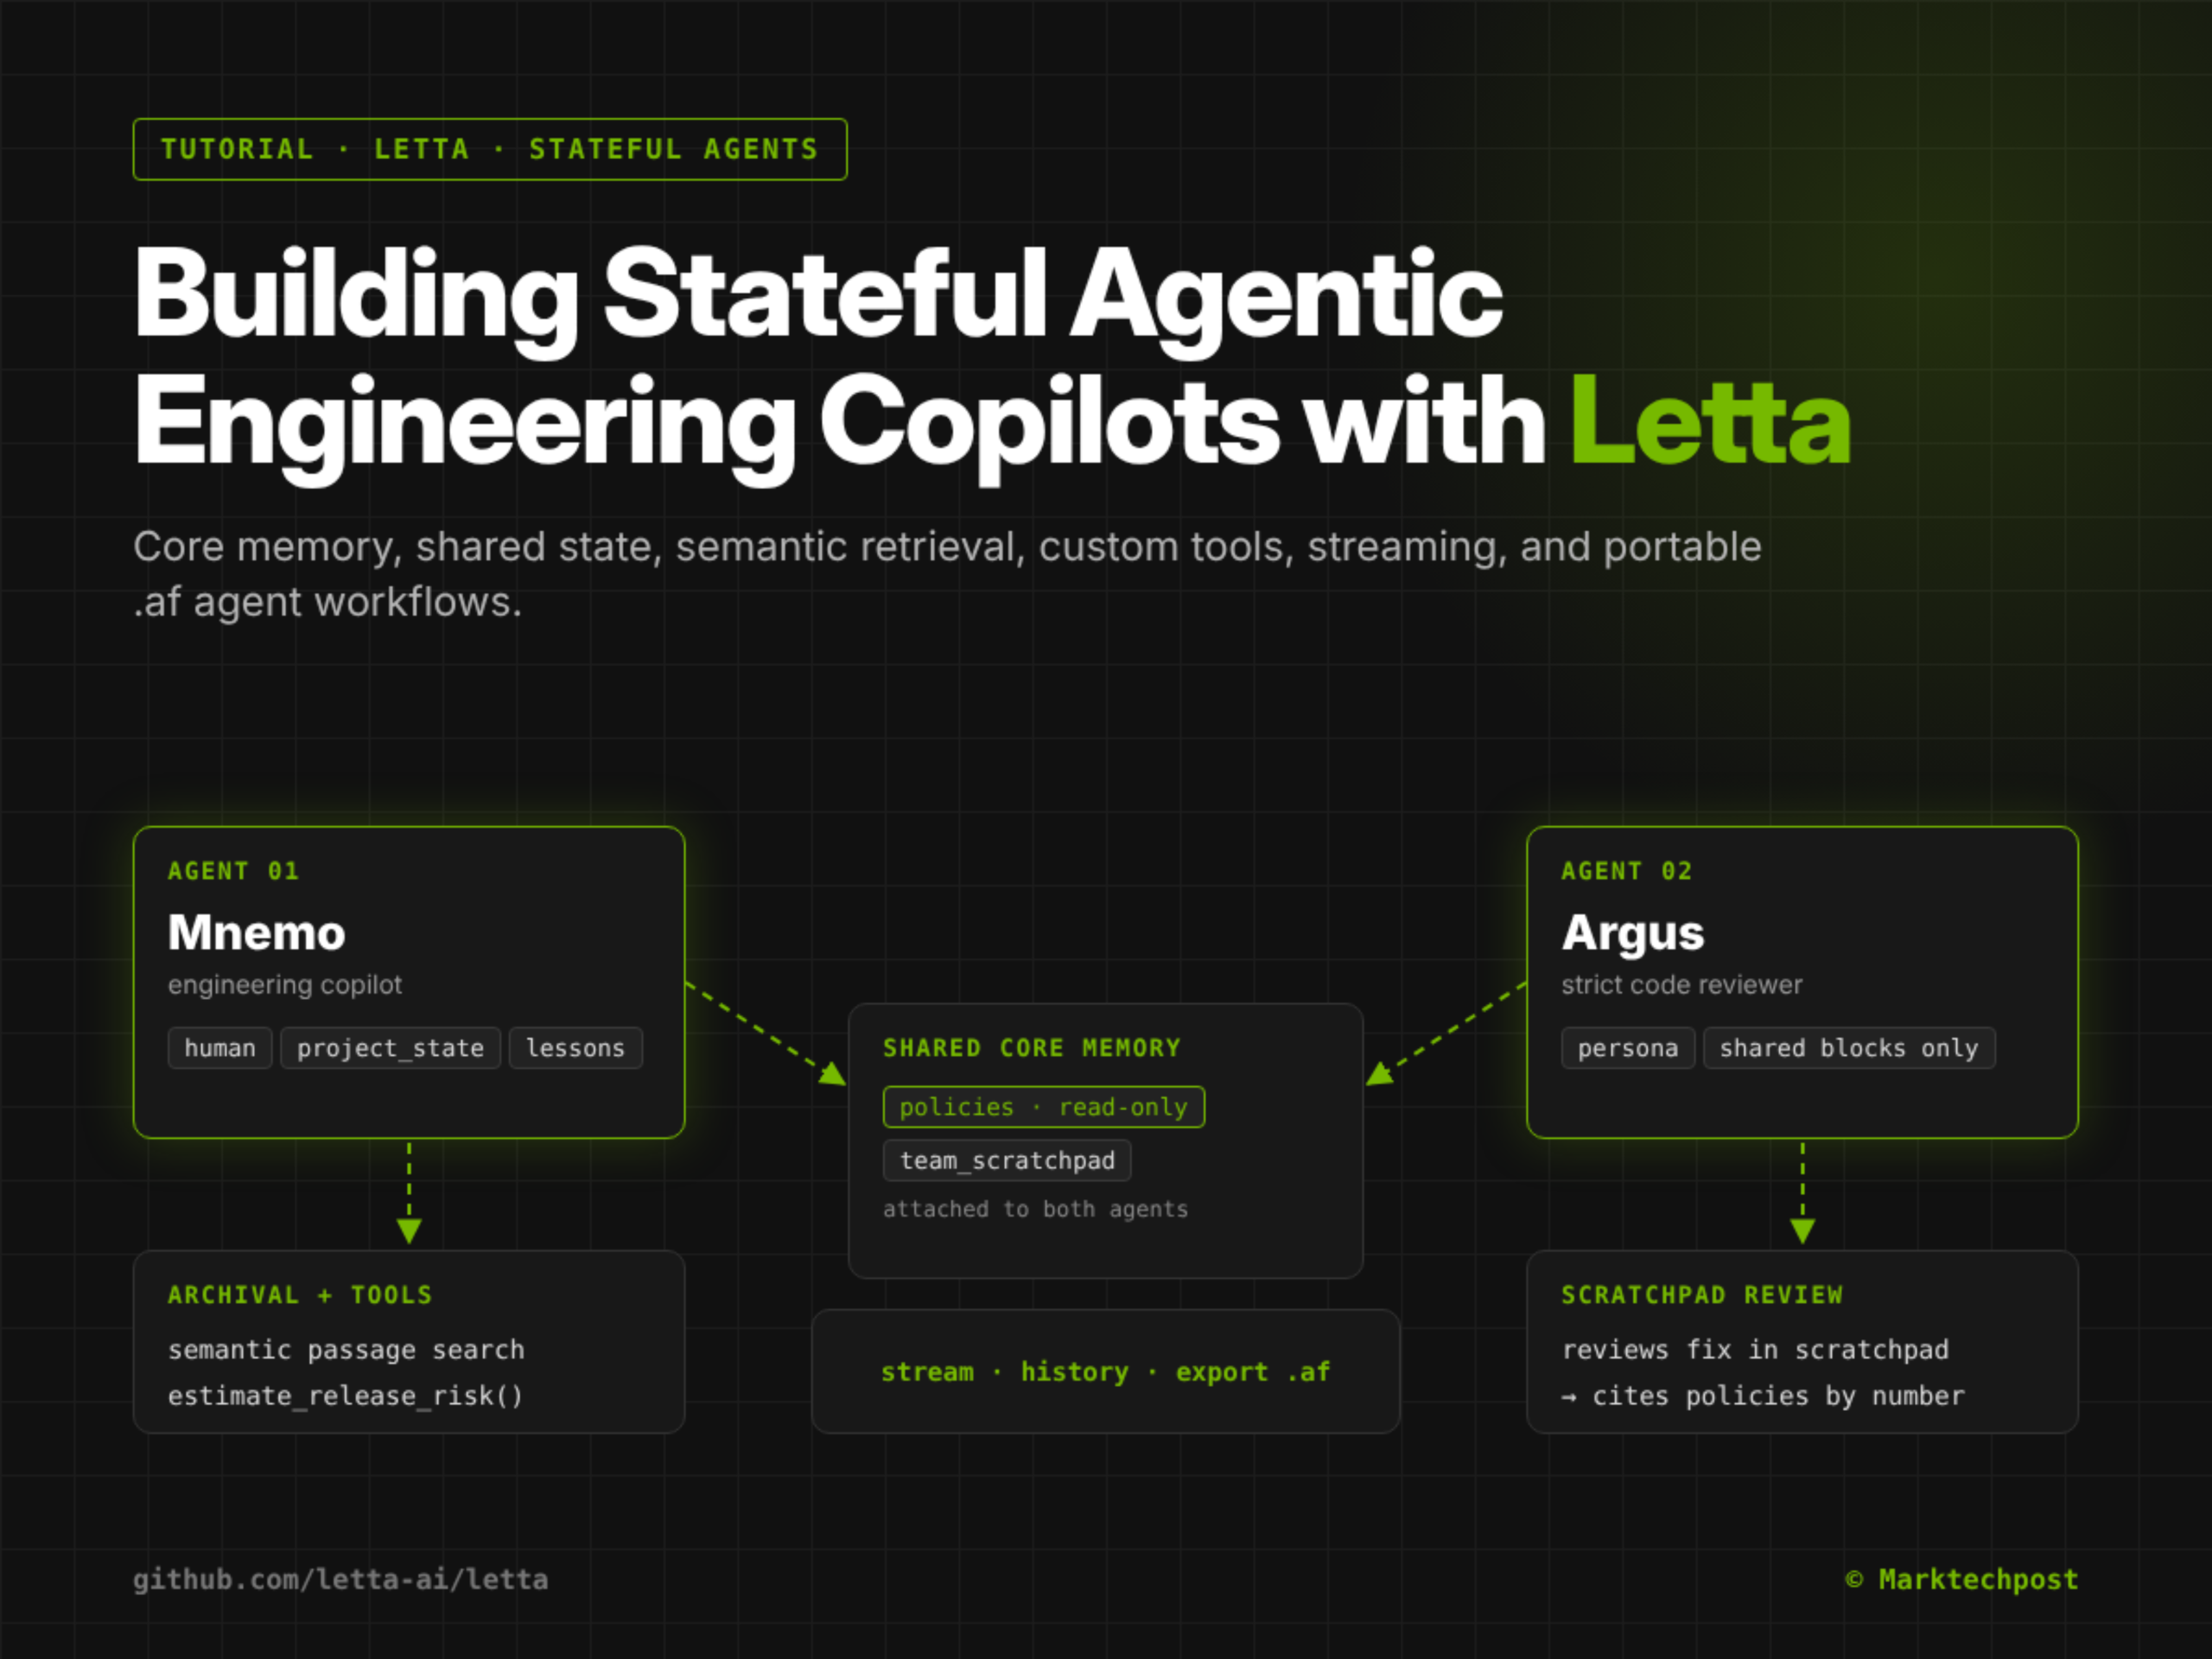
MarkTechPost于2026年10月24日发布教程,介绍如何基于Letta框架构建具备持久化状态的工程协作者(agentic copilot),涵盖可检查的核心记忆、多代理共享内存、语义检索归档知识、自定义Python工具集成、流式响应及.agent格式(.af)导出等能力;内容为技术实践指南,未提供性能指标、安全审计或生产环境验证。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
事件进展与其他报道

研究揭示奖励模型评分存在显著提示依赖性:成对评估无法检测该偏差

一篇2026年10月24日发布于arXiv的AI研究论文指出,当前主流的成对(pairwise)评估方法会自动抵消同一提示下所有响应共有的评分成分,导致奖励模型中关键的‘提示级偏差’未被检验;作者通过人类评分作为参照,对18个已发布评分器开展审计,发现在HelpSteer2数据集上,6个模型高达34%–64%的评分方差源于提示本身,而人类评分几乎无此现象。

What Pairwise Evaluation Misses: Reward Scores across Prompts

推荐理由:该研究指出了大语言模型对齐流程中一个被长期忽视的基础性缺陷——奖励模型评分高度绑定于提示文本而非响应质量本身;其方法论(人类参照审计、提示替换、方差分解)具可复现性,结论基于实证分析且覆盖多个主流开源评分器,对偏好优化、RLHF和安全评估实践具有直接警示意义。

事件进展与其他报道

研究揭示不同长上下文模型在证据位置敏感性上的系统性差异

一项发表于2026年10月24日arXiv的实证研究(论文编号2610.31135v1)比较了Transformer、状态空间模型(state-space)及混合Mamba架构在长上下文问答任务中的位置偏置现象,发现Transformer模型普遍表现出对起始位置证据的利用优势,而状态空间模型缺乏该特性;两类模型却均偏好结尾位置证据。

Mixing Matters: Evidence Position Bias Across Sequence Mixers in Long-Context Question Answering

推荐理由:该研究基于可控实验设计(固定9个干扰文档、滑动单个黄金文档),首次在统一评估框架下横向对比三类主流序列建模架构的位置敏感性,揭示了模型能力与架构类型、提示工程、任务性质的强耦合关系,对长上下文AI系统的设计与调试具有直接参考价值。

事件进展与其他报道

工具增强型语言模型的提示敏感性研究:工具提升准确率但加剧表述差异影响

一项发表于2026年10月24日arXiv平台的研究(编号2610.31148v1)指出,在工具增强条件下,六种开源语言模型在五类领域、五种问题表述下的对比稳定性未提高;相反,工具虽提升程序可答问题的准确率,却扩大了不同措辞下模型排名变化的敏感性。

Prompt Sensitivity in Tool-Augmented Model Comparisons

推荐理由:该研究采用新设计的匹配协议,解耦工具调用全流程中的关键环节(如调用决策、工具响应、无调用报告等),实证揭示‘准确率提升’不等于‘比较更稳定’,并指出接口设计与指令细节显著调节敏感性程度,对模型评估实践具直接指导价值。

事件进展与其他报道

研究揭示多语言评估中“大模型当裁判”效果高度依赖裁判模型选择

一项发表于2026年10月24日arXiv的多语言实证研究发现,当前主流的提示策略(如思维链、角色设定)在LLM-as-a-Judge场景下不具备跨模型、跨语言的可迁移性;裁判模型的选择影响力远超提示策略本身,且策略效果甚至会在不同裁判模型间发生方向性反转。

Prompting Strategy Effects Depend on the Judge: A Multilingual Study of LLM-as-a-Judge Robustness

推荐理由:该研究首次系统测量了9种提示策略、4个开源裁判模型、27种语言和13个数据集间的交互效应,产出超100万条经人工校验的点对点评分,填补了英语中心化提示研究与固定模板多语言研究之间的关键空白。

事件进展与其他报道

快速学习

工具:快速学习提示,适用于Claude Opus 5.5 高级版:构建一个工件,当你打开一张照片时,它会迅速(几秒钟内)使用画布元素和模拟画笔绘制出该照片的版本。另请参阅我之前用Claude Fable结合P5.js模拟水彩插画的实验。快速学习采用Sobel边缘检测,除Google Fonts外不依赖任何外部库。标签:工具

事件进展与其他报道

Smartsheet推出Model Context Protocol(MCP)服务器,支持AI代理在AWS上直连实时项目数据

Smartsheet正式发布通用版Model Context Protocol(MCP)服务器,通过标准化协议使AI代理可读写Smartsheet中的项目表、行、列、自动化等结构化数据;该服务已在AWS生态落地,支持Amazon Quick(面向业务用户)与Kiro(面向开发者)两类客户端接入,实现自然语言驱动的跨工具任务更新、状态同步与上下文感知开发。

事件进展与其他报道

ALTK-Evolve:无需模型权重更新,仅靠学习型记忆在τ²-bench客服基准测试中登顶

IBM研究院提出ALTK-Evolve方法,通过GPT-4.1自动从自身任务轨迹中提炼结构化行为指南(如身份认证、退款确认等),以纯提示工程方式注入ReAct代理系统,在不更新模型权重、不依赖人工标注的前提下,显著提升客服任务的准确率与可靠性;其零售分支以67.5% Pass⁴成绩位列τ²-bench 2026年10月12日榜单第一,超越所有前沿模型及微调系统。

事件进展与其他报道

llm-echo 0.5

发布:llm-echo 0.5 我正在筹备一个新的LLM版本,而在测试Pull Request时,我又重新审视了llm-echo调试插件。这个插件提供了一个“模型”,它完全不涉及任何LLM——只是原样回显输入的提示内容。新版本现已更新了模拟的token使用统计,将工具调用、系统提示以及推理token都纳入考量。示例用法如下:uvx --with llm-echo llm -m echo 'hi there' -o thinking 1 --usage 输出结果: 首先我考虑提示内容,然后决定该说些什么。{ "prompt": "hi there", "system": "", "attachments": [], "stream": true, "previous": [] } Token使用情况:输入2个,输出24个 标签:llm

事件进展与其他报道

web-edit 0.1a2

发布:web-edit 0.1a2 web-edit(此前)是我用于浏览和编辑文件夹中文件的迷你网页应用。我主要是为了通过 Tailscale 在不同设备上编辑文件而开发的。我还为文本和图像数据添加了“复制到剪贴板”选项。之所以需要这个功能,是因为我当时正用手机在笔记本电脑上运行 pelican 提示(这里是 DeepSeek 4.1 Flash 1017),并且希望有一种简便的方法将生成的日志复制到 Gist 中。标签:项目、pelican-riding-a-bicycle、deepseek

事件进展与其他报道