跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

InferSlice:一种面向电信广域网的、由SLO驱动的LLM推理参考架构

arXiv:2610.32638v1 发布类型:新 摘要:大型语言模型(LLM)推理正日益作为企业和交互式应用的核心服务被部署,但主权、合规、延迟以及资源本地化等方面的要求,可能限制集中式云部署的适用性。电信运营商提供地理分布式的计算与网络基础设施,以应对这些约束。然而,现有的 LLM 服务框架主要面向紧密耦合的数据中心设计,对协调地理分布且异构的资源支持有限。我们提出了 InferSlice,一种面向电信基础设施、以服务等级目标(SLO)为导向的 LLM 推理参考架构,集成了网络切片、GPU 分区、弹性服务与可观测性等功能。


InferSlice: A Reference Architecture for SLO-driven LLM Inference over a Telco Wide-Area Network
事件进展与其他报道

面向开放ISA的超级计算:RISC-V、Arm与x86架构在HPC工作负载上的比较研究

arXiv:2610.32632v1 发布类型:新 摘要:RISC‑V 正在成为高性能计算(HPC)领域的候选架构,但其与成熟的 x86 和 Arm 处理器相比的竞争力仍难以评估,因为现有研究采用的平台、工作负载和方法各不相同,且很少考虑能效。我们的工作基于统一的软件栈和评估方法,对当前主流的 HPC RISC‑V、Arm 和 x86 处理器进行了全面评测。我们详细分析了 Sophgo SG2044,并将其与 NVIDIA Grace CPU 超级芯片以及 Intel Xeon Platinum 8480+ 在四项 HPC 基准测试(STREAM、HPL、HPL‑MxP 和 HPCG)以及四款典型应用(iPIC3D、PLUTO、OpenFOAM 和 llama.cpp)上进行了对比。用于本研究的 HPL‑MxP 版本链接至 OpenBLAS,并以此为基础进行构建和测试……

Toward Open ISA Supercomputing: A Comparative Study of RISC-V, Arm, and x86 Architectures on HPC Workloads
事件进展与其他报道

迁移作为稳态执行原语:一种用于近地轨道虚拟静止状态的运行时环境

arXiv:2610.32720v1 发布类型:新 提要:低地球轨道(LEO)卫星巨型星座为对时延敏感的地球同步应用提供了在轨边缘计算能力,但卫星的运动使视距通信窗口被压缩至仅几分钟。为保持逻辑上的地理邻近性,一种被称为“虚拟静止性”(VS)的范式要求应用程序在星座中不断跨过经过的卫星进行迁移。传统的实时迁移机制仅针对单个发起的重定位或复制操作进行优化,而未能满足轨道运动所必需的连续宿主机间切换需求。我们重新将实时迁移表述为一种稳态执行模型,并提出了一种全新的虚拟静止性运行时范式。我们形式化了连续迁移的可行性……

Migration as a Steady-State Execution Primitive: A Runtime for Virtual Stationarity in Low-Earth Orbit
事件进展与其他报道

DraMaze:一种具备未来感知记忆的多智能体流水线,用于多样化的微剧剧本生成

arXiv:2610.32002v1 发布类型:新 摘要:微剧的迅猛发展使得对高质量剧本创作的需求日益增长。利用大语言模型进行长篇微剧剧本生成,既需要丰富多样的情节推进,又要求具备长远的叙事连贯性。我们的观察发现,随着生成过程的推进,候选续写内容越来越倾向于聚焦于少数几种叙事机制;而传统的检索方式则可能加剧套路的重复使用,并忽视对未来情节至关重要的历史信息。为应对这些挑战,我们提出了DraMaze——一种多智能体流水线,通过基于套路记忆的进化树搜索与变异,探索多样化的因果路径;同时,它还构建了后向叙事依赖树,用于组织、保存并检索历史记忆。

事件进展与其他报道

SpecMem提出实时工具调用记忆管理机制,提升智能体响应速度

arXiv于2026年10月26日发布题为《SPECMEM: Accelerating Agentic Tool Calling via Live Memory Management》的预印本论文(编号2610.31840v1),提出名为SpecMem的新系统,通过跨会话、在线更新的用户级工具调用记忆管理,显著降低工具调用延迟。

新闻源配图 · arXiv cs.CL

推荐理由:该研究针对当前工具调用智能体在部署中因自回归解码导致的高延迟问题,提出可验证写回、LRU淘汰、副作用门控等关键技术,并在多用户多会话真实查询流上验证了其有效性(最高1.74倍实测加速、27%平均接受token提升),属AI系统工程方向的重要进展。

事件进展与其他报道

KVStream:面向大规模LLM推理的KV缓存自适应并行存储管理

arXiv:2610.31827v1 发布类型:新 摘要:针对智能体驱动、编码及文档工作负载的长上下文大语言模型服务,会重复使用那些键值(KV)缓存超出GPU和主机内存容量的前缀,从而导致在推理阶段为获取这些前缀而产生存储I/O,使其成为关键路径。单个节点本地的NVMe设备承担了所有检索任务,而各节点已挂载的并行文件系统或云文件存储几乎不承载任何推理流量。我们将前缀检索视为跨这些层级的聚合带宽调度问题,并提出了KVStream——一种KV缓存引擎,它将某一步骤的读取操作进行批处理,在前向传播之后延迟写入,在每一层级上复制每个数据块,并允许每个层级在空闲时自适应地获取下一个未读取的数据块。我们的性能模型表明,这种路由方式能够实现聚合

KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving
事件进展与其他报道

缪子预条件何时以及如何生效?结构化梯度噪声的作用

arXiv:2610.31728v1 发布类型:新 摘要:Muon 已成为大型语言模型训练中广受欢迎的优化器,但其理论基础仍缺乏深入理解。在本研究中,我们探讨了梯度噪声的几何结构如何影响 Muon 的预条件化优势。我们首先从理论与实验两方面证明,在经典的各向同性噪声假设下,Muon 仅能通过重新缩放学习率而带来加速效果,无法进一步提升性能。这一发现促使我们进一步考察由异构任务频率下的关联记忆中的小批量采样所引起的结构化噪声。我们为两类任务确定了一个精确的平衡阈值,并将分析扩展至多任务场景,揭示了任务覆盖率与梯度可靠性如何共同塑造学习过程。我们的分析表明,Muon 能够缓解……

When and How Does Muon Precondition? The Role of Structured Gradient Noise
事件进展与其他报道

超越热度:面向分层内存的ARM SPE云与LLM工作负载高分辨率内存特性分析

arXiv:2610.32711v1 发布类型:新 摘要:数据分析与大语言模型工作负载对内存的需求正迅速增长,推高了云环境和数据中心的内存成本。多级内存已成为一种颇具前景的解决方案,可在性能与成本之间实现平衡。然而,要有效利用多级内存,必须深入理解工作负载的内存访问行为。本文提出了一种高分辨率的内存特性分析方法,用于评估针对特定工作负载的多级内存使用机会。鉴于基于ARM的处理器在数据中心中的部署日益增多,我们采用ARM最新的统计剖析扩展(SPE)来实现这一方法。通过对CloudSuite和大语言模型应用中的八个内存密集型工作负载进行特性分析,我们识别出了具有区域特异性的访问模式

Beyond Hotness: High-Resolution Memory Characterization of Cloud and LLM Workloads for Tiered Memory with ARM SPE
事件进展与其他报道

测试时记忆进化能否在科学发现中超越测试时训练?

arXiv:2610.32046v1 发布类型:新 摘要:近期的“测试时训练”(TTT)框架使开放权重的大规模语言模型(LLMs)在科学发现任务上超越了由前沿模型驱动的仅推理框架。然而,TTT 在发现过程中引入了额外的在线权重更新计算开销,这使得在扩展至更大规模模型时,计算效率成为一项重要考量。因此,我们致力于探索一种用于科学发现的高效“测试时适应”方法。我们提出了一种即插即用的测试时适应方法——“测试时记忆演化”(TTME),作为 TTT 的替代方案。TTME 通过提炼经验不断更新外部记忆,从而指导后续的发现过程,而无需进行权重更新。

Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
事件进展与其他报道

在 MXFP4 上训练 MoE 大型语言模型:我们如何缩小与 BF16 的差距

arXiv:2610.32229v1 发布类型:新 摘要:在低于8位的算术运算下训练大型语言模型(LLMs)有望显著提升内存带宽和计算吞吐量,然而FP4格式引入的量化误差若不加以处理,将严重扰乱优化过程。我们提出ALTO,这是一种开源的训练方案,用于在MLPerf小型MoE训练基准测试中,以MXFP4微缩尺度格式训练GPT-OSS-20B——一款拥有200亿参数的专家混合模型(MoE)。该方案融合了Abecassis、Felix等人[arXiv:2509.25149]提出的成熟技术(混合1D/2D块量化、随机化哈达玛变换以及随机舍入),并结合了一种基于TetraJet-v2[arXiv:2510.27527]改进的简化权重去振荡机制。在C4验证集上,采用全局批量大小

事件进展与其他报道

EDWARD-NMT:用于神经机器翻译的自适应路由与双重一致性弹性维度

arXiv:2610.32115v1 发布类型:新 摘要:稀疏混合专家(MoE)是一种强大的范式,可用于扩展神经机器翻译(NMT)并应对语言异构性。然而,实际限制阻碍了其在资源受限设备上的部署:整个专家池必须常驻内存,且每个标记的计算预算在训练期间由严格的 top-k 路由机制静态固定。我们提出了 EDWARD-NMT(用于 NMT 的弹性维度与自适应路由及双重一致性),这是一种新颖的 MoE 编码器—解码器架构,旨在实现“一次训练、随处部署”的范式,并在推理时提供一系列可部署的子网络。EDWARD-NMT 集成了三项关键创新:(i) 采用套娃式弹性维度,以灵活降低内存占用;(ii) 一个

事件进展与其他报道

查询记忆程度决定古典阿拉伯诗歌检索效果:BM25与稠密编码器表现随查询抽象度显著分化

一项发表于2026年10月26日arXiv的最新研究(arXiv:2610.31821v1)表明,在古典阿拉伯诗歌检索任务中,用户对诗句的记忆残留程度(如是否记得半行诗)比模型能力更关键地决定了检索性能;BM25在“舌尖效应”类查询中优于所有稠密编码器(含8B参数SOTA模型),但在抽象查询中大幅落后。

新闻源配图 · arXiv cs.CL

推荐理由:该研究通过双语料库、三索引模式与双评估协议的系统性基准测试,首次量化揭示了查询抽象度对不同检索范式(词法vs.稠密)的支配性影响,并经人类标注员与开源权重模型双重验证,结论具有方法论普适性与实证稳健性。

事件进展与其他报道

Phronix:面向智能体的能力中心型学习范式

arXiv:2610.31789v1 发布类型:新 摘要:科学计算日益依赖基于大型语言模型的智能体驱动工具,用于执行诸如插桩、分析和工作流移植等性能优化任务。然而,智能体的效能在很大程度上取决于其周边的支撑框架,而该框架通常依赖于人工编写的技能与精心构建的记忆库。这限制了自主学习能力,迫使智能体反复重新探索解决方案,而非保留并复用先前执行过程中积累的知识。我们提出了 Phronix,一种以能力为中心的学习范式,使智能体驱动的支撑框架能够从自身的执行过程中获取、验证并完善可重用的能力。Phronix 通过预测—验证—修正的循环运行:MCP 工具及其相关技能提出解决方案,工具 ex

Phronix: The Capability-Centric Learning Paradigm for Agents
事件进展与其他报道

量子节奏:具有多个并发提议者的后量子共识

arXiv:2610.32803v1 发布类型:新 摘要:大多数高性能区块链的共识协议都采用法定人数证书,该证书将法定人数内验证者的签名打包在一起。诸如 BLS 之类的签名方案能够将整个法定人数的签名聚合为一个短签名,从而保持这些证书的规模较小。然而,一台大规模量子计算机将打破这类方案,而目前尚无任何后量子方案能够在聚合规模和聚合时间上与之相当。如果不进行聚合,每个证书都需要为法定人数中的每一位成员存储一条大型后量子签名,这使得每位验证者广播证书变得不可行,而这正是现代共识协议通常所要求的。我们提出了 Quantum Cadence,一种支持多个并发提议者的后量子共识协议,其

事件进展与其他报道

挖掘框架:作为新闻框架检测的无监督框架的关联规则挖掘

arXiv:2610.31874v1 发布类型:新 摘要:计算框架分析领域长期以来以监督式分类器为主,这类方法需要大规模的标注语料库和预先定义的框架分类体系,从而限制了其在非英语语言、新型事件以及低资源环境中的应用。本文提出了一种基于关联规则挖掘(ARM)的无监督、无需标注的新闻框架检测框架。其中,每篇文档或每个句子都被视为一个由词汇项构成的“交易”,而高提升度的共现规则则被解读为候选的框架信号(即甘森与莫迪利亚尼所提出的“凝缩符号”),并由记者与研究人员在具体语境中加以验证。主要验证案例为《聚焦加沙:来自美国、英国、法国和德国16家媒体的25,512篇英文报道,涵盖加沙战争的第一年(10月……》

事件进展与其他报道

LangChain发布“公司级智能体框架”五大核心组件

LangChain于2026年10月25日发布博客,系统阐述其在营销、销售与工程团队内部部署AI智能体(GTM Agent、OpenSWE、Content Studio)所沉淀的五大通用架构原则:原生集成工作环境(Slack)、动态身份模型(OBO+固定凭证)、双层记忆机制(全局/用户级)、沙箱化代码执行、高比例调度运行(非手动触发)。所有智能体均基于Managed Deep Agents平台构建。

推荐理由:该资讯源自LangChain官方博客,发布时间(2026-10-25T18:06:32.000Z)早于当前系统时间(2026-10-25T23:01:18.857Z),内容聚焦已落地的内部智能体实践,细节具体(如Slack线程隔离、GitHub账号归属逻辑、Notion/Twitter权限分层等),未含未经验证的预测或外部宣称,符合时效性与事实性要求。

事件进展与其他报道

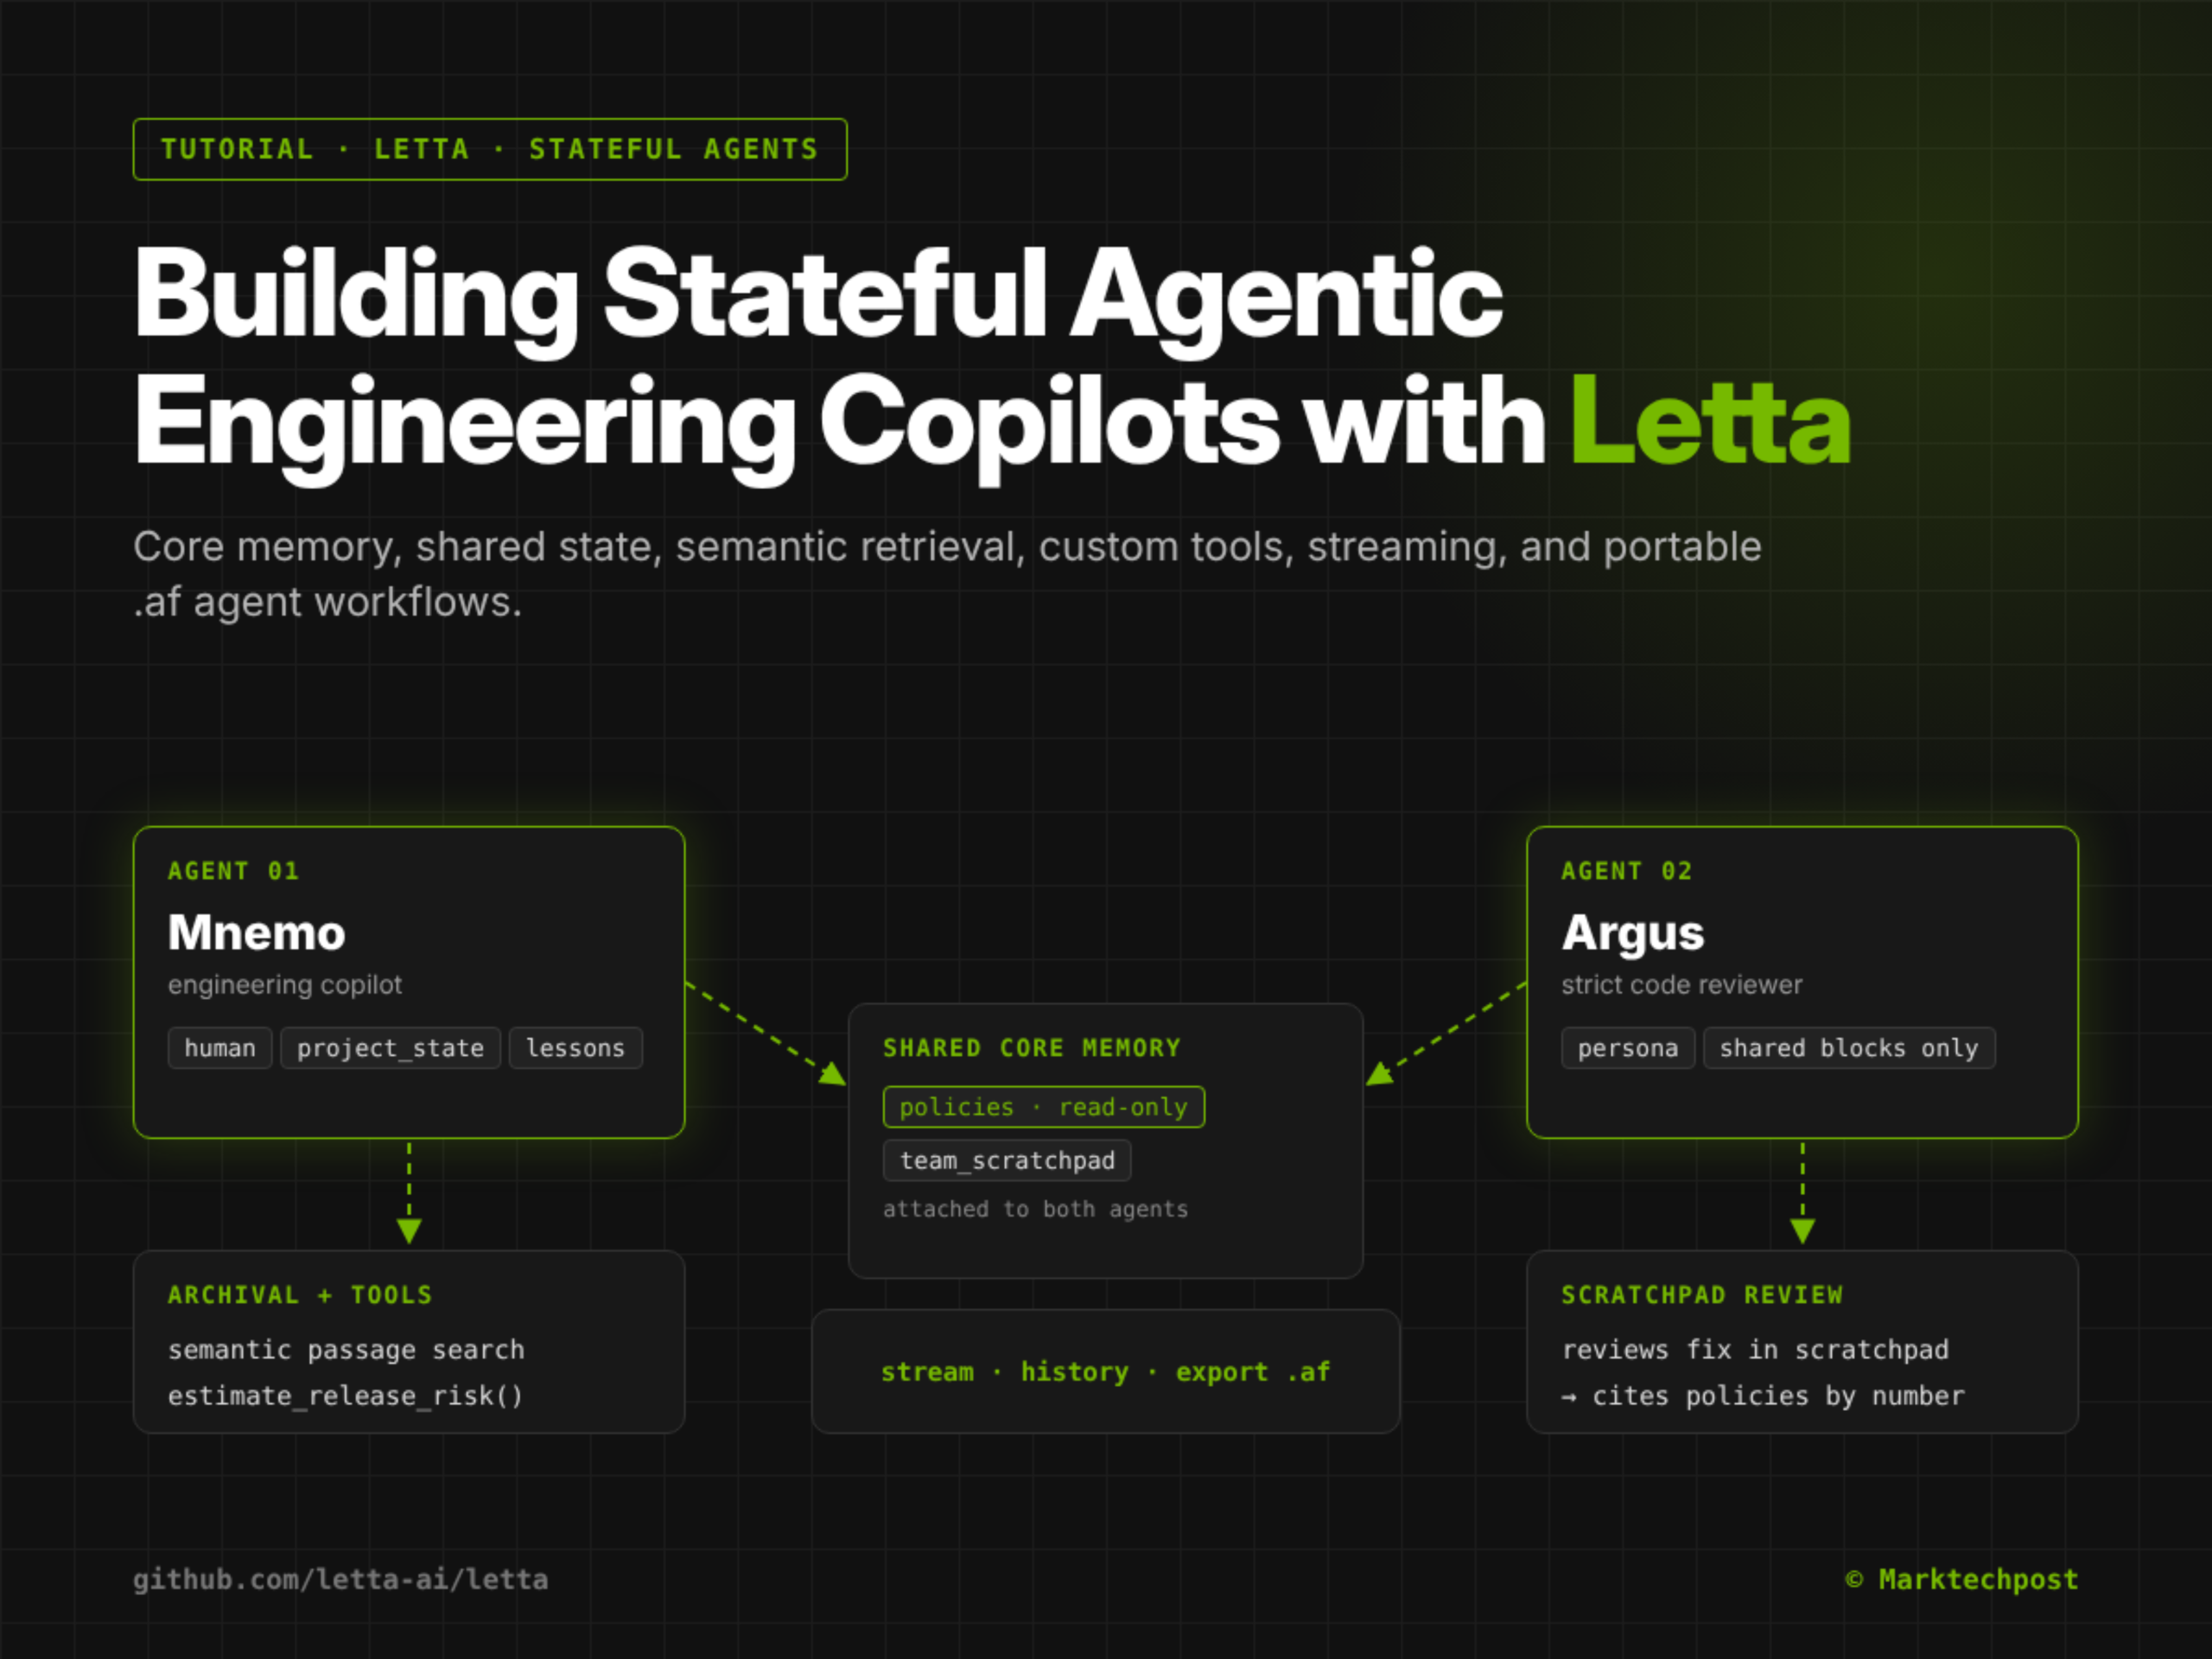
Letta平台发布有状态工程协作者构建教程:支持核心记忆、共享状态与可移植工作流

MarkTechPost于2026年10月24日发布教程,介绍如何基于Letta框架构建具备持久化状态的工程协作者(agentic copilot),涵盖可检查的核心记忆、多代理共享内存、语义检索归档知识、自定义Python工具集成、流式响应及.agent格式(.af)导出等能力;内容为技术实践指南,未提供性能指标、安全审计或生产环境验证。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
事件进展与其他报道

MemPlan:面向部分可观测文本环境的记忆增强型PDDL规划框架

该论文于2026年10月24日在arXiv发布(编号2610.30379v1),提出MemPlan——一种将大语言模型(LLM)作为语言与符号规划之间受限桥梁的记忆条件化PDDL规划框架,适用于部分可观测的交互式文本环境。

MemPlan: Memory-Conditioned PDDL Planning for Partially Observable Text Environments

推荐理由:MemPlan通过正向图记忆与负向记忆机制动态重构PDDL问题,显著提升任务完成率与步数效率,同时大幅降低在线token消耗;其离线微调的语言–符号接口可跨TextWorld任务类型复用,无需任务特化微调,体现了方法的泛化性与实用性。

事件进展与其他报道

研究提出Delta N-gram:面向语言模型原生N元语法表的前向-only持续写入方法

2026年10月24日,arXiv发布论文arXiv:2610.31125v1,提出Delta N-gram——一种不修改预训练N-gram表T⁰、仅通过前向传播写入稀疏增量补丁Δ的新机制,支持高效、可逆的持续记忆更新。

Delta N-gram: Forward-Only Continual Writing into a Language Model's Native N-gram Memory

推荐理由:该工作针对持续学习中模型基础参数扰动大的问题,提出结构轻量(4.1M参数)、计算高效(纯前向)、完全可逆(清空Δ即恢复原始模型)的记忆增强路径,并在Qwen3.8-Flash-Next等模型上验证其更强的文档特异性与抗干扰能力,属前沿可信AI系统研究。

事件进展与其他报道