
华擎 Creator Radeon AI Pro R9700 评测:工作站级推理,AMD 风格
今天,我们来了解一下华擎面向工作站推出的高端Radeon AI推理卡——Creator Radeon AI Pro R9700。这款显卡配备32GB内存,售价1700美元,是为工作站添置本地AI推理能力的高性价比之选。文章《华擎Creator Radeon AI Pro R9700评测:AMD风格的工作站推理》首发于ServeTheHome。
检索标题、摘要与正文,把分散的信息连起来。
今天,我们来了解一下华擎面向工作站推出的高端Radeon AI推理卡——Creator Radeon AI Pro R9700。这款显卡配备32GB内存,售价1700美元,是为工作站添置本地AI推理能力的高性价比之选。文章《华擎Creator Radeon AI Pro R9700评测:AMD风格的工作站推理》首发于ServeTheHome。
Anthropic认为,“闭环”是实现人工智能成功的最佳路径,同时也可能给人类带来“生存性”威胁。
arXiv:2610.32122v1 发布类型:新 提要:我们报告了现代文本嵌入模型中的一种系统性脱节现象:情感信息几乎可以被其嵌入表示完美解码,却几乎完全无法从其度量空间中体现出来。在涵盖2021年至2026年的十一种冻结编码器中,包括2026年发布的模型以及4B参数的大型语言模型嵌入器Qwen3-Embedding-4B,线性探测器在句子极性分类任务上的准确率高达91.3%,而余弦相似度对极性的区分幅度却仅为0.003至0.064。作为该测试集中表现最强的探测器,Qwen3-Embedding-4B的探测准确率达到91.3%,但在检索平均精度(MAP)方面却仅有64.3%。由于检索、聚类、去重以及检索增强生成等任务均基于度量空间而非经过训练的探测器进行,这些系统实际上对相关信息处于“视而不见”的状态。
arXiv:2610.32046v1 发布类型:新 摘要:近期的“测试时训练”(TTT)框架使开放权重的大规模语言模型(LLMs)在科学发现任务上超越了由前沿模型驱动的仅推理框架。然而,TTT 在发现过程中引入了额外的在线权重更新计算开销,这使得在扩展至更大规模模型时,计算效率成为一项重要考量。因此,我们致力于探索一种用于科学发现的高效“测试时适应”方法。我们提出了一种即插即用的测试时适应方法——“测试时记忆演化”(TTME),作为 TTT 的替代方案。TTME 通过提炼经验不断更新外部记忆,从而指导后续的发现过程,而无需进行权重更新。

arXiv:2610.31846v1 发布类型:新 摘要:智能体应当从自身错误中学习,从而使经验带来持续改进。然而,当前的智能体仅能暂时从错误中恢复:上下文中的反思很容易在不同会话间被遗忘,并且会与有限的上下文资源产生竞争;而全参数微调则成本高昂,还可能干扰已有能力。我们提出了一种名为“自我引导”的机制,使智能体能够从错误中学习,兼具临时性上下文重试与策略更新的优势。当智能体执行任务失败时,它会回顾自身的行动轨迹,从中提炼出经验教训,并立即将其转化为一个轻量级的低秩适配器。通过冻结原始权重,自我引导机制有效避免了适配器训练对原有模型的过度覆盖……
arXiv:2610.32069v1 发布类型:新 提要:近期的多模态大型语言模型(MLLMs)能够在单一模型内感知交通场景、进行推理并提出驾驶决策。然而,现有的基于MLLM的自动驾驶系统在每一帧都从零开始推理,并且仅采纳一种解释,从而舍弃此前关于场景的假设。当场景存在歧义时,智能体便会锁定错误的解读,并在证据尚未充分积累之前据此采取行动。本文提出了DriveMind,一个基于MLLM的驾驶框架,它能够同时维持多个关于场景的假设,并随着新帧的到来不断更新这些假设的权重。受粒子滤波的启发,DriveMind通过视觉语言模型(VLM)传播每个假设,根据当前观测对其进行评分,并重新采样以……
arXiv:2610.31945v1 发布类型:新 摘要:本报告介绍了 Kolibri,一种英德混合的专家级 Transformer 模型,总参数量为 781 亿,每个 token 的活跃参数量为 34.6 亿,并以 Apache 2.0 许可证公开了模型权重。我们构建 Kolibri 的目标是实现主权化与专业化部署,尤其聚焦于德语以及公共管理、工业和航空航天等受监管领域。为支持这些应用场景,我们全程把控模型研发流程,涵盖数据、架构、训练基础设施、后训练阶段及评估环节。我们在预训练、中期训练和长上下文扩展三个阶段累计使用了 24T tokens 进行训练,其中德语数据在字节层面占比超过 20%。为达成这一比例,我们还对德语数据集进行了补充……
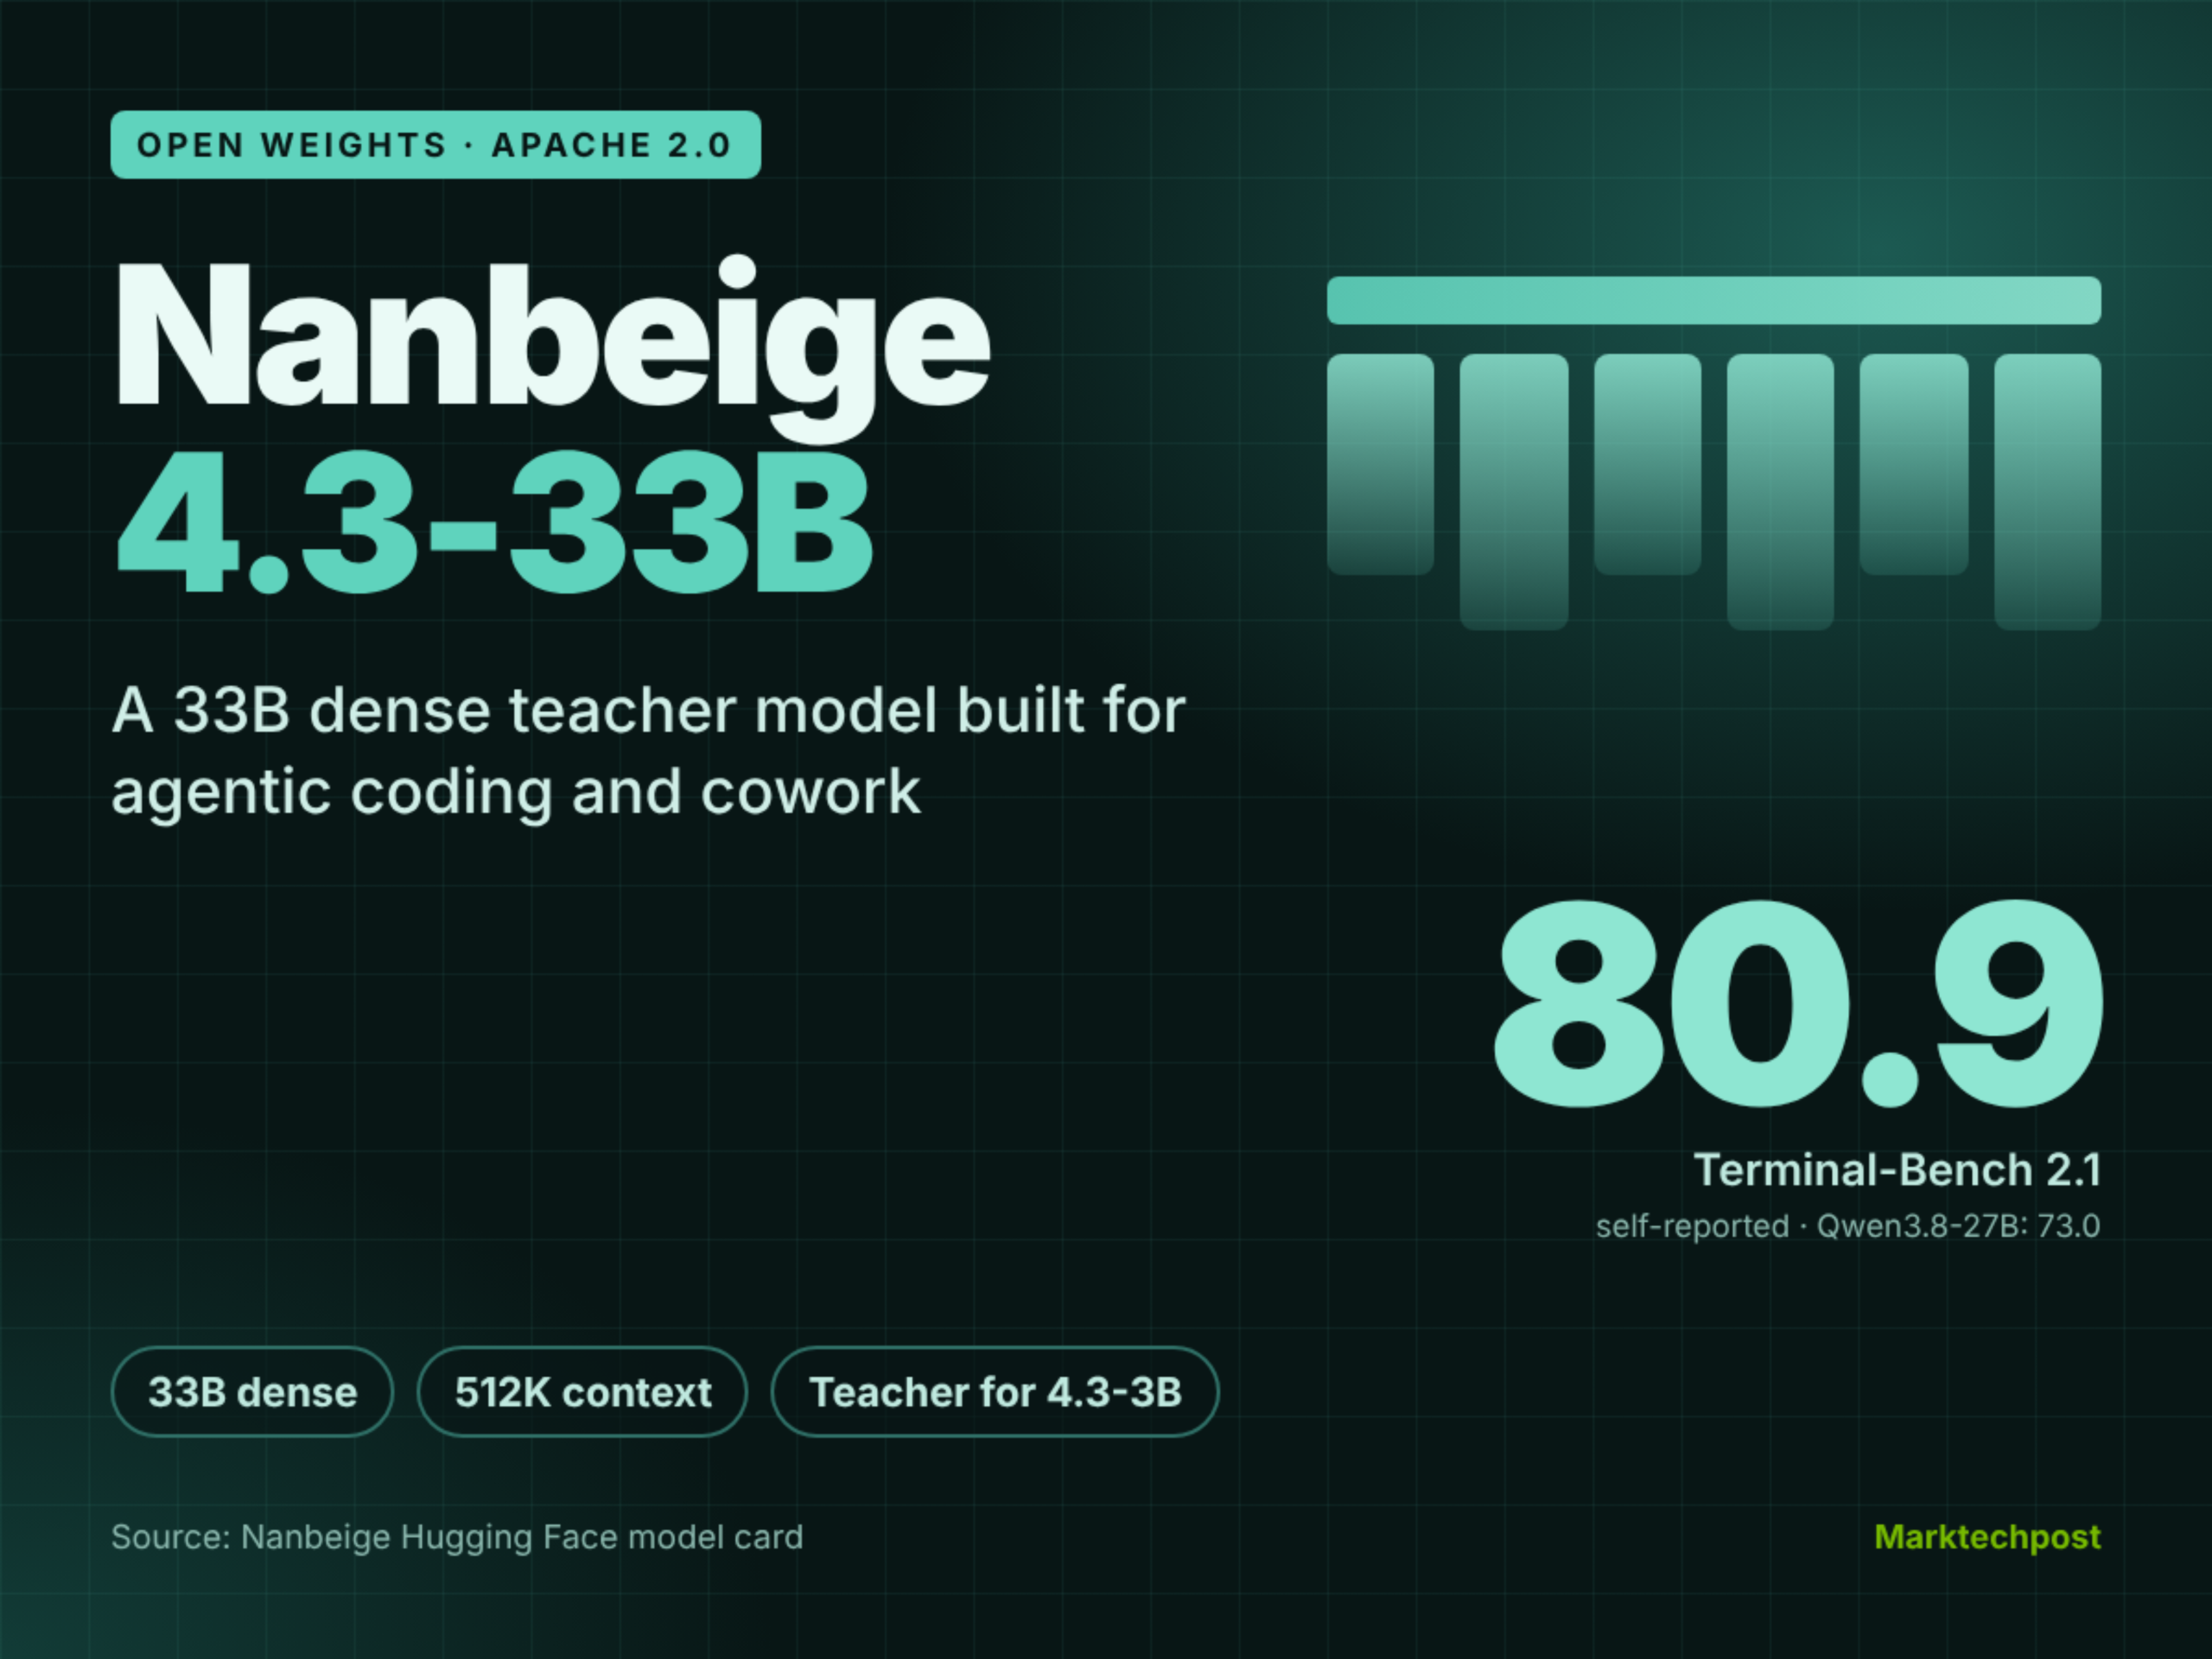
Nanbeige LLM 实验室发布了 Nanbeige4.3-33B,这是一款拥有 512K 上下文的 33B 参数密集型 Apache 2.0 模型。据称,该模型在 Terminal-Bench 2.1 上取得了 80.9 的成绩,并将用于训练即将推出的 Nanbeige4.3-3B。文章《Nanbeige 发布 Nanbeige4.3-33B,一款 33B 开放式智能体驱动编码模型》首发于 MarkTechPost。
月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。
推荐理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。
2026年10月21–22日前后约48小时内,全球密集曝出十余起高危AI加速漏洞与入侵事件,涵盖PHP2Shell、GitLab RCE(CVSS 10)、NGINX/HTTP/3 DoS、LiteLLM密码窃取、eMudhra CA密钥泄露、Quest Diagnostics医疗数据暴露等;Storm-0940等国家行为体利用ARTEX等开源智能渗透框架发起规模化攻击;同期AI安全防御体系加速构建,包括形式化验证、开源修复代理、Agent技能标准化及硬件级优化。
Amazon SageMaker发布训练会话(Training Sessions)API,支持用户以纯Python脚本实现SFT、RLHF、GRPO、KTO等自定义大模型训练逻辑,GPU资源调度、容错、分布式执行及检查点管理均由服务托管。