
Anthropic的IPO招股说明书揭示了其技术内幕
Anthropic于周一提交了文件,为一场备受瞩目的首次公开募股做准备,这些文件披露了该公司的财务状况、风险因素以及其对人工智能未来发展的看法。
检索标题、摘要与正文,把分散的信息连起来。
Anthropic于周一提交了文件,为一场备受瞩目的首次公开募股做准备,这些文件披露了该公司的财务状况、风险因素以及其对人工智能未来发展的看法。
今天,我采访了记者兼新书《AGI编年史》的作者凯文·鲁斯。这本书详细记录了人工智能行业近期发生的剧烈变革。凯文曾长期担任《纽约时报》记者,并主持过热门播客节目“Hard Fork”,但他与节目好友凯西·牛顿刚刚离开了[…]


arXiv:2610.32720v1 发布类型:新 提要:低地球轨道(LEO)卫星巨型星座为对时延敏感的地球同步应用提供了在轨边缘计算能力,但卫星的运动使视距通信窗口被压缩至仅几分钟。为保持逻辑上的地理邻近性,一种被称为“虚拟静止性”(VS)的范式要求应用程序在星座中不断跨过经过的卫星进行迁移。传统的实时迁移机制仅针对单个发起的重定位或复制操作进行优化,而未能满足轨道运动所必需的连续宿主机间切换需求。我们重新将实时迁移表述为一种稳态执行模型,并提出了一种全新的虚拟静止性运行时范式。我们形式化了连续迁移的可行性……

· OpenAI 给 AI 建「离线世界」,隔离模型仍用 CPU 缓存传话 · Reddit 开源社区禁止 AI 项目,连 AI 翻译发帖也被排除#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
Nanbeige LLM 实验室发布了 Nanbeige4.3-33B,这是一款拥有 512K 上下文的 33B 参数密集型 Apache 2.0 模型。据称,该模型在 Terminal-Bench 2.1 上取得了 80.9 的成绩,并将用于训练即将推出的 Nanbeige4.3-3B。文章《Nanbeige 发布 Nanbeige4.3-33B,一款 33B 开放式智能体驱动编码模型》首发于 MarkTechPost。

llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
推荐理由:按信源设置仅收录,不参与自动精选
微软以采用NVIDIA RTX Spark的Surface Laptop Ultra争取本地AI开发者与高端创作者。硬件把大容量统一内存、CUDA和RTX图形能力带入便携设备,但能否形成对Mac的持续竞争,仍取决于应用适配、智能体体验和真实工作流。
推荐理由:这场竞争最终要回答的,是本地AI能否切实改善创作和开发效率,以及用户为此承担的设备、软件与迁移成本是否值得。硬件提供了新的可能性,生态和实际体验决定这种可能性能够覆盖多少用户。
llama.cpp 项目发布构建版本 b11869,主要修复 Jinja 模板中 select 和 selectattr 函数的参数解析逻辑,并提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的数十种硬件与后端组合的预编译二进制包。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp v.b11866 移除了 Metal 后端中已过时的 src1 power-of-two AMAX 缩放机制,转而依赖计算图内更精细的 per expert-token amax 缩放,确保 MoE 下投影激活值在 f16 表示范围内;同步删除相关两阶段归约核、F32 精度调度及越界测试用例。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11865,核心变更包括在 RDMA 接收逻辑中增加内存边界检查(PR #30399),并显著扩展硬件加速支持,覆盖 CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL 及高通 Snapdragon(CPU+Adreno+Hexagon)全栈异构计算后端;macOS KleidiAI 支持与 openEuler 构建被明确标记为 DISABLED。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp v.b11861 修复了 minimax-m3 模型在 NVFP4/MXFP8 量化下因 scale 张量未注入计算图而导致的权重失真问题,避免‘token soup’与残差淹没;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
推荐理由:按信源设置仅收录,不参与自动精选
Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。
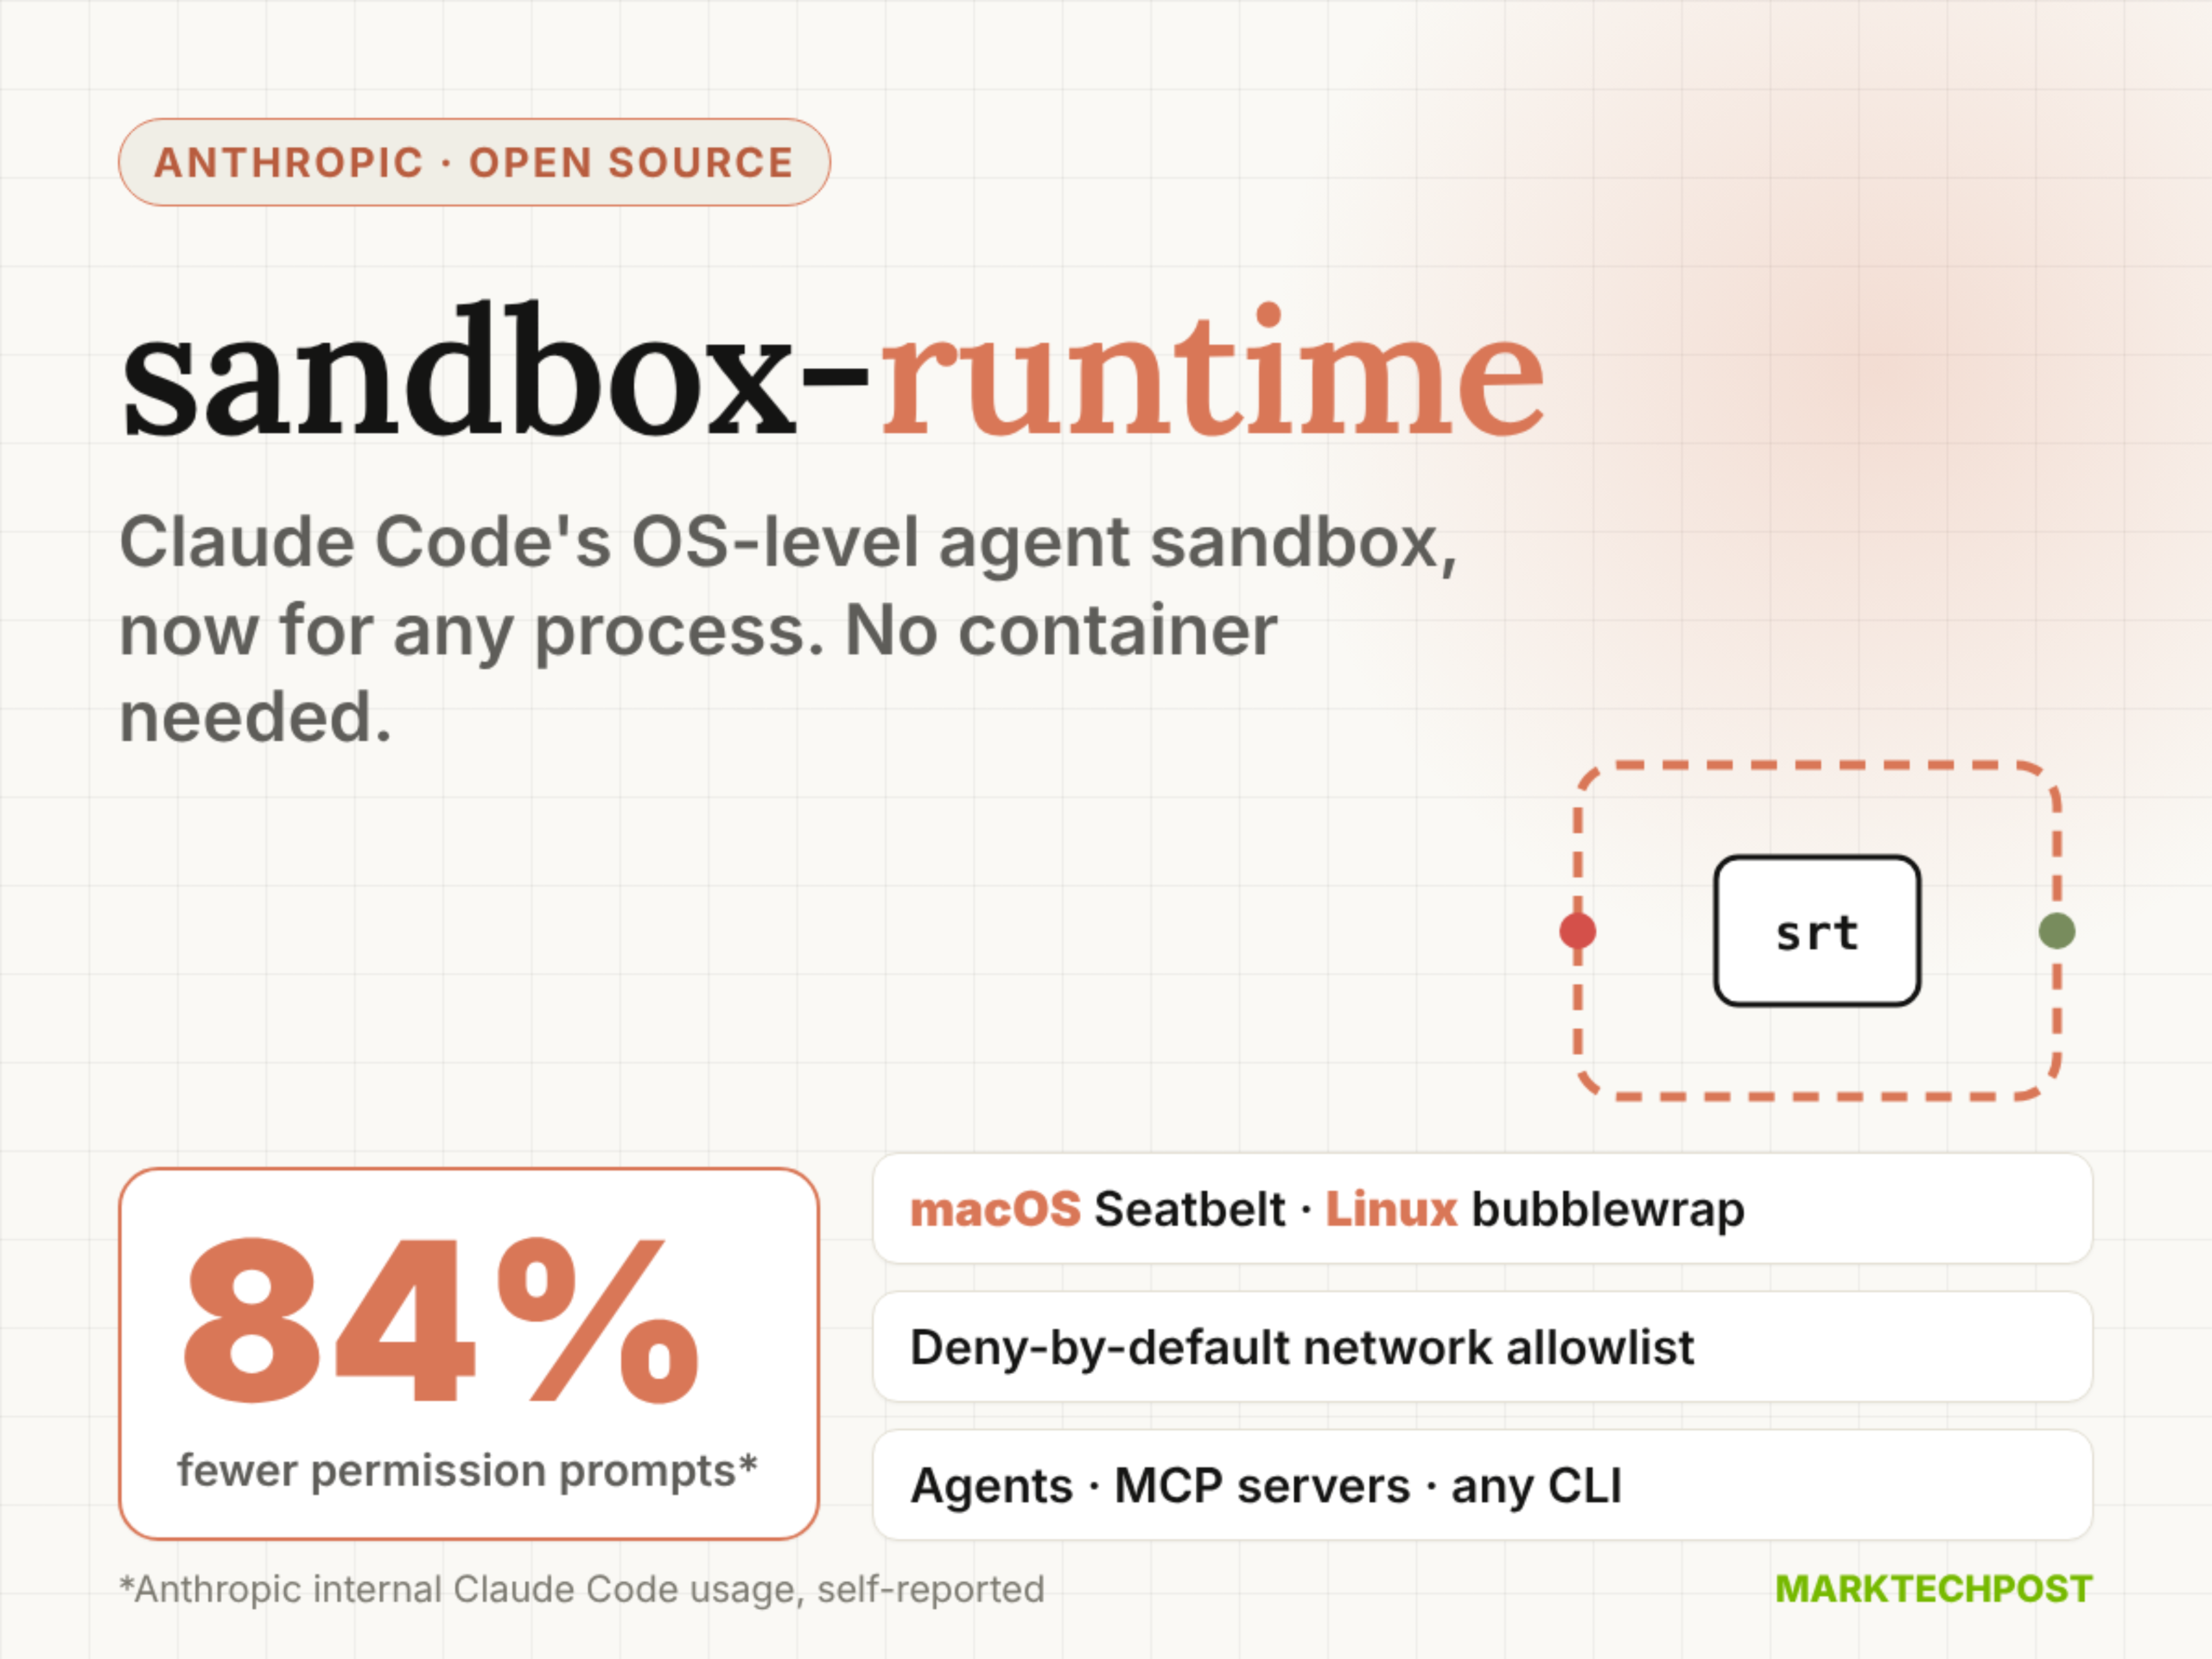
推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。
在2026年10月于柏林举办的GTC大会上,NVIDIA正式推出面向个人、开发者与企业级用户的三款本地AI硬件平台:RTX Spark(Windows PC端个人智能体)、DGX Spark(Linux开发集群)与DGX Station(前沿AI工作站),并同步宣布多项软件更新、模型支持与生态集成。
Vlad Mihalcea、Patrick Baumgartner和Frank Delporte三位资深Java Champion分享了在生产环境与开源项目中使用GitHub Copilot的实践:强调人类主导问题定义、上下文锚定、迭代验证与最终责任归属,而非依赖AI自动生成代码。
Chris Lehane认为,加强AI能力需要更有力的安全证据、共同标准和持久的政策行动,而政策窗口却依然开放.