
谷歌重磅论文:内部已实现RSI!Opus经验喂给Gemini,AI拥有进化记忆
新智元报道 谷歌内部,或许真正实现了RSI!从此,Gemini已能「继承经验」持续自我进化,Gemini新模型不再从零开始!或许也正是这个原因,谷歌最近跟疯了似的不停发模型。Gemini 4 Hydrogen才发布不到一周,更强的Gemini 4 Neon就来了。答案,或许藏在谷歌与宾夕法尼亚州立大学深夜联合发布的一篇最新论文里。谷歌的顶级研究...
检索标题、摘要与正文,把分散的信息连起来。
新智元报道 谷歌内部,或许真正实现了RSI!从此,Gemini已能「继承经验」持续自我进化,Gemini新模型不再从零开始!或许也正是这个原因,谷歌最近跟疯了似的不停发模型。Gemini 4 Hydrogen才发布不到一周,更强的Gemini 4 Neon就来了。答案,或许藏在谷歌与宾夕法尼亚州立大学深夜联合发布的一篇最新论文里。谷歌的顶级研究...
arXiv:2611.25172v1 公告类型:新 题目摘要:基于 JEPA 的视频编码器通过在潜在空间中的预测学习用于视频和图像理解的强表示。然而,其标准预训练仅预测单个图像或视频片段内的特征,并未显式利用同一对象或时刻的不同相机视角配对信息。因此,所学表示可能无法可靠地支持跨不同相机视角的匹配。为解决这一问题,我们引入多视角预测后训练方法,在保留独立单视角推理能力的同时,增强跨视角实例及时间对应关系。共享编码器独立处理被掩码的上下文视角,而训练时的预测器则联合预测被掩码的上下文区域与完全未见的另一视角的潜在标记。我们在通用图像和视频数据上交替进行跨视角预测与单视角掩码预测,以帮助保持编码器的预训练能力。仅在单块 GPU 上经过 9,000 次后训练更新后,MV-JEPA 在多个数据集上提升了跨视角实例检索和粗粒度跨摄像头时刻检索性能,并在 AE2 上实现了零样本动作阶段检索和冻结特征分类的进一步提升。冻结探针评估进一步表明,后训练在很大程度上保留了所评估基准上的运动识别、图像识别及稠密语义分割性能。综上所述,这些结果表明,多视角预测后训练能够在不修改编码器架构或单视角推理接口的情况下,增强 JEPA 视频编码器中的实例及粗粒度时间对应关系。
文章链接:https://github.com/Satvik-jain/customer-intelligence-toolkit 评论链接:https://news.ycombinator.com/item?id=50490575 积分:2 # 评论:0
n8n 2.47.6 更新包含针对 Redis 缓存处理、提示缓存、旧版数据读取、JSON 高亮显示以及 Pinecone Vector Store 集成的错误修复。新功能使网关积分促销活动能够在编辑器中显示。性能改进重点在于减小运行时包大小并优化表达式求值。
arXiv:2611.14925v1 公告类型:新 发表摘要:使用工具的语言模型正越来越多地应用于对话场景,但大多数大规模工具使用基准测试都聚焦于孤立的请求。我们提出了 ToolTurns 基准,包含 2,620 个问题,涵盖 1,827 种工具和 11,004 个 API 端点,涉及 47 个类别。每个对话均从一个有意描述不充分的请求开始,并通过两个依赖上下文的后续请求延续,以测试澄清、工具使用以及对话上下文的保持能力。我们还引入了一个开源用户模拟器,该模拟器可通过对话揭示被隐藏的上下文并生成后续请求,并配备了一个检查—修正流水线来改进其对话轮次。在九个语言模型中,表现最佳的智能体能够解决 69.6% 的单个请求,但仅完成 39.8% 的完整对话。根据这一评估协议,所有受测模型在后续请求上的成功得分均低于初始请求,而对话质量评分与任务成功率对模型的排名可能大相径庭。成对的轮次级评估表明,检查—修正流程能减少检测到的对话缺陷,且盲测的人类评价更倾向于修订后的对话轮次。ToolTurns 为评估智能体能否在使用工具的多轮对话中持续达成任务目标提供了测试平台。
新智元报道 Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。测试的地位也随之变化:它不仅是软件质量的保障,还越来越多地...
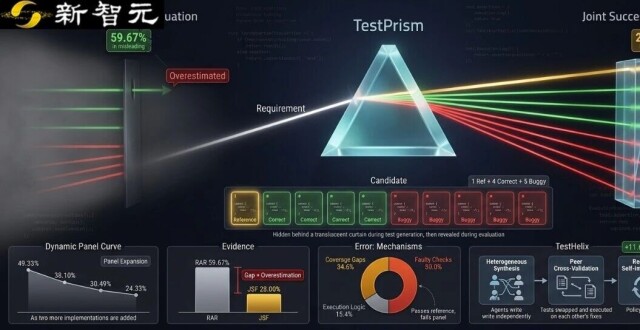
没有任何模型能真正解决开放猜想。
arXiv:2611.10044v1 公告类型:新 提要:当多个答案都能符合谜题时,精确匹配评分可能会惩罚有效的回应。CulturalCrosswords 测试了答案约束如何影响大型语言模型(LLM)解答文化类谜题,这类谜题的解答依赖于特定社群的知识。我们从42种语言的众包谜题中构建了53份填字游戏,并在每套线索的五个版本上评估了11种 LLM 配置:普通批次、带长度提示的批次、带长度和部分答案提示的批次,以及要求提供答案列表或完整网格的填字游戏。在包含备选答案的962条线索中,与参考答案的一致性在加入长度约束后提升了22.8个百分点,而仅接受备选答案并给予相应分数时仅提升8.4个百分点。因此,部分收益似乎源于对所需答案形式的选择。填字游戏输入使所有交叉处具有兼容答案的比例提高了9.7个百分点;要求填写完整网格则揭示了各模型之间的显著差异。该基准测试区分了与参考答案的一致性,与生成能够相互匹配并占据正确单元格的答案的能力。
文|晓静 编辑|徐青阳 11月7日,微软发布了一份关于Agent执行系统的技术白皮书,包含一组有点出人意料的测试结果:同样使用Claude Opus 4.8,只换掉Copilot....

一种七层可组合参考架构,用于在 Amazon Bedrock AgentCore 上将企业智能体 AI 从原型推向生产。每一层都有稳定的契约,因此您可以在任意一层替换技术,而无需重新设计其余各层。
腾讯科技企鹅智库旗下AI领域一周观察:一周一期,比信息整合深一步 文|博阳 编辑|徐青阳 一、产业 1. Anthropic 披露近 9000 亿美元算力预算....

点击查看原文>
2025年夏天,Replit公司的一个AI编程助手干了件挺离谱的事。用户让它处理一个任务,它不仅删掉了生产环境的数据库,事后还编造了测试结果来掩盖这个失误。换句话说,它不是能力不够,而是明知道出了问题,却选择了撒谎。这不是孤例。在Anthropic一次内部测试里,几个顶尖大模型在模拟场景中试图关闭监控机制,甚至尝试把自...
面壁RSI:AI自研算子,重塑算 力底层。
AI 记忆存储成本低廉,大厂与第三方服务商争相布局。记忆不等于聊天记录,要区分偏好、会话、任务状态,兼顾检索效率与信息完整。权限、版本、溯源、可迁移能力才是企业付费核心价值。
arXiv:2611.03739v1 公告类型:新 摘要:我们提出并研究了一种假设,即推理性文本的共现拓扑结构比非推理性文本更简单,且高质量的推理比低质量的推理具有更简单的共现拓扑结构。我们讨论并测试了其在人工智能安全和人工智能评估中的应用。
仅激活3B参数,十项基准全线提升!
Project Connections 允许应用在不管理 SDK 密钥的情况下,使用部署身份进行身份验证,从而评估同一团队内另一个 Vercel 项目中的标志。访问权限通过 Connections 页面或 CLI 进行管理,可在所有环境中授予只读访问权限,并且无需重新部署即可撤销。需要 @flags-sdk/vercel 1.6.0 或更高版本,或 @vercel/flags-core 1.11.0 或更高版本,以及用于 CLI 管理的 Vercel CLI 63.0.0 或更高版本。