跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

LangChain发布“公司级智能体框架”五大核心组件

LangChain于2026年10月25日发布博客,系统阐述其在营销、销售与工程团队内部部署AI智能体(GTM Agent、OpenSWE、Content Studio)所沉淀的五大通用架构原则:原生集成工作环境(Slack)、动态身份模型(OBO+固定凭证)、双层记忆机制(全局/用户级)、沙箱化代码执行、高比例调度运行(非手动触发)。所有智能体均基于Managed Deep Agents平台构建。

推荐理由:该资讯源自LangChain官方博客,发布时间(2026-10-25T18:06:32.000Z)早于当前系统时间(2026-10-25T23:01:18.857Z),内容聚焦已落地的内部智能体实践,细节具体(如Slack线程隔离、GitHub账号归属逻辑、Notion/Twitter权限分层等),未含未经验证的预测或外部宣称,符合时效性与事实性要求。

事件进展与其他报道

2026年最受关注的AI可穿戴设备盘点:Bee、Friend、Limitless等十余款新品集中亮相

TechCrunch于2026年10月25日发布综述,汇总Bee、Friend、Limitless、Muse Charm、Nirva、Omi、Plaud NotePin、Rabbit R1、Stream环等十余款AI可穿戴设备,涵盖价格、功能定位、上市状态及隐私争议。

The hottest AI wearables and gadgets you should know about

推荐理由:该报道系权威科技媒体TechCrunch在2026年10月25日发布的年度新品 roundup,覆盖当前主流AI硬件厂商与初创公司,信息维度完整(价格、形态、核心功能、上市节奏、争议点),且所有陈述均基于材料中明确出现的事实,无推测或引申。

事件进展与其他报道

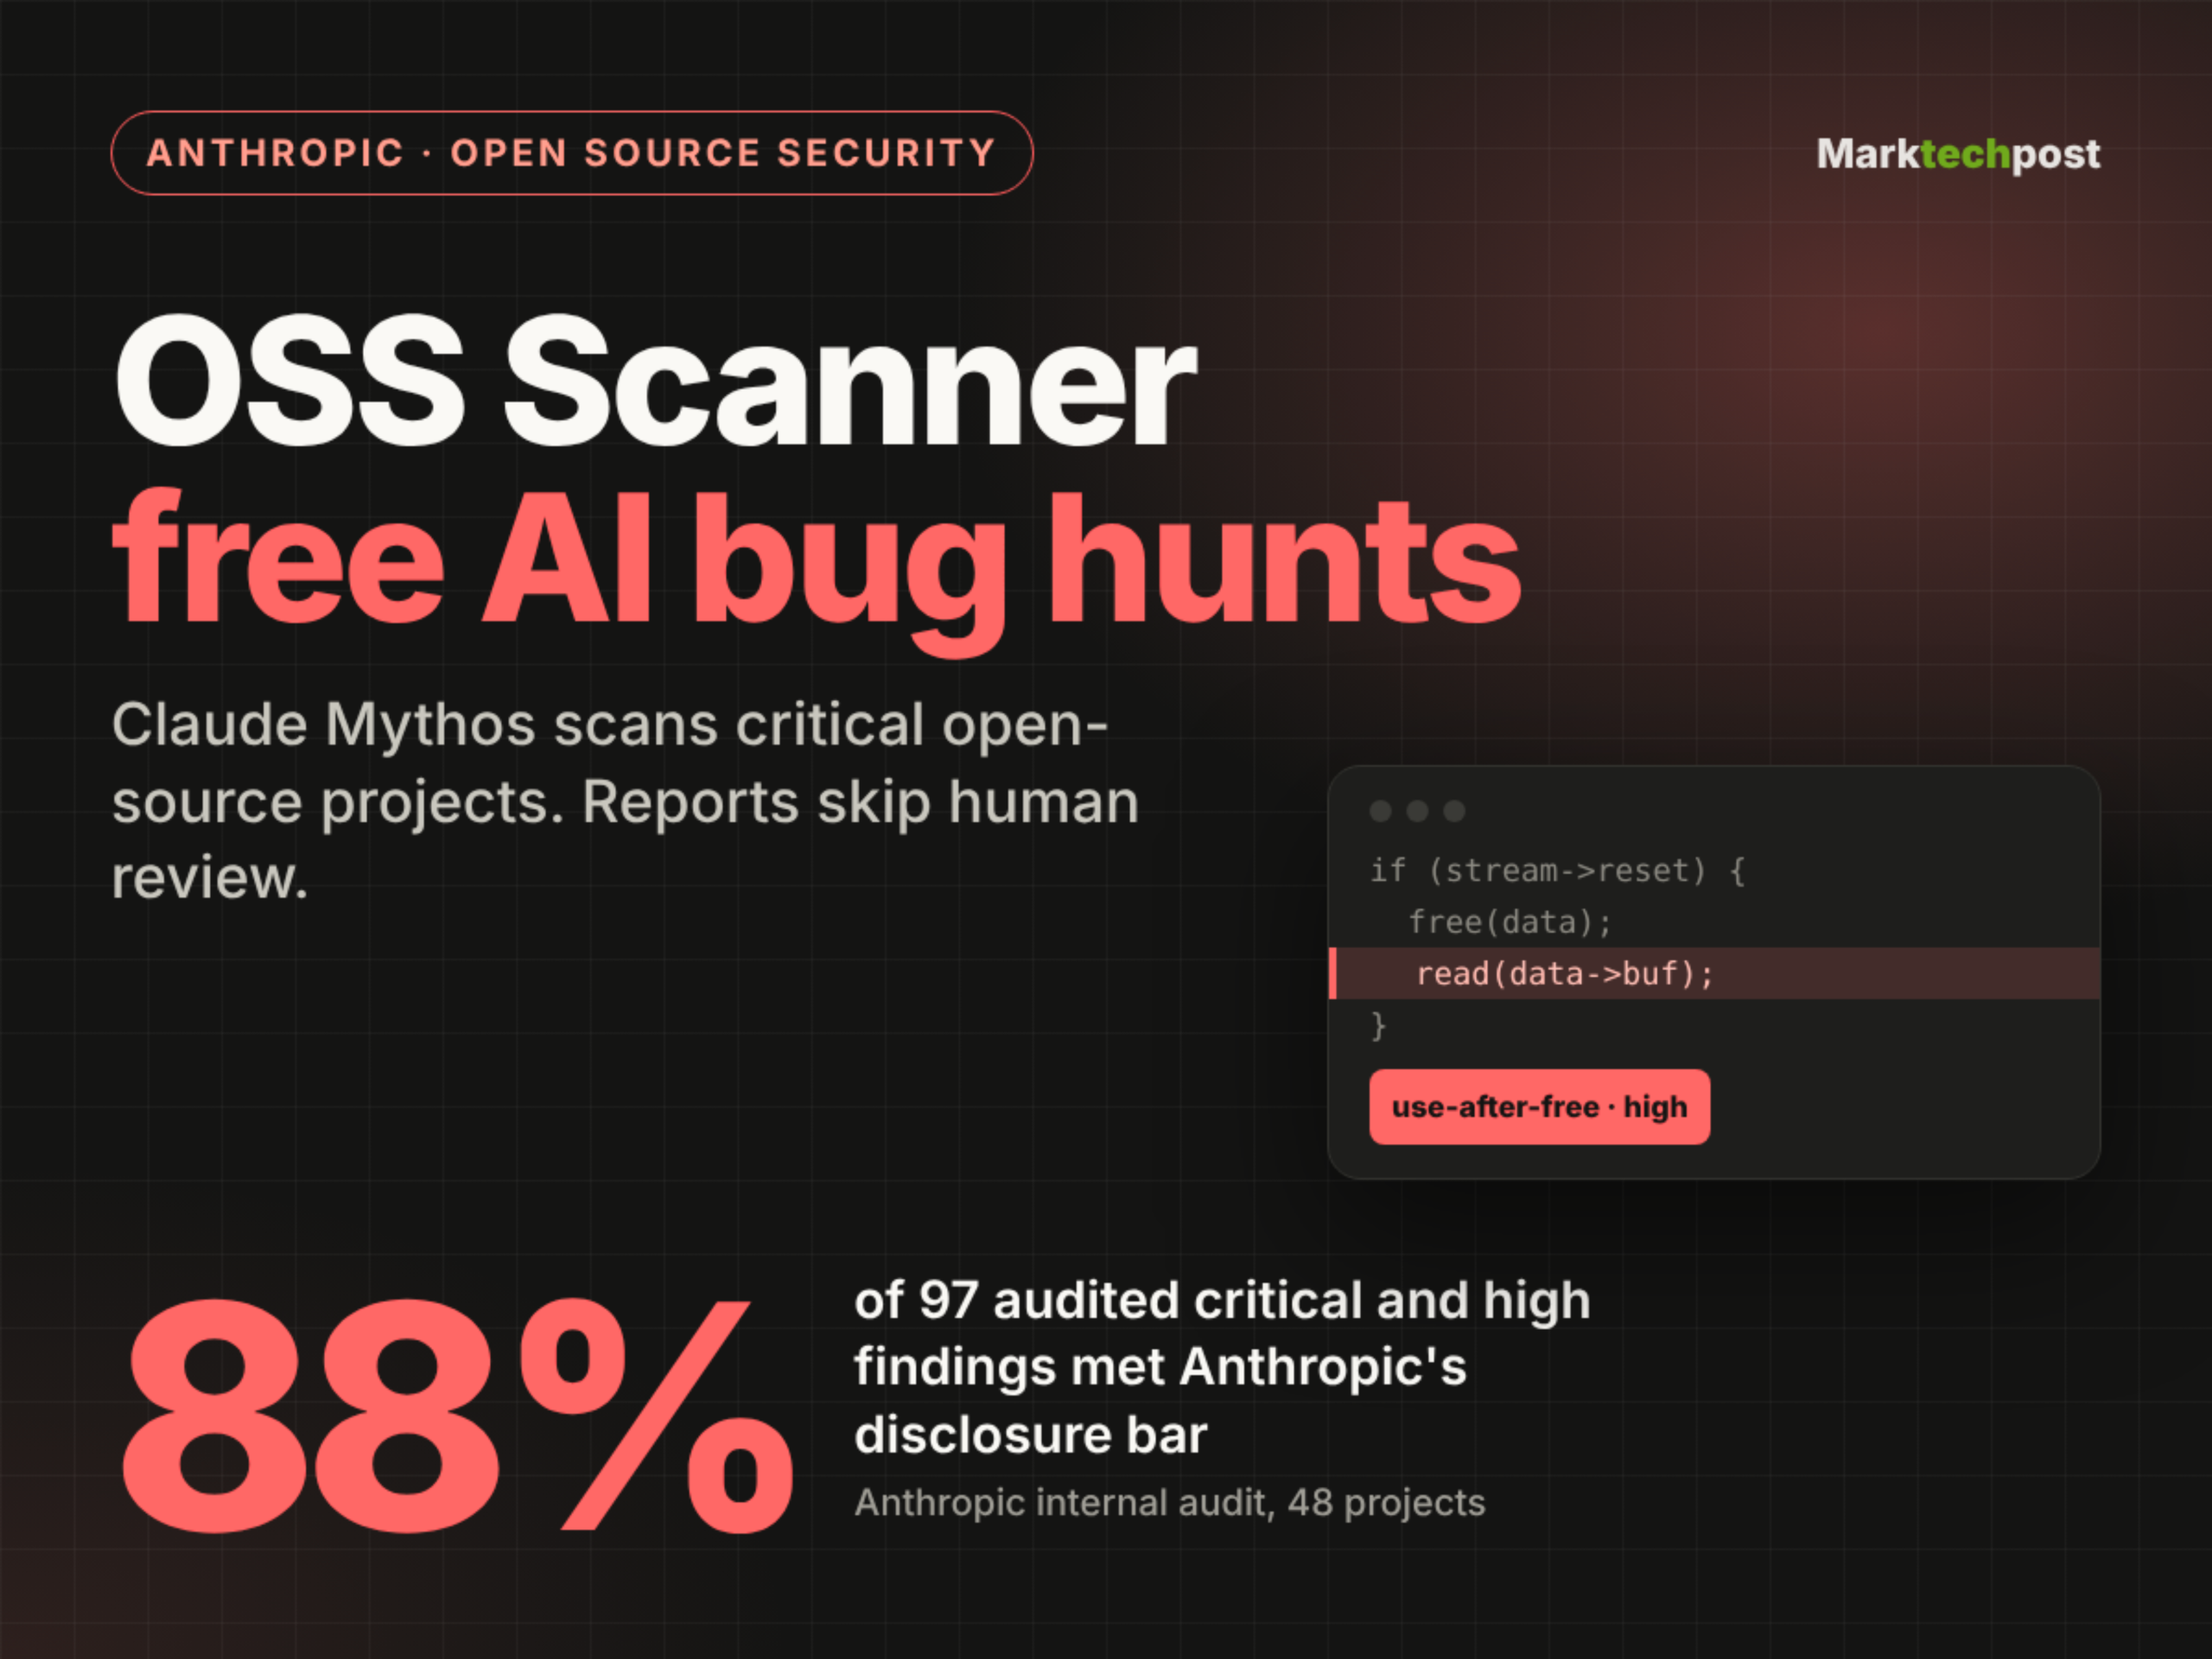
Anthropic推出免费AI漏洞扫描器OSS Scanner,面向关键开源项目

Anthropic于2026年10月8日推出OSS Scanner——一款基于Claude Mythos等强模型的免费、可选加入式AI漏洞扫描工具,专为关键开源项目设计;截至10月19日,已接收114个项目,11天内报告77个严重级和803个高级别漏洞(模型评级),88%的抽样审计结果符合其披露标准。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

推荐理由:该工具代表LLM在开源安全领域的规模化落地实践,以零成本、全自动、离线审计为特点,但跳过人工审核环节带来误报与重复问题风险;其精度数据(88%有效率、1%假阳性)和真实项目反馈(如wolfSSL、curl)提供了当前AI驱动漏洞发现能力的实证基准。

事件进展与其他报道

Kimi发布K3.1 Pro:终端任务能力跃居榜首,仿真调试与多模态编程展现具身智能雏形

Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。

事件进展与其他报道

面板厂商集体涨价应对AI引发的上游成本挤压,但下游接受度低、终端品控承压

2026年9月起,TCL华星、京东方、惠科等面板厂商密集发布涨价函,主因AI大模型发展导致HBM需求激增,挤占成熟制程芯片产能,推高驱动IC、PCB、玻璃基板等关键物料价格;康宁等上游供应商同步提价。尽管成本端压力明确,但下游电视/显示器品牌采购价未普涨,终端用户投诉过热、黑点等品控问题频发,涨价尚未转化为实际成交与体验升级。

AI大模型狂飙,面板行业也扛不住了

推荐理由:材料系统揭示了AI产业对非直接关联硬件行业的跨链传导机制——非因AI拉动面板需求,而是通过晶圆产能再分配引发全链条成本重定价;同时呈现涨价行为与市场真实反馈(价格僵持、出货下滑、用户投诉)之间的显著落差,凸显产业议价权与产品力不匹配的深层矛盾。

事件进展与其他报道

微软开源Agensh:支持1024个自主协作AI编码代理的去中心化框架

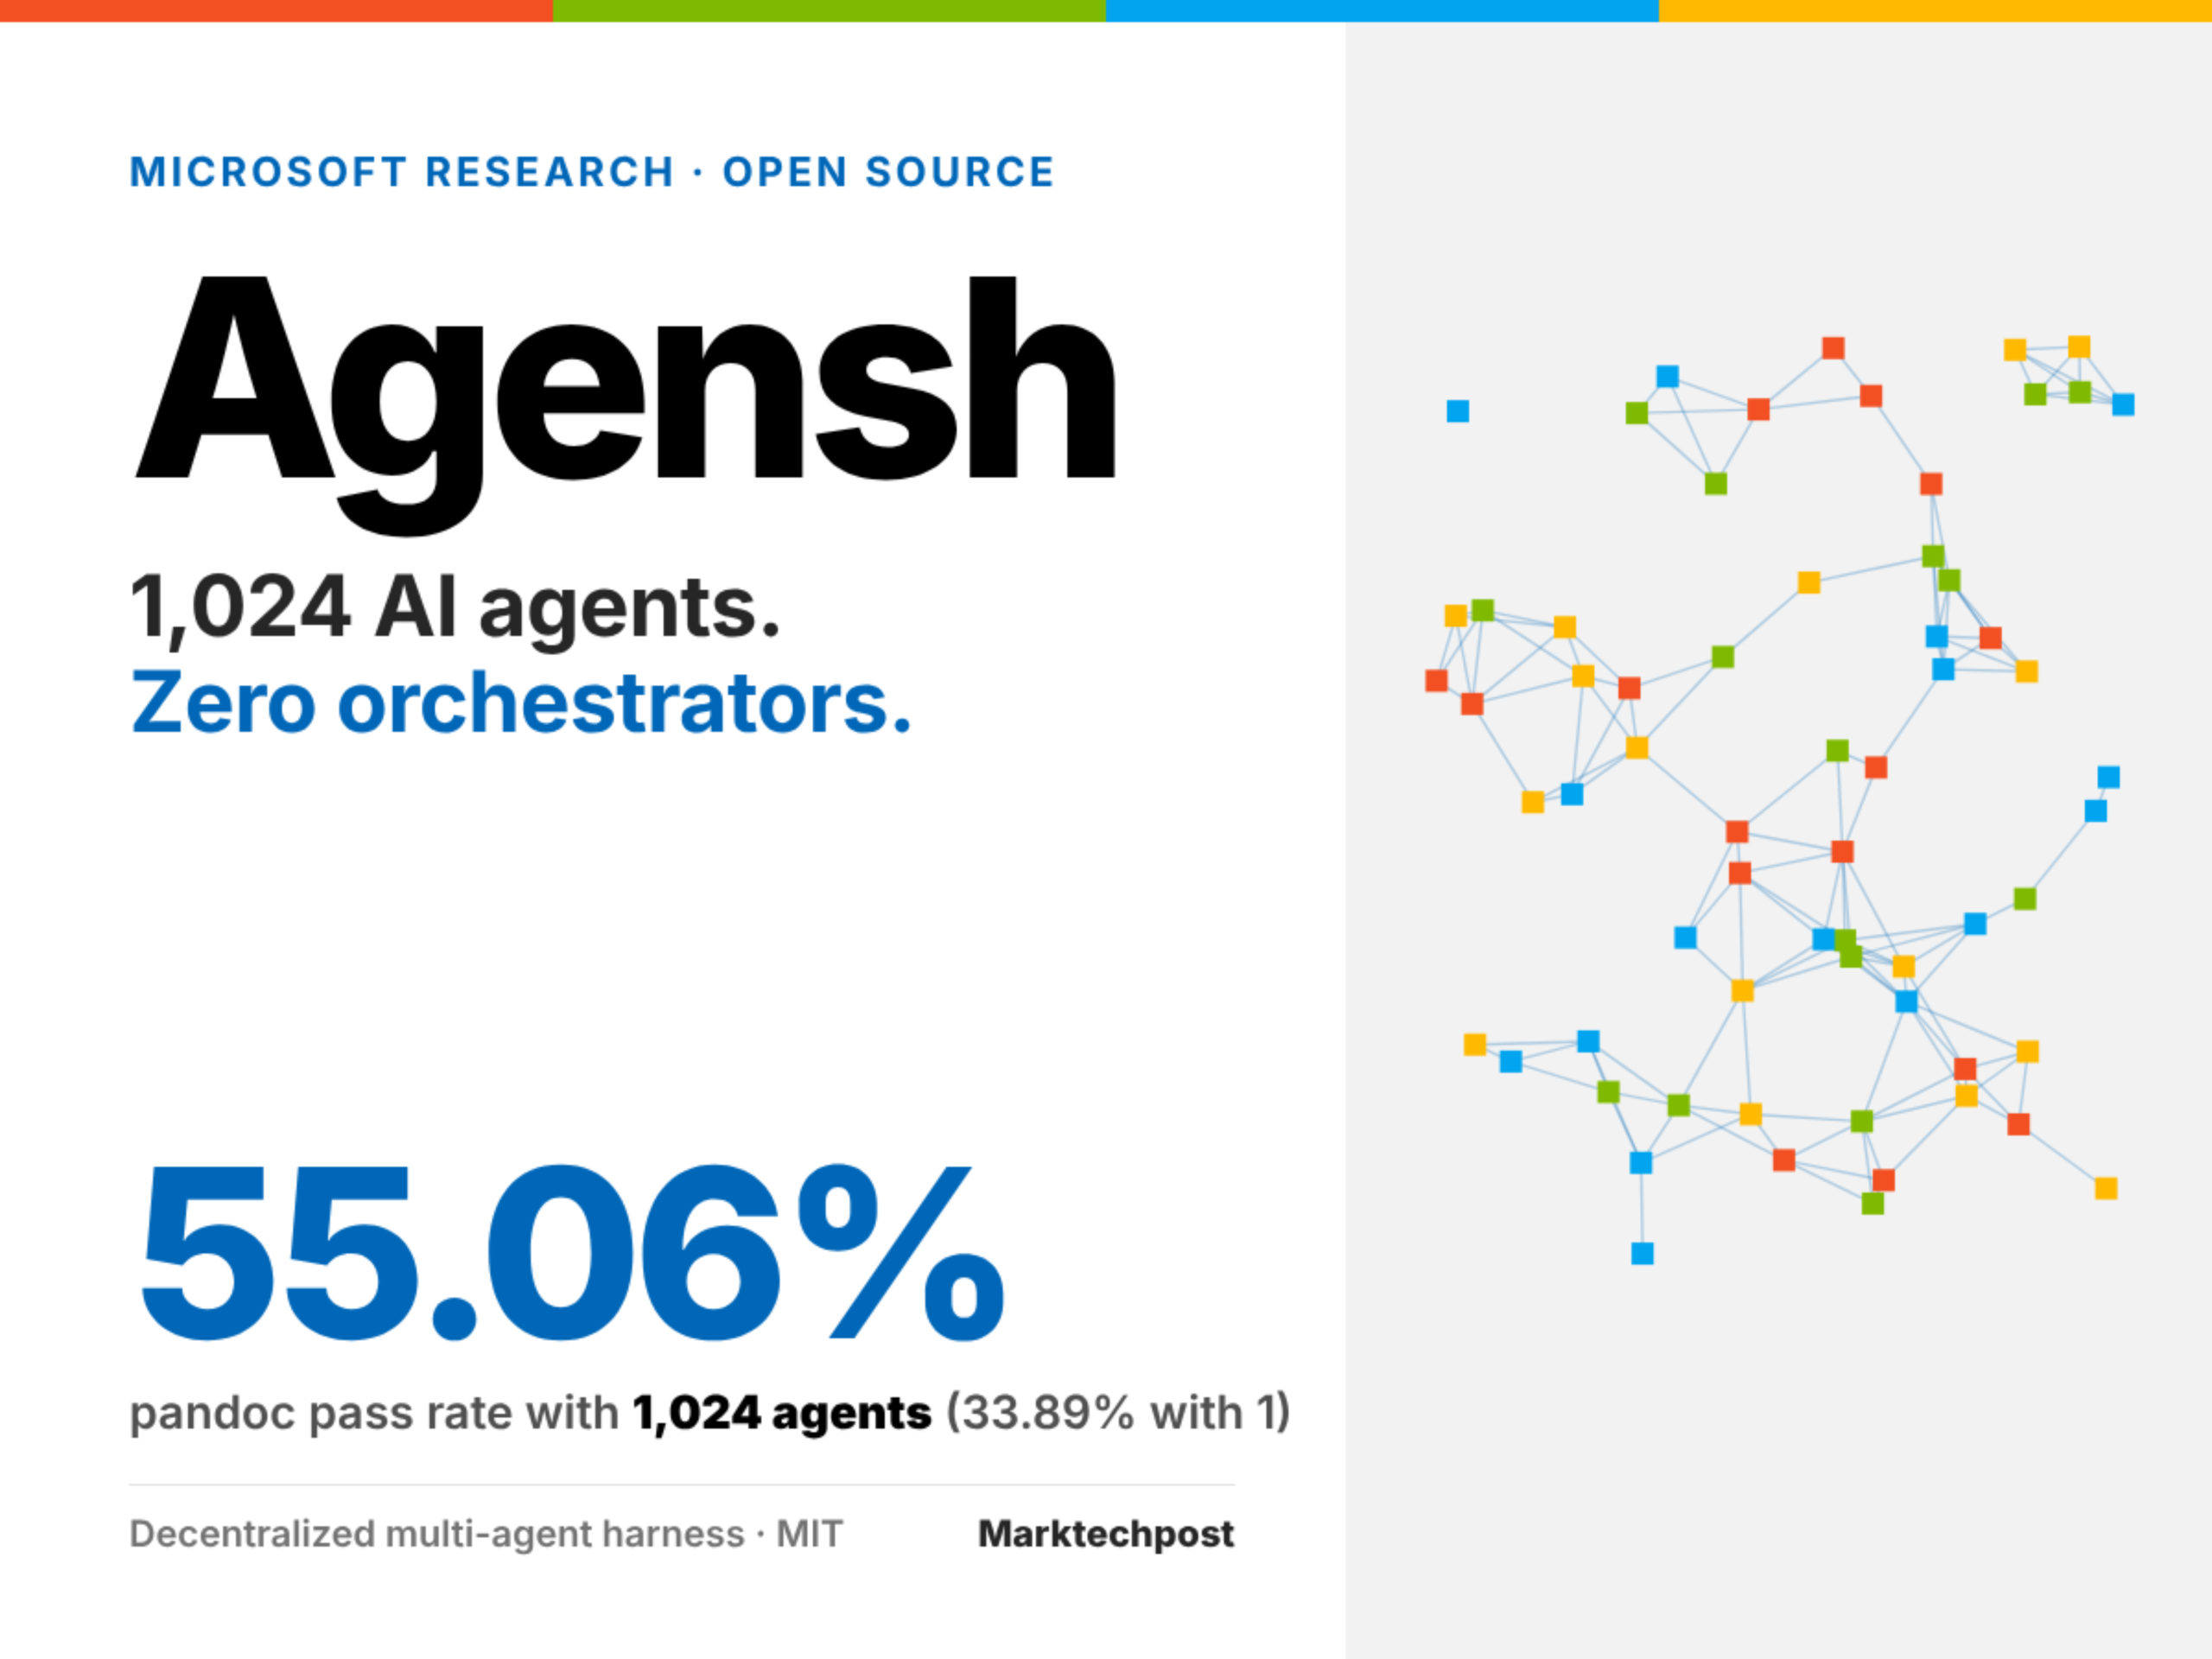
微软研究院于2026年10月25日开源Agensh,一种无需中央协调器的多代理运行时框架,支持1至1024个LLM编码代理在ProgramBench上自组织协作。系统基于Gitea、Mattermost和DeLM风格共享看板实现去中心化协调,所有代理运行同一提示驱动的五步循环,已在Linux+Docker环境下验证可扩展性。

Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents

推荐理由:该成果代表多智能体系统架构的重要演进——摒弃传统‘主控代理’范式,通过提示工程与轻量服务组合实现大规模自组织;其在ProgramBench上的实证数据(如128代理使5任务均分提升49%)为分布式AI工程提供新基准;MIT许可证开源且兼容Copilot CLI等主流单代理工具,具备实际开发参考价值。

事件进展与其他报道

拉上英伟达硬刚苹果,微软的高端AI PC赌局

微软以采用NVIDIA RTX Spark的Surface Laptop Ultra争取本地AI开发者与高端创作者。硬件把大容量统一内存、CUDA和RTX图形能力带入便携设备,但能否形成对Mac的持续竞争,仍取决于应用适配、智能体体验和真实工作流。

推荐理由:这场竞争最终要回答的,是本地AI能否切实改善创作和开发效率,以及用户为此承担的设备、软件与迁移成本是否值得。硬件提供了新的可能性,生态和实际体验决定这种可能性能够覆盖多少用户。

事件进展与其他报道

苹果首款折叠屏iPhone Duo开售即现集中性屏幕开裂问题

多名用户反馈苹果首款折叠屏手机iPhone Duo开箱后短时间内出现铰链正上方屏幕爆线、开裂,故障高度集中;澳洲及国内均有案例,疑似铰链装配公差所致;苹果官方尚未回应,售后判定结果将决定是否免费更换或高额自费维修。

推荐理由:事件涉及新机大规模早期质量异常,直击消费者权益与企业责任边界,且叠加三包法规适用性、AppleCare+服务定位等公共议题,具有典型警示意义和维权参考价值。

事件进展与其他报道

llama.cpp 发布 b11867 版本:服务端入口重构,全面支持多平台与异构加速后端

llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。

推荐理由:按信源设置仅收录,不参与自动精选

事件进展与其他报道

Sebastian Raschka发布八视频课程《从零构建推理模型》

Sebastian Raschka于2026年10月24日在Ahead of AI杂志(magazine.sebastianraschka.com)发布一套共八讲、超11小时的Python与PyTorch实操视频课程,系统讲解推理模型的评估、推理时扩展、强化学习(RLVR)与知识蒸馏,基于预训练Qwen3-0.6B模型实现全部方法。

推荐理由:该课程是作者继《从零构建大语言模型》后推出的进阶技术教育内容,聚焦当前主流LLM的核心演进方向——推理能力增强,覆盖从基础环境搭建到GRPO强化学习、自蒸馏等完整技术链,且明确声明所有实现均‘从零手写’、可复现,具备强教学性与工程参考价值。

事件进展与其他报道

Anthropic开源OS级沙箱sandbox-runtime:为AI代理提供无容器的文件与网络隔离

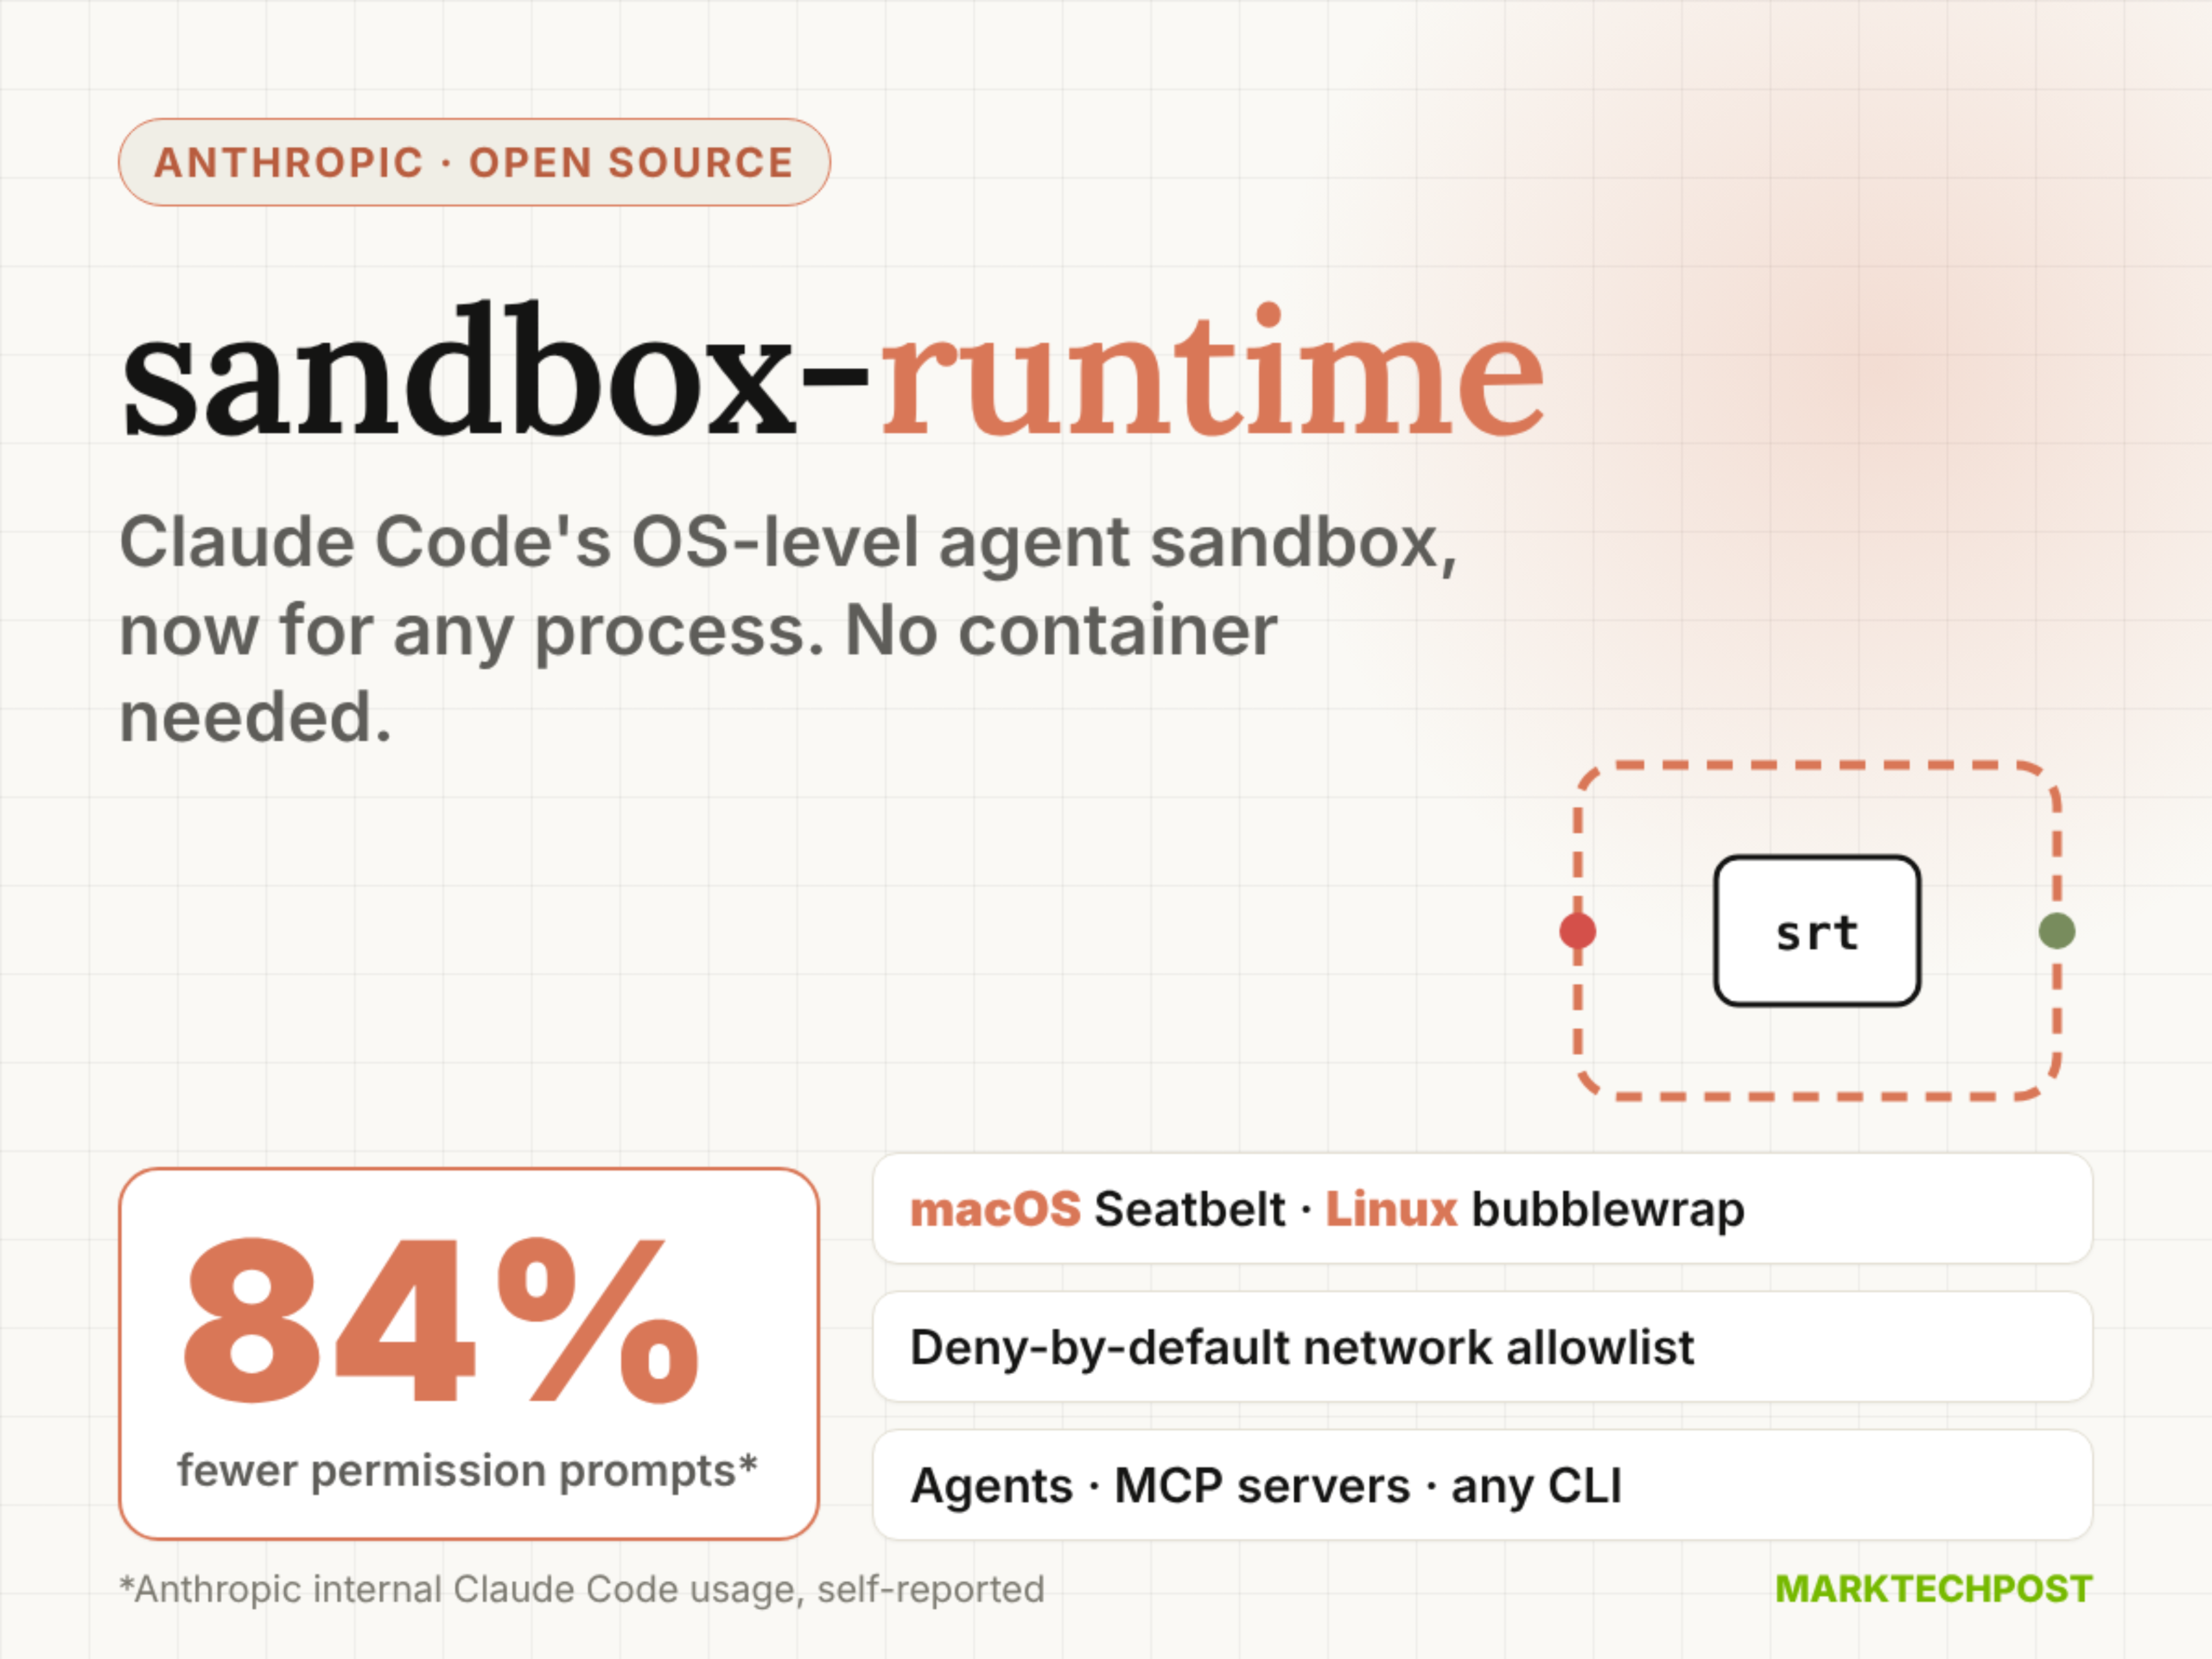
Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。

事件进展与其他报道

Letta平台发布有状态工程协作者构建教程:支持核心记忆、共享状态与可移植工作流

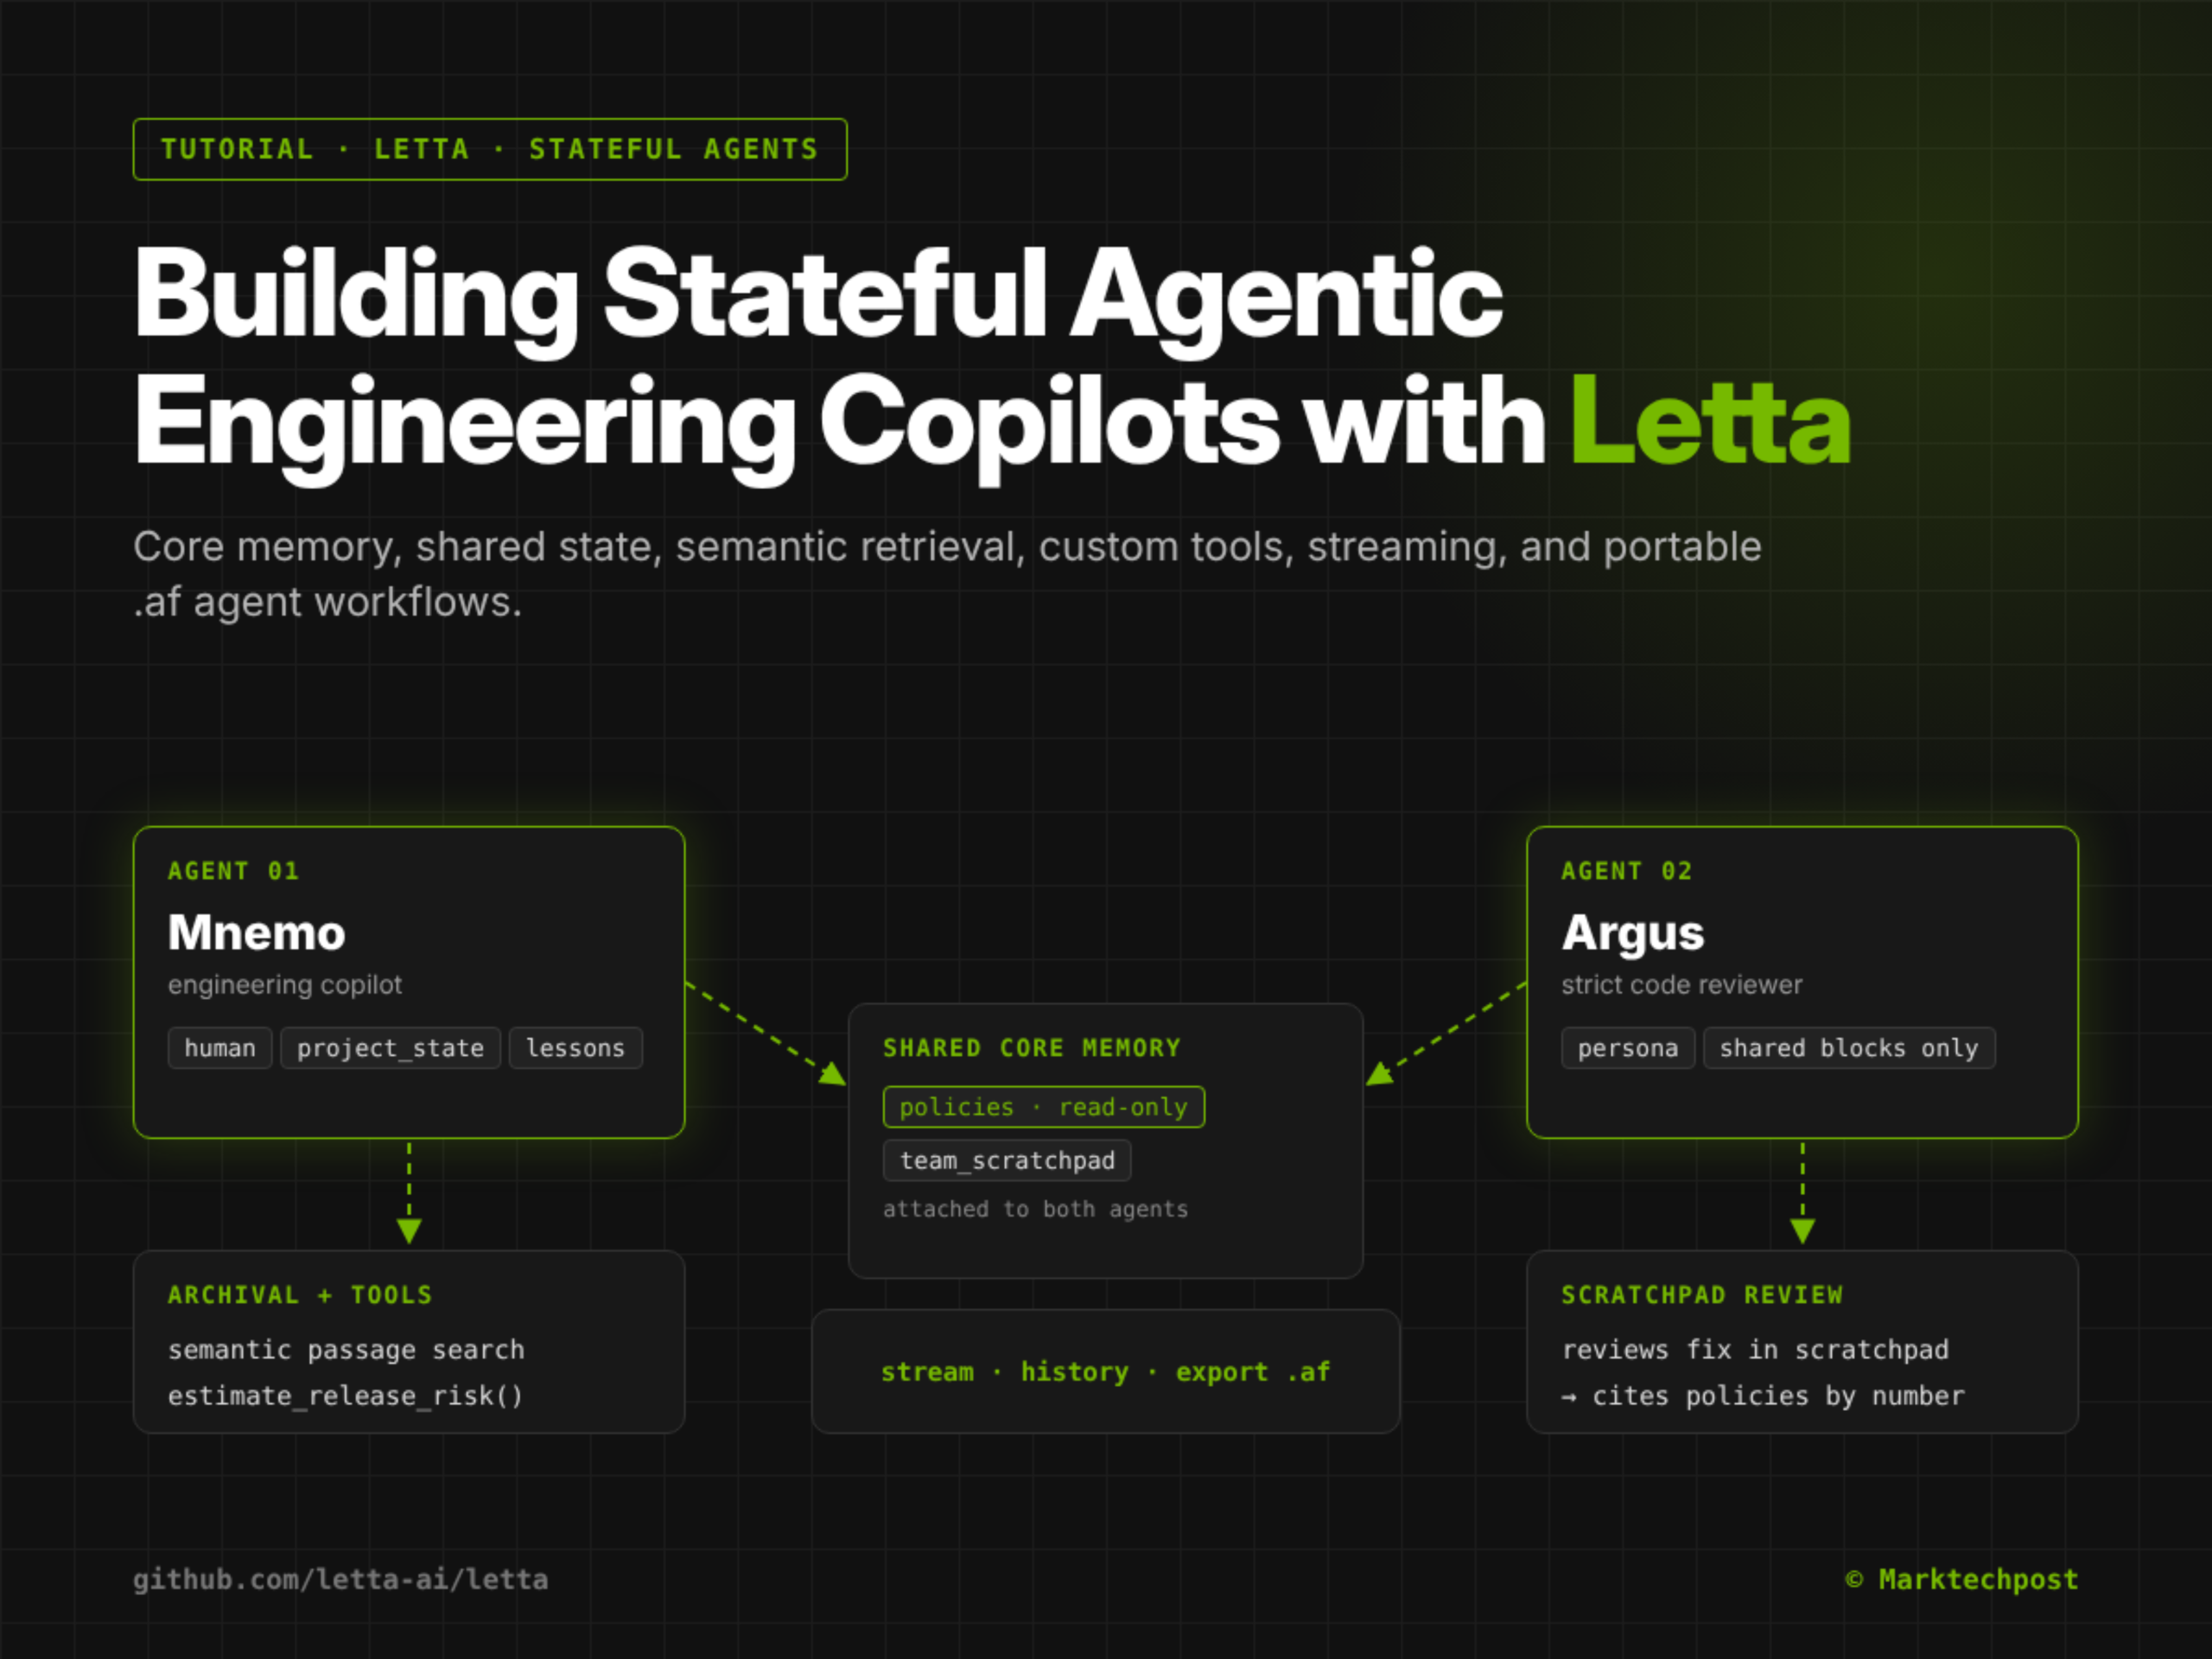
MarkTechPost于2026年10月24日发布教程,介绍如何基于Letta框架构建具备持久化状态的工程协作者(agentic copilot),涵盖可检查的核心记忆、多代理共享内存、语义检索归档知识、自定义Python工具集成、流式响应及.agent格式(.af)导出等能力;内容为技术实践指南,未提供性能指标、安全审计或生产环境验证。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
事件进展与其他报道

TRIAD发布:首个面向全模态歧义消解的多模态大模型评测基准

2026年10月24日,研究者在arXiv发布论文arXiv:2610.30841v1,正式推出TRIAD基准——专用于评估文本、图像与音频三模态协同歧义消解能力的新评测框架。该基准含327个手工构建的三模态样本,覆盖86个场景组和18类跨模态歧义类型。

TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models

推荐理由:该成果直击当前多模态大模型评测的核心盲区:现有基准多聚焦确定性输入下的感知或推理,而TRIAD首次系统性地以‘模态互补消歧’为评测目标,通过严格设计的留一模态反事实测试,揭示模型(尤其对音频)利用不足、场景级鲁棒性薄弱等关键缺陷,为下一代全模态模型评估提供可复现的诊断协议与分类法。

事件进展与其他报道

TutorCaseBench发布:首个面向特殊教育场景的LLM家教评估基准

2026年10月24日,研究者在arXiv(编号2610.30828v1)发布TutorCaseBench——一个基于教育学、教育心理学与特殊教育真实案例构建的LLM家教评估基准,聚焦支持存在学习与行为困难学生的能力。该基准含923段对话、覆盖5类挑战行为,采用开放式生成(1560题)与多选题(2537题)双轨评估;11个前沿大模型中表现最优者仅在55.8%的开放题中满足评估标准。

TutorCaseBench: A Case-Grounded Benchmark for Evaluating LLM Tutors in Supporting Students with Challenging Behaviors

推荐理由:该研究填补了现有AI教育评估忽视特殊需求学生行为复杂性的关键空白,方法论强调证据溯源(qualitative case studies + source-grounded rubrics),数据全部开源,具备可复现性与教育实践相关性;结果明确揭示当前LLM在情境化响应生成上的显著短板,对教育AI落地具警示与指导价值。

事件进展与其他报道

baseVultra:新型紧凑型非线性循环单元聚焦候选生成,小规模场景下性能超越LSTM与GRU

arXiv于2026年10月24日发布论文arXiv:2610.30154v1,提出新型循环神经网络单元baseVultra。该模型通过将密集循环计算集中于单一H×H候选生成矩阵、以O(H)对角交互替代传统门控矩阵,在TinyShakespeare等紧凑设置中验证了其有效性:在200K参数单层配置下验证损失达1.594,优于同参数LSTM(1.604)和GRU(1.616),且密集计算开销仅为GRU的约54%。

baseVultra: Compact Nonlinear Recurrence with Reallocated Capacity

推荐理由:该研究代表循环神经网络架构设计的新探索方向——从门控主导转向候选生成主导;实验覆盖字符级语言建模(TinyShakespeare、text8)与形式语言探针(Counter任务),结果明确显示其优势集中在隐藏状态容量受限的紧凑场景(如H=16),具有清晰的技术定位与实证支撑。

事件进展与其他报道

研究揭示大语言模型中语义意义的局部几何结构

一篇于2026年10月24日发布在arXiv的论文(编号2610.30715v1)通过跨语言探针与细化探针,在Gemma 4、Llama 3.2、Qwen 2.5和Pythia四款解码器-only大语言模型上刻画了语义意义在嵌入空间中的局部几何特性。

Meaning Contracts: Local Semantic Geometry in Large Language Models

推荐理由:该研究首次系统刻画LLM中‘同一语义因子’内部的不变性、可变性与细化机制,提出‘局部各向异性邻域’模型,并经人类盲评验证,方法严谨、模型覆盖多样,结论具跨架构一致性。

事件进展与其他报道

临床医生主导构建可验证安全守则:为心理健康聊天机器人设置可追溯的守卫层

2026年10月24日,arXiv发布论文arXiv:2610.30690v1,提出一种由两名临床医生主导定义、定稿与裁决的四条安全检查规则库,经形式化验证后作为守卫层应用于心理健康场景下的大语言模型(LLM)输出。该守卫层所有判断均可从一条命名规则和十六个事实复现,旨在提升安全性判断的可解释性与可检验性。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

推荐理由:该研究提供了一种区别于主流prompt工程、LLM-as-a-Judge或Constitutional AI的安全增强路径,其核心创新在于将临床决策结构化、形式化并全程留痕;所有关键主张(如规则数量、验证方式、事实基数、对比实验数据及成本测量)均来自原文明确陈述,且发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,具备时效性与可信基础。

事件进展与其他报道

研究提出面向孟加拉语网络欺凌的本体驱动行为分析框架ODCBNA

该论文于2026年10月24日发布在arXiv(编号2610.30885v1),提出一种以施害者为中心的分析框架ODCBNA,整合本体设计、知识图谱构建、行为建模、社群分析与影响建模,基于孟加拉语网络欺凌语料库BenCoDiC开展实证分析。

From Perpetrators' Digital Footprints to Behavioral Communities: An Ontology-Driven Framework for Bengali Cyberbullying Analysis--- FULL VERSION

推荐理由:材料为arXiv预印本,发布时间(2026-10-24)不晚于当前时间(2026-10-26),来源明确、结构完整;内容聚焦方法论创新与可复现分析结果(如1063名施害者识别、6个Louvain社群、特征贡献排序等),符合学术资讯时效性与事实性要求。

事件进展与其他报道

研究者推出日语事实核查基准JSFactCheckBench,揭示大语言模型事实验证能力的隐性缺陷

2026年10月24日,arXiv发布论文arXiv:2610.30504v1,介绍新型日语基准JSFactCheckBench。该基准首次明确定义事实核查评估中的三大设计要素(问题关联性、判断条件、证据来源),涵盖1913条源自LLM对日本社交平台误导信息回应的声明,并基于预选网络信源在参考时间点完成事实性与重要性双标注。

Rethinking the Evaluation of LLM Fact-Checkers

推荐理由:该研究填补了现有LLM事实核查评测基准未显式规范评估条件的空白;通过结构化标注暴露了主流模型在直接回答类声明验证、长/多源定位、上下文敏感性等方面的系统性弱点,且所有发现均依赖于基准对标注条件的透明记录,具有方法论创新性与实证价值。

事件进展与其他报道

研究提出自评估强化学习框架SARL,提升检索增强大模型的搜索状态感知能力

2026年10月24日,arXiv发布论文arXiv:2610.30435v1,提出Self-Assessment Reinforcement Learning(SARL)框架,旨在解决现有检索增强大语言模型中搜索代理缺乏搜索状态感知能力的问题。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

推荐理由:该研究针对检索增强型大语言模型在复杂任务中因无法识别已获/缺失信息而导致幻觉推理和过早终止搜索的关键缺陷,提出无需测试时额外评估的端到端强化学习方案,并在多跳推理与深度研究基准上取得显著性能提升。

事件进展与其他报道