跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

中国发射10颗卫星验证“天数天算”:在轨AI计算开启太空智能体时代

2026年10月14日,朱雀二号改进型遥四火箭成功发射10颗卫星,含国星宇航“星算”计划02组8颗算力卫星及蓝塔智能2颗光传试验星,首次规模化验证卫星在轨AI推理、星间激光通信、万瓦级液冷散热等关键技术;截至本次发射,“星算”星座在轨总算力达50P,标志中国太空算力枢纽建设实质性落地。

推荐理由:材料源自钛媒体授权发布的行业深度报道(发布于2026-10-26),内容聚焦刚完成的航天任务与可验证技术进展,所有关键事实(时间、主体、载荷、算力数值、验证方向)均来自文中明确陈述,且与公开信源如央视新闻、科技日报、官方试验节点相互印证;事件发生于当前时间之前(2026-10-14),具备时效性与实证基础。
事件进展与其他报道

Kimi发布K3.1 Pro:终端任务能力跃居榜首,仿真调试与多模态编程展现具身智能雏形

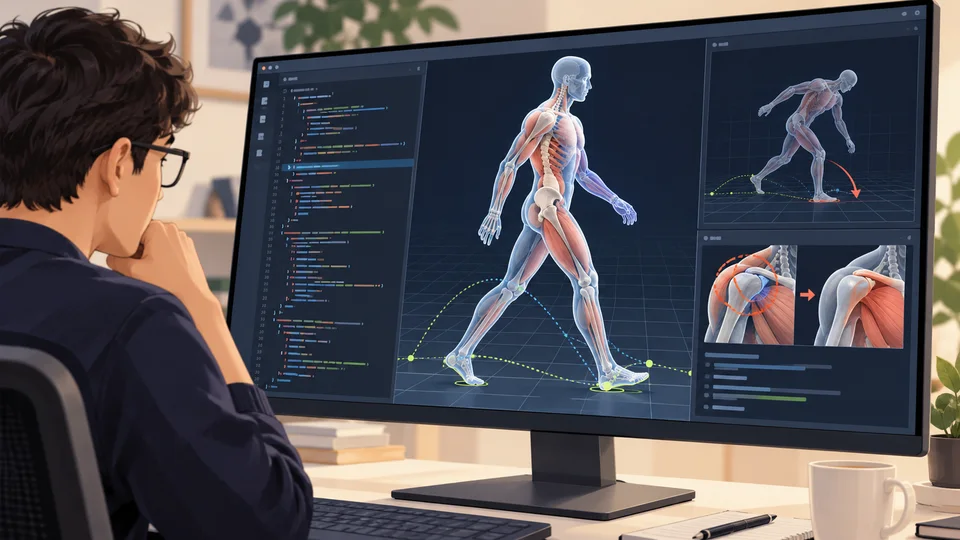
Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。

事件进展与其他报道

面板厂商集体涨价应对AI引发的上游成本挤压,但下游接受度低、终端品控承压

2026年9月起,TCL华星、京东方、惠科等面板厂商密集发布涨价函,主因AI大模型发展导致HBM需求激增,挤占成熟制程芯片产能,推高驱动IC、PCB、玻璃基板等关键物料价格;康宁等上游供应商同步提价。尽管成本端压力明确,但下游电视/显示器品牌采购价未普涨,终端用户投诉过热、黑点等品控问题频发,涨价尚未转化为实际成交与体验升级。

AI大模型狂飙,面板行业也扛不住了

推荐理由:材料系统揭示了AI产业对非直接关联硬件行业的跨链传导机制——非因AI拉动面板需求,而是通过晶圆产能再分配引发全链条成本重定价;同时呈现涨价行为与市场真实反馈(价格僵持、出货下滑、用户投诉)之间的显著落差,凸显产业议价权与产品力不匹配的深层矛盾。

事件进展与其他报道

llama.cpp 发布 b11870 版本,正式支持 DeepSeek-V4.1-Flash 模型

llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。

推荐理由:按信源设置仅收录,不参与自动精选

事件进展与其他报道

llama.cpp 发布 b11865 版本:新增 RDMA 接收边界检查,支持 CUDA 13.4、ROCm 10.0、Snapdragon NPU 等多平台后端

llama.cpp 项目发布构建版本 b11865,核心变更包括在 RDMA 接收逻辑中增加内存边界检查(PR #30399),并显著扩展硬件加速支持,覆盖 CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL 及高通 Snapdragon(CPU+Adreno+Hexagon)全栈异构计算后端;macOS KleidiAI 支持与 openEuler 构建被明确标记为 DISABLED。

推荐理由:按信源设置仅收录,不参与自动精选

事件进展与其他报道

Sebastian Raschka发布八视频课程《从零构建推理模型》

Sebastian Raschka于2026年10月24日在Ahead of AI杂志(magazine.sebastianraschka.com)发布一套共八讲、超11小时的Python与PyTorch实操视频课程,系统讲解推理模型的评估、推理时扩展、强化学习(RLVR)与知识蒸馏,基于预训练Qwen3-0.6B模型实现全部方法。

推荐理由:该课程是作者继《从零构建大语言模型》后推出的进阶技术教育内容,聚焦当前主流LLM的核心演进方向——推理能力增强,覆盖从基础环境搭建到GRPO强化学习、自蒸馏等完整技术链,且明确声明所有实现均‘从零手写’、可复现,具备强教学性与工程参考价值。

事件进展与其他报道

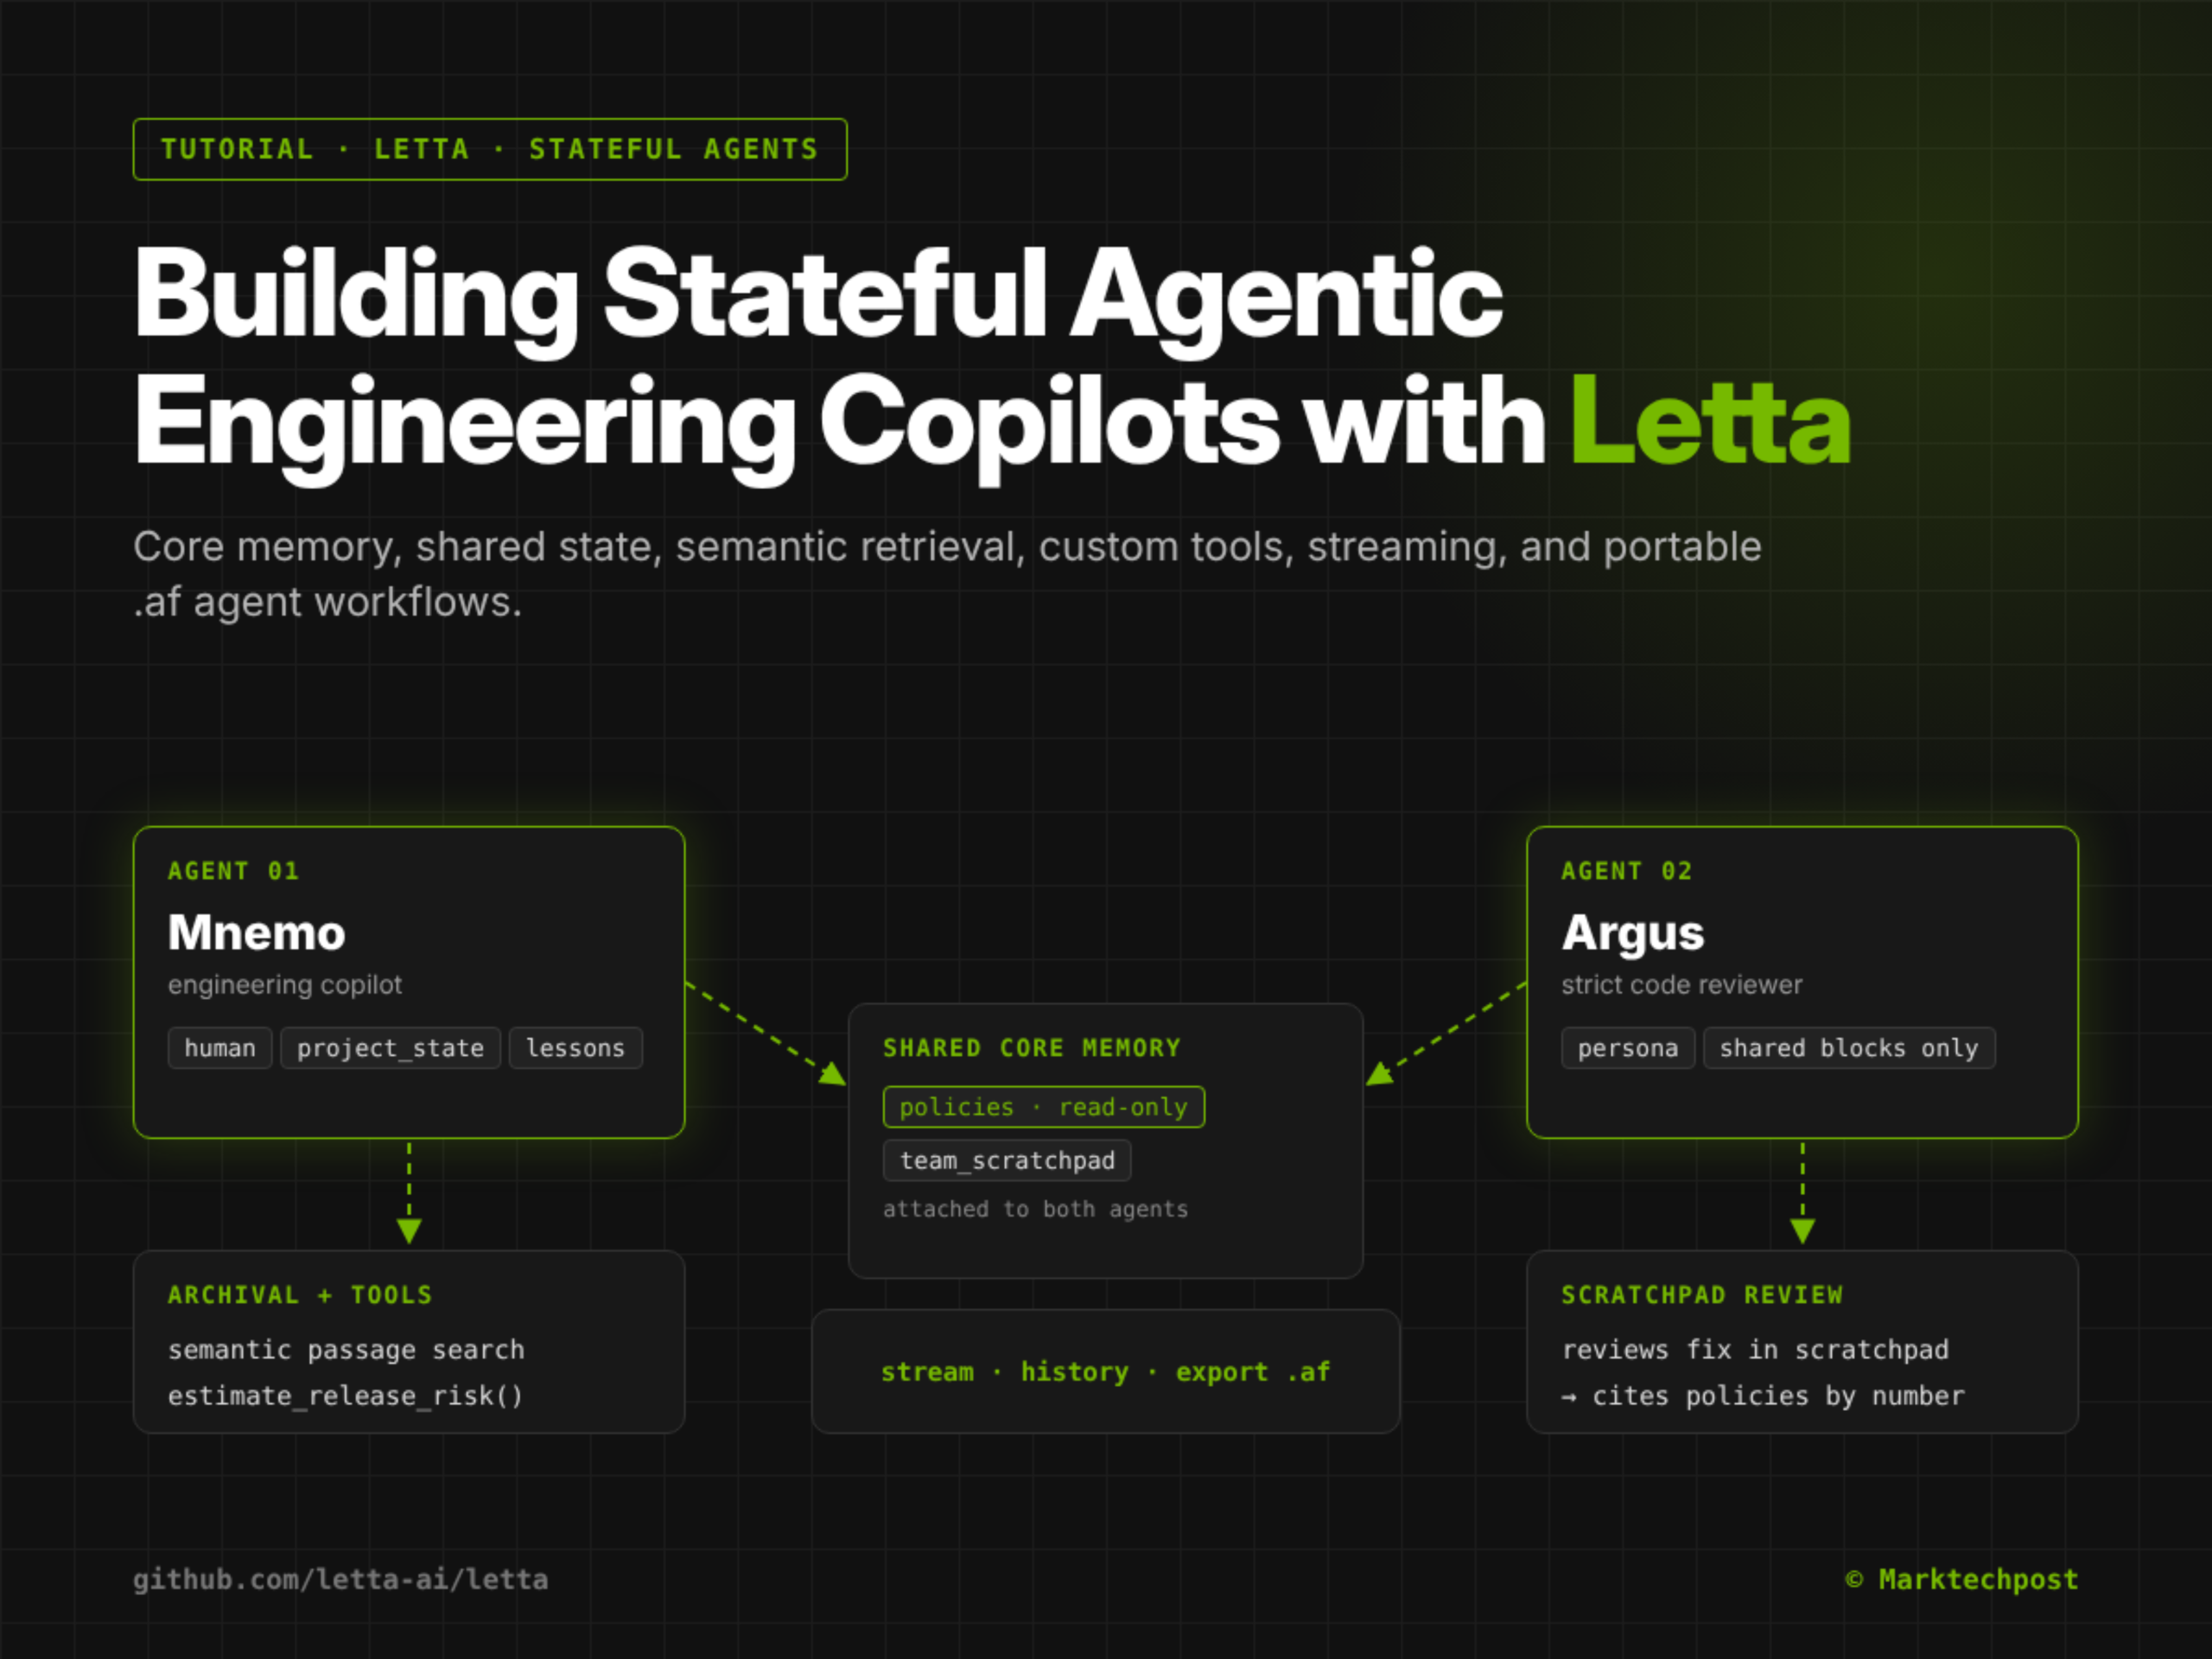
Letta平台发布有状态工程协作者构建教程:支持核心记忆、共享状态与可移植工作流

MarkTechPost于2026年10月24日发布教程,介绍如何基于Letta框架构建具备持久化状态的工程协作者(agentic copilot),涵盖可检查的核心记忆、多代理共享内存、语义检索归档知识、自定义Python工具集成、流式响应及.agent格式(.af)导出等能力;内容为技术实践指南,未提供性能指标、安全审计或生产环境验证。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
事件进展与其他报道

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed

推荐理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。

事件进展与其他报道

ULME框架实现文本嵌入与语言建模的真正统一:arXiv新论文提出预测耦合机制

2026年10月24日,arXiv发布论文arXiv:2610.30705v1,提出ULME——一种面向因果解码器型大语言模型的后训练框架,通过预测耦合(predictive coupling)机制,首次实现文本嵌入与语言生成能力的相互增强式统一。该方法在Qwen2.5/Qwen3系列(0.5B–8B参数)上验证有效,MTEB提升3.3–4.1分,同时保持生成任务(MMLU等)性能不降。

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

推荐理由:该论文直指当前多模态LLM能力割裂的核心问题:嵌入与生成长期由独立模型或仅参数共享的‘伪统一’模型承担。ULME通过可学习插槽与三目标联合训练(含stop-gradient预测损失),使生成过程主动塑造嵌入表征,属架构层面的实质性突破;实验覆盖广、基线强、指标全面,且发布于权威预印本平台,时效性与技术严谨性兼备。

事件进展与其他报道

LLM评测中聚合分数掩盖个体判决不稳定性:Arena-Hard新研究揭示指令敏感性

该研究使用500条Arena-Hard v2.0提示,固定两个模型的回答,以GPT-4.1为裁判,在8种指令组合下重复评测,发现即使聚合分数变化微小(如±1分),高达21.2%的单条提示判决结果(胜/平/负)发生改变;指令调整进一步放大不稳定性,最高导致28.2个百分点的额外判决变动,而聚合分数却可能几乎不变。

Behind Aggregate Scores: What Systematically Varying Arena-Hard's LLM Judge Reveals

推荐理由:研究直击当前LLM评估实践的核心盲区——过度依赖聚合分数而忽视个体判决的可复现性与指令依赖性,为偏好建模、人类反馈强化学习(RLHF)等依赖细粒度判决的任务提供关键方法论警示。

事件进展与其他报道

研究提出自评估强化学习框架SARL,提升检索增强大模型的搜索状态感知能力

2026年10月24日,arXiv发布论文arXiv:2610.30435v1,提出Self-Assessment Reinforcement Learning(SARL)框架,旨在解决现有检索增强大语言模型中搜索代理缺乏搜索状态感知能力的问题。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

推荐理由:该研究针对检索增强型大语言模型在复杂任务中因无法识别已获/缺失信息而导致幻觉推理和过早终止搜索的关键缺陷,提出无需测试时额外评估的端到端强化学习方案,并在多跳推理与深度研究基准上取得显著性能提升。

事件进展与其他报道

工具增强型语言模型的提示敏感性研究:工具提升准确率但加剧表述差异影响

一项发表于2026年10月24日arXiv平台的研究(编号2610.31148v1)指出,在工具增强条件下,六种开源语言模型在五类领域、五种问题表述下的对比稳定性未提高;相反,工具虽提升程序可答问题的准确率,却扩大了不同措辞下模型排名变化的敏感性。

Prompt Sensitivity in Tool-Augmented Model Comparisons

推荐理由:该研究采用新设计的匹配协议,解耦工具调用全流程中的关键环节(如调用决策、工具响应、无调用报告等),实证揭示‘准确率提升’不等于‘比较更稳定’,并指出接口设计与指令细节显著调节敏感性程度,对模型评估实践具直接指导价值。

事件进展与其他报道

RIFT提出动态KV缓存压缩策略缓解解码陈旧性问题,提升推测解码质量

2026年10月24日,arXiv发布论文arXiv:2610.31098v1,提出RIFT——一种面向推测解码中草稿模型(drafter)的动态KV缓存压缩方法,通过平衡预填充信息与新生成token,并结合可压缩性训练,在8K-token KV缓存预算下使Qwen3.5-4B草稿模型为Qwen3.5-122B执行长上下文生成时,保持超98%的全缓存接受长度。

RIFT: KV Cache Compression for Draft Models with Complementary Compressibility Training

推荐理由:该研究直面长输出生成中KV缓存膨胀导致的硬件成本与精度下降矛盾,首次明确定义并量化‘解码陈旧性’(decode staleness)现象,并提出可落地的刷新机制与训练协同方案;实验设定具体(32K输入/4K输出/8K缓存),结果具工程参考价值;来源为arXiv预印本,发布时间(2026-10-24)与系统当前日期(2026-10-25)一致,时效性强。

事件进展与其他报道

新研究揭示推理时上下文增强方法效果存疑:精度提升或为随机扰动

一篇于2026年10月24日发布在arXiv(编号2610.30983v1)的AI研究论文系统评估了五种推理时上下文增强方法,发现其报告的准确率提升未必反映真实能力增强,而可能是无方向性扰动所致——既修正部分预测,也破坏其他预测。

A Reality Check of Inference-Time Context Augmentation Methods

推荐理由:该论文首次构建跨方法、跨模型、跨数据集的统一评估框架,指出仅依赖性能增益易掩盖可靠性缺陷;尤其警示 filler-token 类方法(不引入新信息)主要扰动决策边界附近的预测,不宜直接用于实际部署。

事件进展与其他报道

Protegrity-PII:新型PII识别模型发布,支持结构化与非结构化文本

2026年10月24日,研究团队在arXiv(编号2610.30518v1)发布Protegrity-PII模型,一种面向个人身份信息(PII)识别的新型决策模型;其在新基准PII-SCOPE上实现0.915的类型化召回率与0.907的精确率,推理速度为0.49秒/百万字符,成本仅0.0005美元/百万字符(单RTX 6000,批处理)。

Protegrity-PII Technical Report

推荐理由:该技术报告提供了可量化的性能指标、明确的硬件与成本条件、新提出的基准PII-SCOPE,以及对分布外泛化能力的实证比较,具备科研透明性与工程参考价值;发布时间(2026-10-24)不晚于当前时间(2026-10-26),属有效近期成果。

事件进展与其他报道

研究提出将自回归大模型控制编译为策略精确的并行推理,提升分层RAG效率

一篇于2026年10月24日发布在arXiv(编号2610.30664v1)的研究论文提出新方法,将大语言模型在分层检索增强生成(Hierarchical RAG)中的自回归控制逻辑编译为策略精确(policy-exact)的并行推理流程,在MetaX设备上实现控制延迟降低35–47%,同时保持84–89%的策略一致性。

Compiling Autoregressive LLM Control into Policy-Exact Parallel Inference for Hierarchical RAG

推荐理由:该成果针对LLM作为结构化决策控制器时普遍依赖串行文本解码的瓶颈,提出理论可证的并行化编译方案;实验基于真实设备(MetaX、H800)和多数据划分验证,时效性强、技术细节明确,属前沿可信AI系统优化研究。

事件进展与其他报道

FusionEval发布:面向大语言模型融合的新基准测试

2026年10月24日,研究者在arXiv发布论文arXiv:2610.30162v1,提出FusionEval——首个专用于评估大语言模型融合方法的统一基准,覆盖推理链长度、工具调用等薄弱环节,并支持训练型与免训练型融合方法对比。

FusionEval: Benchmarking Model Fusion for Large Language Models

推荐理由:该基准填补了现有评测对长链推理与工具使用覆盖不足的空白,明确区分平均性能与最差能力保留,提供可复现的专家池(基于Qwen3/Llama)、多维指标(含GPU内存与运行时)及开源代码,具强实践指导性。

事件进展与其他报道

研究通过奇异值谱干预调控大语言模型能力分布:Llama与Qwen模型实证分析

一项发表于2026年10月24日arXiv(编号2610.30676v1)的AI研究,对五种开源Llama和Qwen指令微调模型实施后置奇异值谱平滑与尖峰扰动,发现该轻量干预可系统性重塑模型在事实知识、语言理解与演绎推理三类能力上的表现权衡。

Spectral Smoothing and Spiking Perturbations Reconfigure Capability Profiles and Selective Task Performance in Large Language Models

推荐理由:该论文首次在多模型、多任务框架下实证验证了变压器前馈层奇异值谱结构对下游能力的因果影响,揭示了能力配置的结构性敏感规律,为模型能力解耦与可控编辑提供了新路径;所有结论均基于公开模型与标准评测,方法透明、评估维度全面。

事件进展与其他报道