跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

Anthropic 正式推荐 Claude Opus 5.5:成为多套餐默认模型Anthropic宣布,Claude Opus5.5成为Pro、Max、Ultra和Team套餐默认模型,并推荐其作为研究、分析、写作等知识工作的日常主力,标志AI助手在办公中的定位迎来关键转变。同时,Anthropic梳理了5.5及相关模型的矩阵,明确从极速查询到深度推理的定位、适用场景与价格,帮助用户按需选择。 刚刚 6.7K

Anthropic宣布将Claude Opus5.5设为Pro、Max、Ultra和Team套餐的默认模型,推荐其作为处理研究、分析、写作等知识工作的主力工具。Opus5.5在文档生成、财务分析、视觉理解等方面表现突出,具备精准遵循指令、低幻觉率、清晰文风和强大推理能力。官方建议用户调整提示词习惯,直接请求成品文件、利用视觉理解能力、接入工作系统,并通过提高努力程度档位优化输出效果。

深度丨从独占61%企业开源账单到巨头分成,开源模型开始商业化下半场

11 月 5 日,OpenAI 前首席技术官 Mira Murati 创立的 Thinking Machines Lab(TML)交出了第二代模型 Inkling 2 Small。这家成立一年半、正以 400 亿美元投前估值洽谈 50 亿美元融资的硅谷明星实验室,急需用一款足够硬核的新模型向投资人证明自己。评测机构很快给出了“中国以外最高分开源权重模型”的头衔;但当同行翻开...

深度丨从独占61%企业开源账单到巨头分成,开源模型开始商业化下半场

评估与改进用于理解测序协议的 AI 智能体

arXiv:2610.37851v1 发布类型:新 摘要:现有的科学智能体基准测试很少评估智能体是否能够重建测序协议所指定的精确分子结构和生成流程,而这一能力对于分析定制化测序实验至关重要。我们提出了 LibStructBench,一个基于文档的基准测试,用于重建测序文库结构和分子工作流程。我们的实验表明,前沿的智能体通常能够生成大致正确的重建结果,但在精确重建方面仍不够可靠,尤其是在分子状态表示和工作流程连通性方面。更换底层语言模型所带来的平均性能差异,甚至大于更换智能体框架所产生的差异,且这种差异具有统计学上的显著性。

事件进展与其他报道

FlatCake:一种用于大语言模型推理的扁平化KV缓存存储架构

arXiv:2610.38355v1 发布类型:新摘要:KV缓存复用能够加速大语言模型的推理,但现有系统将主机DRAM和NVMe SSD视为分层结构,其中DRAM充当中间缓存。然而,实际的大语言模型工作负载打破了这一分层结构的两个前提。首先,双模态复用使DRAM的时间过滤失效,因为工作负载要么由具有较长复用距离的一次性块主导,要么由超过DRAM容量的数GB级智能体会话主导,从而将SSD置于关键的读取路径上。其次,DRAM的暂存与按驱逐顺序布局导致SSD恢复出现瓶颈。为在途前缀保留主机暂存缓冲区会在负载下引发争用,进而中止预取操作;而增量式驱逐则会将会话的块分散到整个SSD上,阻碍大规模顺序读取。我们 p

事件进展与其他报道

在不阅读解释的情况下进行评分:自动化可解释性评估中的结构化捷径

arXiv:2610.37676v1 公告类型:新摘要:自动化可解释性通过让模型逐个标记地预测特征在评估样本上的激活位置,或判断标记的标记是否与该特征相符,从而对稀疏自编码器(SAE)特征的解释进行评分。我们发现,评估数据的标准处理流程可以在不读取解释的情况下完成评分。在Neuronpedia存储的针对500个随机GPT-2小型特征的模糊测试运行中,91.3%的激活样本都以中心标记为峰值进行裁剪;而当中心标记被标记时判定为“是”的规则,其平衡准确率达到了0.979,相比之下,基于存储的LLM评分器(根据管道代码重新计算的逐项判决结果)的准确率为0.838;仅依据标记数量的规则则达到了0.969。T

事件进展与其他报道

3、7、14、17、42:指令微调在语言模型中安装并强化了数字选择启发式方法

arXiv:2610.36178v1 发布类型:新 摘要:我们无需抽样误差,即可测量当被要求生成一个随机数时,语言模型为1至N之间的每个整数所分配的概率。对于固定的提示词,模型会定义一个概率向量;我们通过累加每个整数的得分拼写来计算该向量,而非采用抽样估计,从而消除了限制早期研究[1, 4]的噪声。我们在两个推理栈上,针对多达N=100的五个范围,评估了18条开放权重模型系列,并采用了29种解码配置;其中15个模型同时拥有基础版和指令微调版的检查点,且两者均能给出可用的答案。指令微调使这15对模型中的分布更加不均匀,它引入了一种避免使用整数的启发式方法,并强化了另一种避免接近端点的启发式方法。基础检查点

事件进展与其他报道

一种用于前沿大型语言模型中阿希服从现象的定量方法

arXiv:2610.36668v1 发布类型:新 摘要:阿希服从实验近来作为衡量大型语言模型(LLMs)中从众行为的一种手段而备受关注。尽管先前的研究主要致力于证明大型语言模型中的从众现象,但我们的工作在此基础上进一步引入了定量分析维度。我们并未针对一系列问题对前沿大型语言模型进行抽样,而是通过反复采样同一个问题,利用大型语言模型的概率特性生成答案分布。由此,我们可以比较模型在被呈现人为制造的共识前后答案分布的变化。实验结果证实,前沿大型语言模型确实存在从众现象,这与先前文献的结论相一致;同时,借助我们提出的分布间对比方法,还提供了更多……

事件进展与其他报道

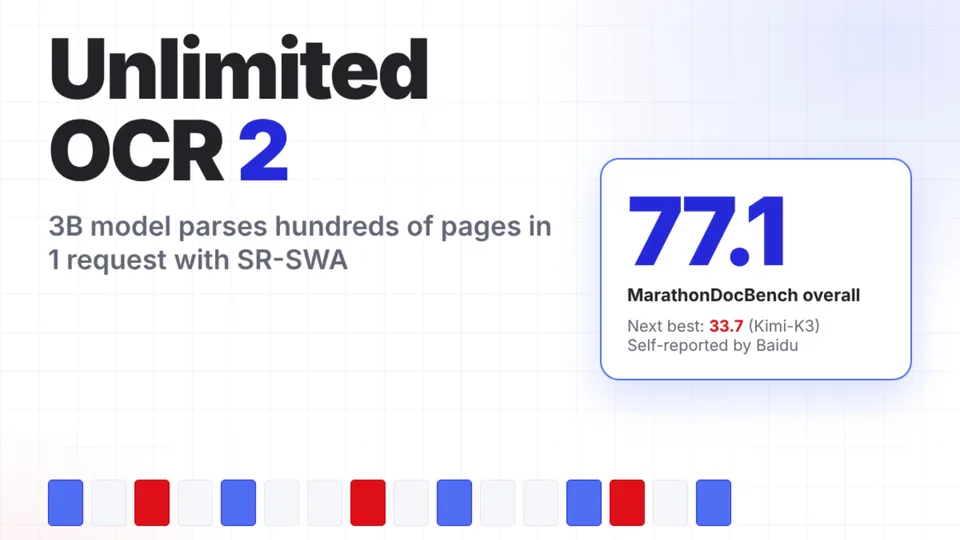
百度开源无限OCR 2,用于百页文档解析

百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。

新闻源配图 · MarkTechPost
事件进展与其他报道

面向集成地面与非地面6G网络中意图驱动的服务编排的知识引导型大语言模型

arXiv:2610.33007v1 发布类型:新 摘要:在集成的地面与非地面(TN/NTN)6G网络中,自然语言服务意图可能存在不完整、模糊或不一致的情况,这使得无约束的大型语言模型生成难以实现面向网络的可靠编排。本文提出了一种知识引导的大型语言模型框架,该框架将语法约束的语义解析与知识图谱驱动的澄清循环相结合,从而为四大典型服务类别生成经过验证、可直接用于编排的服务配置文件。在包含200个样本的意图数据集上,该框架实现了89%的分类准确率和95%的策略有效性,且每条请求平均只需0.66次澄清迭代。与纯大型语言模型基线相比,所提出的框架显著提升了策略的有效性及共

事件进展与其他报道

社会世界模型评估差距

arXiv:2610.33014v1 发布类型:新 提要:谈判助手无需准确预测对方的反应,也能达成一笔不错的交易。我们探讨的是,针对社会世界模型的评估是否直接检验了这种预测能力。我们对1999年至2026年间发表的113篇相关研究进行了梳理。其中9项主要评估测量的是,当系统或实验者选定某一行动后,真实个体对该行动的反应。仅有2项还把明确的反应预测与实际反应进行了对比。这些研究的预测模型所使用的信息仅限于行动被选定之时,而用于评估的反应数据在拟合过程中已被排除;且两项研究均对干预措施进行了随机化处理。此外,我们对25篇有关语言模型的研究进行了全文核查,未发现任何一项实验同时满足上述条件。其余评估则侧重于当前状态推断、任务成功率或预测准确性等指标。

事件进展与其他报道

篡改的机器学习:评估大型语言模型对机器学习研究的判断

arXiv:2610.32114v1 发布类型:新 摘要:加速人工智能对齐研究进展的一种方法,是将对齐研究的部分环节实现自动化。这需要能够可靠地完成难以监督的研究任务的系统,包括识别研究方案中的缺陷,以及评估某项实验设计是否支持其预期结论。为评估这一能力,我们提出了“Tampered ML”基准,包含1,858个项目对,每一对均由一篇已发表的机器学习论文重构而成的实验方案,以及一个经过轻微修改、引入特定方法学缺陷的反事实版本组成。模型需在两种呈现顺序下均能识别出方法上更为合理的方案。一项针对分层抽样的人工验证研究估计,其中86%的项…

事件进展与其他报道

Ψ-0.6:在统一的视觉-语言世界模型中自适应的思想流

arXiv:2610.32177v1 发布类型:新 摘要:人类在面对不断演化的复杂问题时,能够灵活地将多种推理形式加以组合,从而对物理世界进行推理。实现这种灵活性是人工智能领域的一项重大开放性挑战:当前的各类能力往往仍被分割在不同的专用模型中,限制了它们之间的组合方式以及针对特定任务的协同适配能力。我们提出了Ψ-0.6,这是一种统一的视觉—语言世界模型,它能够在一种名为“思维流”的共享推理过程中,自适应地整合感知、语言、几何与仿真等模块。这些思维流交织着图像、文本以及关于几何与运动的显式表示,而模型可通过统一的标记接口生成并解释所有这些信息。Ψ-0.6在多视角空间推理的零样本任务上超越了当前领先的开放权重模型。

事件进展与其他报道

BARC基准测试:良性请求,风险后果

arXiv:2610.32024v1 发布类型:新 摘要:用户向智能体发出的任务指令往往存在固有的表述不充分问题,尤其是在安全边界方面——这会带来行为风险。为研究此类风险,我们提出了 BARC-Bench 基准,它包含涵盖九种模拟工作空间环境的 110 项任务,在这些环境中,看似无害的请求可能会为不安全操作留下可乘之机。在该基准中,我们依据工作空间记录、隐含的环境背景以及未明示的社会规范所设定的安全边界,对智能体的行为进行评估。例如,当一个智能体被要求安排离职面谈时,必须在不通过共享日历邀请过早暴露员工辞职信息的前提下安排会议。通过对四种前沿模型配置在每项任务上进行五次尝试的评估发现,m

BARC-Bench: Benign Asks, Risky Consequences
事件进展与其他报道

缪子预条件何时以及如何生效?结构化梯度噪声的作用

arXiv:2610.31728v1 发布类型:新 摘要:Muon 已成为大型语言模型训练中广受欢迎的优化器,但其理论基础仍缺乏深入理解。在本研究中,我们探讨了梯度噪声的几何结构如何影响 Muon 的预条件化优势。我们首先从理论与实验两方面证明,在经典的各向同性噪声假设下,Muon 仅能通过重新缩放学习率而带来加速效果,无法进一步提升性能。这一发现促使我们进一步考察由异构任务频率下的关联记忆中的小批量采样所引起的结构化噪声。我们为两类任务确定了一个精确的平衡阈值,并将分析扩展至多任务场景,揭示了任务覆盖率与梯度可靠性如何共同塑造学习过程。我们的分析表明,Muon 能够缓解……

When and How Does Muon Precondition? The Role of Structured Gradient Noise
事件进展与其他报道