
豆包工作接入DeepSeek、Kimi等多款模型;黄仁勋被曝另一段婚外情,英伟达正讨论罢免案 | AI圈又发生什么了
1.豆包工作接入Kimi、GLM等多款模型,推出限时优惠 今日,豆包工作接入了Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash等多款模型,用户可以根据不同工....
检索标题、摘要与正文,把分散的信息连起来。
1.豆包工作接入Kimi、GLM等多款模型,推出限时优惠 今日,豆包工作接入了Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash等多款模型,用户可以根据不同工....
程浅 发自 凹非寺 量子位 | 公众号 QbitAI 最近AI找Bug这事儿有点太割裂了。 这一边,AI一朝出手倒查所有,先挖出了个PHP底层重大安全漏洞,又扒出948....

作者|周一笑(微信smiletalker)编辑|王兆洋(Geisterspiele)Gemini 4 Carbon 深夜正式开放,第一时间实测之后,我不禁发出感慨:它最好的上线时间其实是两周前。因为差了这么几天,它就被 Fable 5.2 抢走了各种 Benchmark 第一。然后我就发现,这个感慨本身,其实最能说明它在今天模型竞争里的位置,以及这个模型对Goo...
arXiv:2611.12950v1 公告类型:新 题要:黑盒大模型指纹识别旨在仅通过观察对输入查询的输出响应,判断目标模型是否源自某个源模型。揭示这种关联的一种方法是扰动每个查询,并观察两个模型产生的相应响应,从而得到两组对应的响应变化。这两组数据提供了两种互补的信息来源:每组内部响应变化之间的关系,以及两组之间响应变化的对应关系。然而,现有方法并未充分挖掘这两方面的信息。我们提出了 \textbf{SetPrint},一种无需训练的方法,能够同时捕捉组内关系和组间对应。SetPrint 将每个响应变化相对于其所在组的平均变化进行表示,然后比较由相同扰动引发的两个模型的变化。在 LeaFBench 上,SetPrint 的性能始终优于现有的无训练黑盒指纹识别方法。进一步分析表明,这些优势源于组内关系和组间对应两方面。
蒸完人类上下几千年的数据之后,大模型开始 “蒸人”。文丨高洪浩 陈佳惠编辑丨高洪浩 黄俊杰成都中和与天津侯台都是城郊结合处的老村镇。一群人在这里为大型互联网公司训练大模型,大多月薪不足 1 万元。他们每天从阅读大模型生成的答案开始:核对事实,检查有没有答非所问,打分、比较优劣,有时还要亲手写一份示范。做完一条,再看下一条。模型要学的任务,从财务分析、修改程序,扩展到生物制药、芯片设计,人也得为这些任务准备示范和评分标准。这些重复、琐碎的工作,构成了今天大模型训练中最重要的一环——数据生产。“这家公司最大的创新就是数据。” 一位负责数据评测的人士这样评价 Anthropic。2025 年,当网上...
MiniMax 创始人闫俊杰的这期新播客,非常不错。有不少增量信息,能帮我理解国内大模型的发展态势,以及 MiniMax 的思路。 如果没记错的话,这也是近半年来,国内几家头部大模型创业公....

国行 Apple 智能开始测试:iOS 27.3 首个开发者 Beta 版已推送11 月 4 日,苹果向开发者推送 iOS 27.3 首个 Beta 版,国行 iPhone 用户开始测试首批 Apple 智能功能,包括实时翻译、照片消除、写作工具和通知摘要等。国行 Apple 智能与阿里巴巴达成合作,在部分体验中接入千问。国内用户可直接在 Siri、写作工具和视觉智能...

AI应用风向标(公众号:ZhidxcomAI)作者|毕伟豪 编辑|漠影每逢崩溃,必有更新。智东西11月4日报道,昨天,DeepSeek Harness悄悄更新了GitHub仓库,推出了一个v0.2.2-alpha.3预发布版本。这次更新围绕代码审查、自动化任务管理、SDK和插件生态等方面进行了扩展。有趣的是,就在昨天DeepSeek出现了网页及API服务部分中断的...

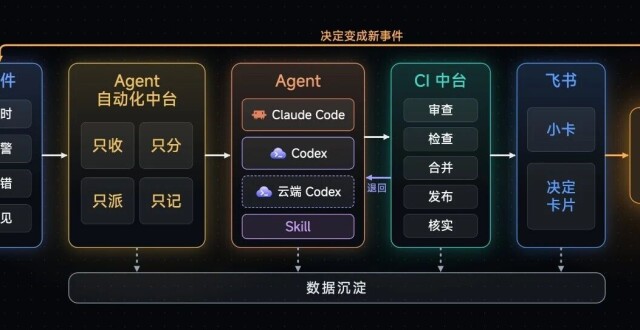
上周六的时候,DeepSeek发了他们一篇很长的技术文章,叫《Super-agent设计探索:迈向更自主的Agent系统》,细细读完了,非常棒的架构,对很多开发者来说,都非常非常值得学习。 ....
arXiv:2610.37905v1 发布类型:新 摘要:诸如美国证券交易委员会EDGAR等公开披露数据库通过网络访问企业申报文件,为知情投资提供支持。借助语言模型智能体对这些文件进行审查时,需要发现相关文档中未明示的缺陷、获取缺失的企业信息,并验证所请求的修订是否符合有据可依的要求。然而,现有的金融问答评测难以充分反映此类交互能力。我们提出了\textbf{FilingLoop},一个用于企业披露审查与修订的交互式基准测试及自进化智能体框架。FilingLoop以美国证券交易委员会的历史往来函件为基础,从96家公司的文件中重构出380项以首次公开募股审查为主的任务。
arXiv:2610.38355v1 发布类型:新摘要:KV缓存复用能够加速大语言模型的推理,但现有系统将主机DRAM和NVMe SSD视为分层结构,其中DRAM充当中间缓存。然而,实际的大语言模型工作负载打破了这一分层结构的两个前提。首先,双模态复用使DRAM的时间过滤失效,因为工作负载要么由具有较长复用距离的一次性块主导,要么由超过DRAM容量的数GB级智能体会话主导,从而将SSD置于关键的读取路径上。其次,DRAM的暂存与按驱逐顺序布局导致SSD恢复出现瓶颈。为在途前缀保留主机暂存缓冲区会在负载下引发争用,进而中止预取操作;而增量式驱逐则会将会话的块分散到整个SSD上,阻碍大规模顺序读取。我们 p
现在,您可以在 Google Gemini 内部直接生成、预览并编辑 PDF、Google 文档、Google 表格、幻灯片演示文稿、Markdown 文件、TXT 文件以及代码。全新的文件编辑功能自今日起面向所有 Gemini 用户开放;其中,PDF 的预览与编辑功能同时支持网页端和移动端,而其他所有文件格式目前仅限于网页端使用。

文丨苏扬 编辑丨徐青阳 Android正在为AI智能体打开更多入口。 美国当地时间10月28日,谷歌举行Android Dev Summit 2026开发者峰会,发布了....
1.谷歌造出“可改写的世界”:Genie 4能实时改剧情、生成声音 以后,AI生成的可能不只是一段视频,而是一个你能亲自走进去、随时改写的世界。10月27日,谷歌DeepMind发布世界模....

DeepSeek、Google和NVIDIA构建智能体技术栈
arXiv:2610.36668v1 发布类型:新 摘要:阿希服从实验近来作为衡量大型语言模型(LLMs)中从众行为的一种手段而备受关注。尽管先前的研究主要致力于证明大型语言模型中的从众现象,但我们的工作在此基础上进一步引入了定量分析维度。我们并未针对一系列问题对前沿大型语言模型进行抽样,而是通过反复采样同一个问题,利用大型语言模型的概率特性生成答案分布。由此,我们可以比较模型在被呈现人为制造的共识前后答案分布的变化。实验结果证实,前沿大型语言模型确实存在从众现象,这与先前文献的结论相一致;同时,借助我们提出的分布间对比方法,还提供了更多……
AI排行榜上的冠军会换,用户每天使用的产品却未必换。大模型的下一场竞争,不仅仅是谁的模型更强,而是把一次使用变成习惯。
arXiv:2610.32429v1 发布类型:新 摘要:大型语言模型(LLM)代理正越来越多地以异步方式执行任务:主代理在子代理运行的同时继续工作,而任务状态可能在其结果到达之前就已发生变化。主代理必须决定哪些工作需要更新或保留、哪些检查需要重复,同时避免进行被禁止的修改。仅凭最终任务的成功并不能说明这些结果是否被正确处理,而且自然的异步到达现象也难以复现。我们提出了 Async-RBench,一个用于评估 LLM 代理中异步任务执行的基准测试,包含涵盖八种场景的 200 个可执行任务。场景控制器通过预定义的任务状态条件来调控结果的交付,而事件响应契约(ERC)则规定了每种响应应满足的要求
arXiv:2610.32308v1 发布类型:新 摘要:多步逆合成反应需要通过一系列连续的反应步骤,将目标分子逐步转化为可购买的构建模块;近期的研究开始借助大型语言模型(LLM)的推理能力来解决这一任务。在最新进展中,LLM推理已进入长时序阶段:模型能够在相互依赖的各步之间持续追求目标、与环境交互并根据反馈进行调整。这一转变显著提升了LLM的能力,人工智能驱动的数学研究领域也由此取得了突破性进展。在此前沿领域,我们提出了 Solvent,一款拥有80亿参数的LLM,成功将长时序推理扩展至多步逆合成。通过两轮的后训练课程,Solvent学会了在迭代过程中穿插……
arXiv:2610.32305v1 发布类型:新 摘要:多阶段分析任务要求大型语言模型(LLM)代理利用中间证据来决定是继续、重定向还是停止。自我反思——即代理对其输出进行批判性评估——已得到广泛研究,然而这种反思并不能说明证据是否改变了下一步行动。我们将这一能力称为“自我约束”。现有的代理基准测试大多仅衡量任务完成度或输出质量,而未对这一能力进行检验。DMAIC-Bench 通过围绕精益六西格玛明确的统计前提条件构建的、涵盖四个行业领域中15个工业案例的97个种子任务,对此进行了评估。成对的反事实变体在相同的工作流位置上要求采取相反的操作,从而能够区分有依据的自我约束与无差别的停止行为。我们采用……对执行轨迹进行评估。