
修复评估偏差,以在 Amazon Bedrock 上解锁更优的模型
Property Finder 发现,其视觉AI评估标签中有96.8%源自现有模型,这掩盖了该模型的真实准确率。了解他们如何构建无偏的真值数据、实施进化式提示优化,并在 Amazon Bedrock 上选择了一款更精准且更具成本效益的模型,从而在11项图像质量指标上将成本降低了86%。
检索标题、摘要与正文,把分散的信息连起来。
Property Finder 发现,其视觉AI评估标签中有96.8%源自现有模型,这掩盖了该模型的真实准确率。了解他们如何构建无偏的真值数据、实施进化式提示优化,并在 Amazon Bedrock 上选择了一款更精准且更具成本效益的模型,从而在11项图像质量指标上将成本降低了86%。
更快地生成令牌,首先要明确哪些因素限制了推理性能。在 NVIDIA 上对 Inclusion AI 的 Ling-3.0-flash 进行的单批次评估中……
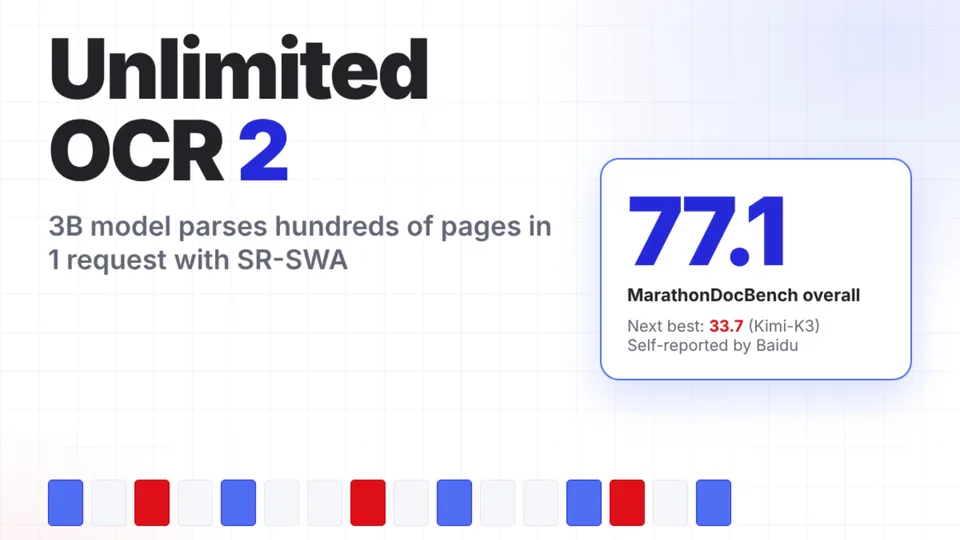
百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。
arXiv:2610.31945v1 发布类型:新 摘要:本报告介绍了 Kolibri,一种英德混合的专家级 Transformer 模型,总参数量为 781 亿,每个 token 的活跃参数量为 34.6 亿,并以 Apache 2.0 许可证公开了模型权重。我们构建 Kolibri 的目标是实现主权化与专业化部署,尤其聚焦于德语以及公共管理、工业和航空航天等受监管领域。为支持这些应用场景,我们全程把控模型研发流程,涵盖数据、架构、训练基础设施、后训练阶段及评估环节。我们在预训练、中期训练和长上下文扩展三个阶段累计使用了 24T tokens 进行训练,其中德语数据在字节层面占比超过 20%。为达成这一比例,我们还对德语数据集进行了补充……