
硅谷的AI创始人们,联手点名29家“潜力股”
最近,硅谷创投圈发了一份蛮有意思的榜单:让一些已经做出成功公司的 AI 创始人,推荐他们看好的下一批创业者。 像 Fireworks、Vercel 以及 Mercor 这些明星公司的 CE....

检索标题、摘要与正文,把分散的信息连起来。
最近,硅谷创投圈发了一份蛮有意思的榜单:让一些已经做出成功公司的 AI 创始人,推荐他们看好的下一批创业者。 像 Fireworks、Vercel 以及 Mercor 这些明星公司的 CE....
arXiv:2610.37851v1 发布类型:新 摘要:现有的科学智能体基准测试很少评估智能体是否能够重建测序协议所指定的精确分子结构和生成流程,而这一能力对于分析定制化测序实验至关重要。我们提出了 LibStructBench,一个基于文档的基准测试,用于重建测序文库结构和分子工作流程。我们的实验表明,前沿的智能体通常能够生成大致正确的重建结果,但在精确重建方面仍不够可靠,尤其是在分子状态表示和工作流程连通性方面。更换底层语言模型所带来的平均性能差异,甚至大于更换智能体框架所产生的差异,且这种差异具有统计学上的显著性。
arXiv:2610.37676v1 公告类型:新摘要:自动化可解释性通过让模型逐个标记地预测特征在评估样本上的激活位置,或判断标记的标记是否与该特征相符,从而对稀疏自编码器(SAE)特征的解释进行评分。我们发现,评估数据的标准处理流程可以在不读取解释的情况下完成评分。在Neuronpedia存储的针对500个随机GPT-2小型特征的模糊测试运行中,91.3%的激活样本都以中心标记为峰值进行裁剪;而当中心标记被标记时判定为“是”的规则,其平衡准确率达到了0.979,相比之下,基于存储的LLM评分器(根据管道代码重新计算的逐项判决结果)的准确率为0.838;仅依据标记数量的规则则达到了0.969。T
Property Finder 发现,其视觉AI评估标签中有96.8%源自现有模型,这掩盖了该模型的真实准确率。了解他们如何构建无偏的真值数据、实施进化式提示优化,并在 Amazon Bedrock 上选择了一款更精准且更具成本效益的模型,从而在11项图像质量指标上将成本降低了86%。
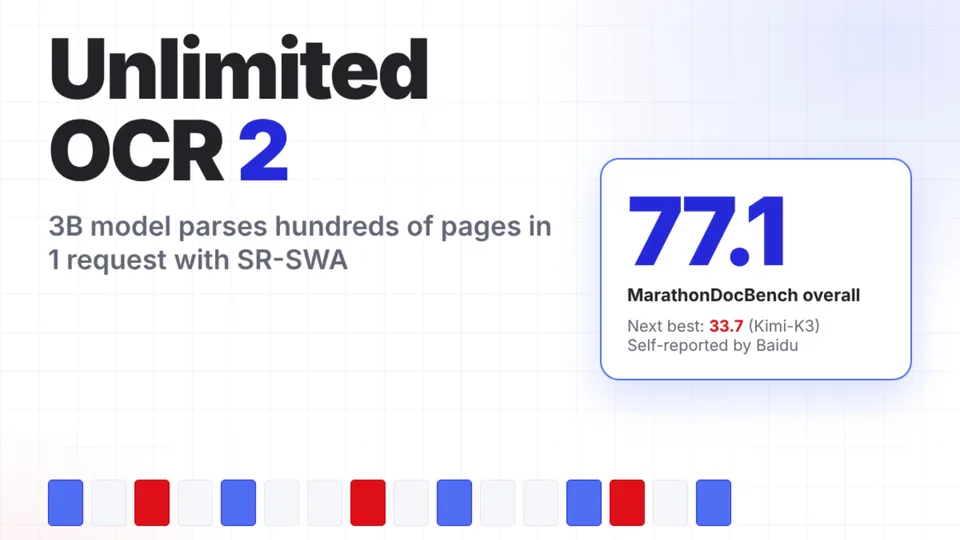
百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。
arXiv:2610.33014v1 发布类型:新 提要:谈判助手无需准确预测对方的反应,也能达成一笔不错的交易。我们探讨的是,针对社会世界模型的评估是否直接检验了这种预测能力。我们对1999年至2026年间发表的113篇相关研究进行了梳理。其中9项主要评估测量的是,当系统或实验者选定某一行动后,真实个体对该行动的反应。仅有2项还把明确的反应预测与实际反应进行了对比。这些研究的预测模型所使用的信息仅限于行动被选定之时,而用于评估的反应数据在拟合过程中已被排除;且两项研究均对干预措施进行了随机化处理。此外,我们对25篇有关语言模型的研究进行了全文核查,未发现任何一项实验同时满足上述条件。其余评估则侧重于当前状态推断、任务成功率或预测准确性等指标。
Data Culture 构建了一个三步评估框架,使某项 AI 分析的部署准确率从 0% 提升至 94.7%。
arXiv:2610.32114v1 发布类型:新 摘要:加速人工智能对齐研究进展的一种方法,是将对齐研究的部分环节实现自动化。这需要能够可靠地完成难以监督的研究任务的系统,包括识别研究方案中的缺陷,以及评估某项实验设计是否支持其预期结论。为评估这一能力,我们提出了“Tampered ML”基准,包含1,858个项目对,每一对均由一篇已发表的机器学习论文重构而成的实验方案,以及一个经过轻微修改、引入特定方法学缺陷的反事实版本组成。模型需在两种呈现顺序下均能识别出方法上更为合理的方案。一项针对分层抽样的人工验证研究估计,其中86%的项…
arXiv:2610.32024v1 发布类型:新 摘要:用户向智能体发出的任务指令往往存在固有的表述不充分问题,尤其是在安全边界方面——这会带来行为风险。为研究此类风险,我们提出了 BARC-Bench 基准,它包含涵盖九种模拟工作空间环境的 110 项任务,在这些环境中,看似无害的请求可能会为不安全操作留下可乘之机。在该基准中,我们依据工作空间记录、隐含的环境背景以及未明示的社会规范所设定的安全边界,对智能体的行为进行评估。例如,当一个智能体被要求安排离职面谈时,必须在不通过共享日历邀请过早暴露员工辞职信息的前提下安排会议。通过对四种前沿模型配置在每项任务上进行五次尝试的评估发现,m
