
在 NVIDIA DGX Spark 上提升 MoE 推理的三种方法
更快地生成令牌,首先要明确哪些因素限制了推理性能。在 NVIDIA 上对 Inclusion AI 的 Ling-3.0-flash 进行的单批次评估中……
保留完整资讯流,用来源、主题和时间找到你关心的消息。
更快地生成令牌,首先要明确哪些因素限制了推理性能。在 NVIDIA 上对 Inclusion AI 的 Ling-3.0-flash 进行的单批次评估中……
Mirendil 发布了 Fern 0.1,这是其首款模型,从零开始预训练,拥有 1000 万标记的上下文窗口。该模型面向智能体 AI 研发工作,在 1000 万标记的 RULER 单针测试中取得了 100% 的得分,但在智能体驱动的代码生成方面仍落后于前沿模型。文章《Mirendil 推出 Fern 0.1,首款拥有 1000 万标记上下文的模型》首发于 MarkTechPost。
旧榜跑分逼近满分,新榜实战却集体不及格。当大模型评测本身变成生意,企业选型正从看排名转向算成本账。
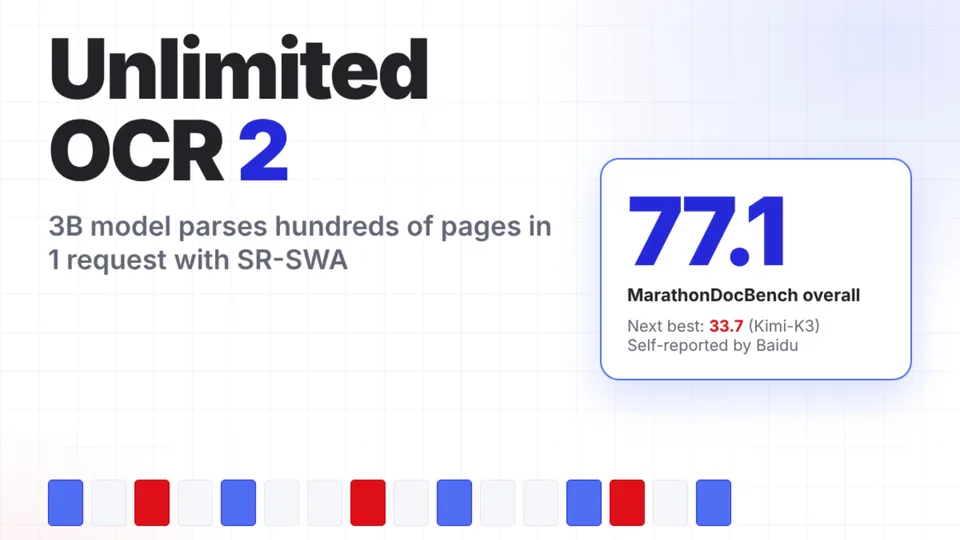
百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。
首部AI深度参与制作的院线长片——《三星堆:未来往事》10月23日上映后,票房表现与此前资本市场对AI影视概念的追捧,形成了明显反差。猫眼专业版数据显示,截至10月26日午间,这部100分钟的电影累计综合票房119.2万元,当日排片8469场,上座率0.1%,场均人次仅0.1人。10月24日、25日,该片场均人次均为2人。灯塔专业版数据...
Data Culture 构建了一个三步评估框架,使某项 AI 分析的部署准确率从 0% 提升至 94.7%。
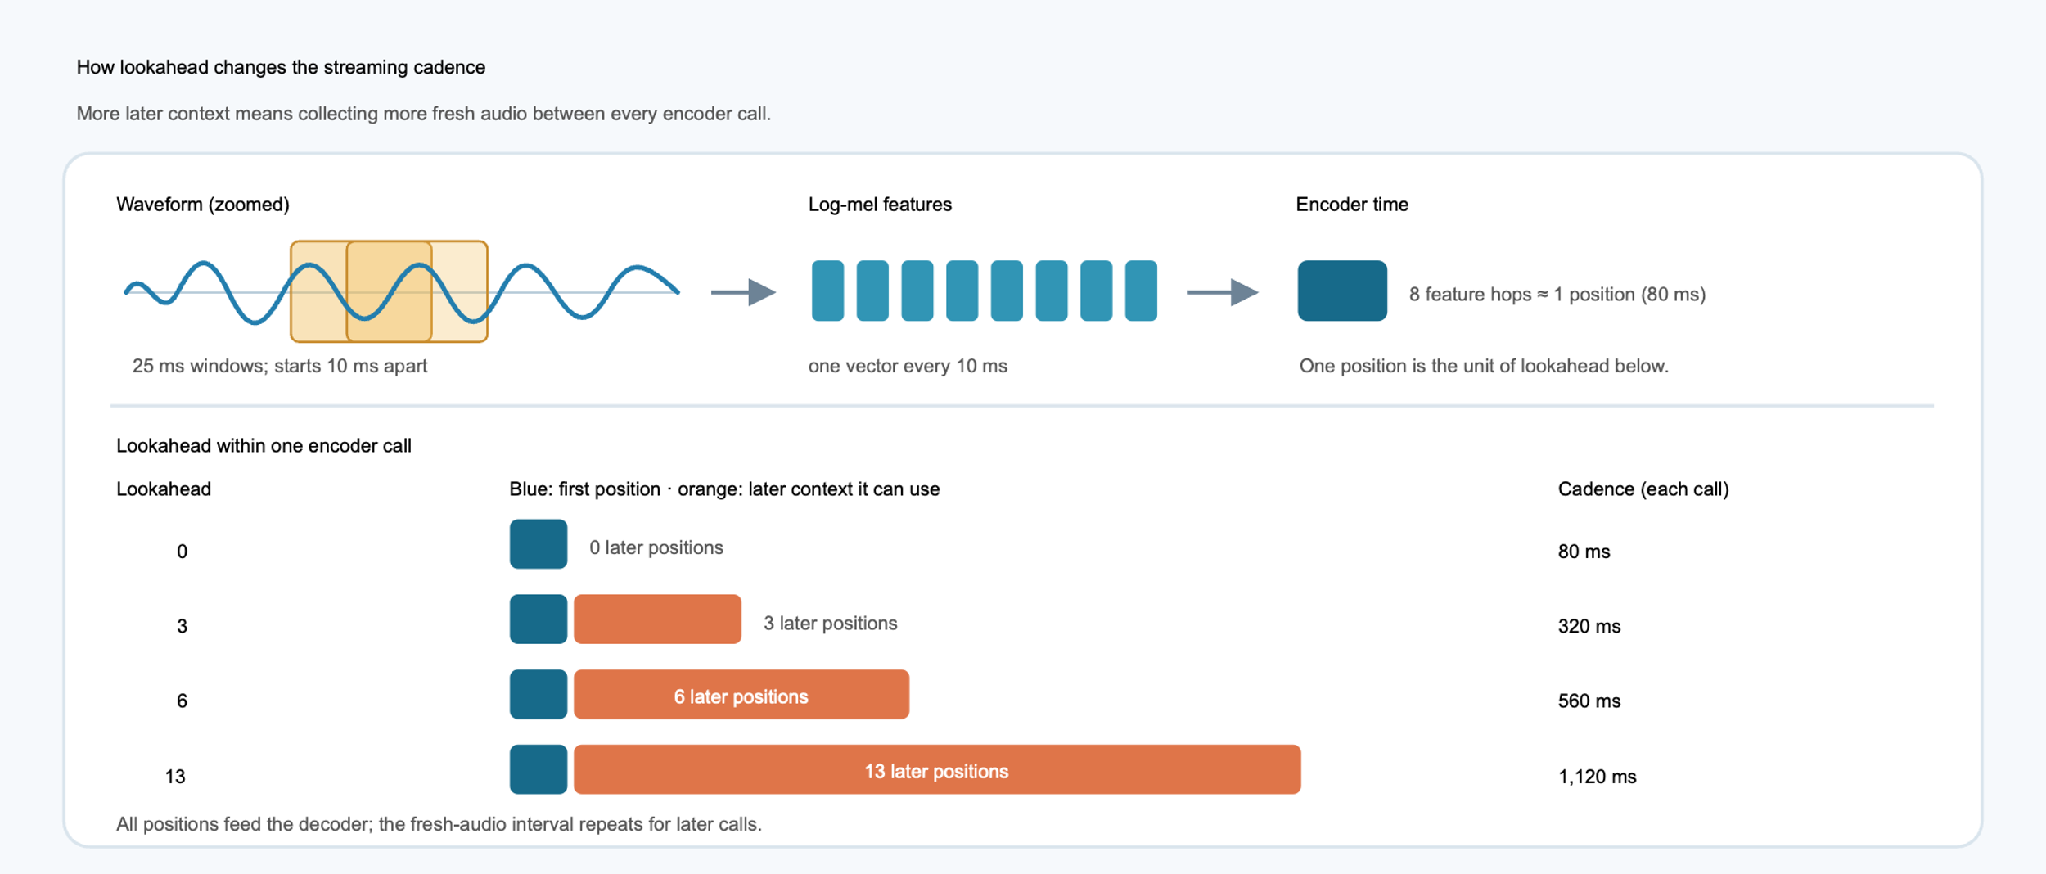
当你与设备对话时,你期望在说话的同时看到相应的文本显示。这使得流式自动语音识别(ASR)面临的挑战与批量转录截然不同,在后者中,模型…… 该文章《利用 ExecuTorch 优化 Arm® 边缘设备上的流式语音识别》最初发表于 PyTorch。

AWS于2026年10月26日发布博客,介绍一套使用AWS CDK构建的企业级智能检索(agentic retrieval)参考实现,专用于Amazon Bedrock托管型知识库(Managed Knowledge Base),支持跨知识库语义路由、迭代检索、带引用的溯源回答及七层可观测性。
推荐理由:该材料为AWS官方技术博客(2026-10-26发布),内容聚焦已上线能力(如2024年8月推出的Managed KB、AgenticRetrieveStream API)、可验证部署结构(四栈CDK应用)、明确限制(区域可用性、仅限托管KB)及开源实现细节,无性能断言或第三方背书,符合事实性与时效性要求。
Nace AI 发布了 Drex for Search,将其 Drex 决策模型应用于 AI 智能体的文档搜索。Nace 在 BrowseComp-Plus 上取得了 92.05% 的成绩,仅需 12.6 次搜索调用,并且在 OfficeQA Pro 上实现了更少的智能体交互次数。该文章“Nace AI 为 AI 智能体发布 Drex for Search:在 BrowseComp-Plus 上取得 92.05% 的成绩,仅需 12.6 次搜索调用”首发于 MarkTechPost。
作者|宇航猿 编辑|靖宇 10 月 23 日上午,Kimi 官方在 X 和视频号上发了一段 24 秒的视频。 画面里是一台复古风格的老式电脑,屏幕上开着 Kimi Code,终端里一行行地写着 Three.js 代码,在生成一个复杂的 3D 场景。眼尖的网友很快在左上角的模型栏里找到了答案——「Model: Kimi K3.1」。 Kimi 官方发布的 K3.1 预热视频|图片来源:X @Kimi_Moonshot 用一台老古董般的机器,跑一段今天最前沿的 3D 代码,这个反差本身就是月之暗面想说的话。 十几个小时后,10 月 24 日零点刚过,卡着程序员节,Kimi K3.1 Pro 正式上线,同步推出的还有一个速度快 2 到 3 倍的 Highspeed 版本。官方承诺,完整模型权重将在 11 月 4 日前放出。 距离上一代 K3 发布,过去了三个多月。这三个月里,月之暗面经历的事情,比大多数公司一年还多。 01 「加量不加价」的 0.1 先说清楚 K3.1 Pro 是什么。 它不是一个全新的模型。月之暗面明确表示,K3.1 Pro 是 K3 的后训练版本,底座没换——仍然是 2.8 万亿总参数、1040 亿激活参数的混合专家架构,仍然是 100 万 token 的上下文窗口,仍然原生支持图像和视频输入。 变的是后训练。官方的说法是投入了「大幅增加的后训练算力」,在数百个下游领域做了大规模联合强化学习,为此把强化学习框架、沙箱基础设施、长上下文推理这些底层工程都重构了一遍。 也就是时候,同一个大脑,被重新「教」了一遍怎么干活。 效果体现在榜单上。在考察编程智能体的 Terminal-Bench 4.0 上,K3.1 Pro 拿到 65.7%,超过 GPT-6 Astra 的 58.2%,和 Claude Opus 5.5 的 66.4% 只差不到一个点。上一代 K3 在
AI初创公司Recursive推出开源编码模型Flint,声称其开发过程主要由自研AI研究系统Eureka Machine完成;该模型仅40B参数、实测2.5B激活,可在普通笔记本(如M4 Pro MacBook)离线运行,推理速度达131 token/s,SWE-Bench等基准测试中表现优于多数同规模模型。
NVIDIA推出预训练关系型基础模型Kumo Relational,可直接在企业级关系数据库上执行预测任务(如流失、欺诈、需求预测),无需任务微调、特征工程或表扁平化。在41项跨15个数据库的基准测试中全面超越XGBoost等监督模型,在SAP SALT企业基准上MRR指标领先AutoGluon达8%;支持5000亿行规模数据库,通过Predictive Query Language(PQL)实现零代码预测调用。
IBM研究院提出ALTK-Evolve方法,通过GPT-4.1自动从自身任务轨迹中提炼结构化行为指南(如身份认证、退款确认等),以纯提示工程方式注入ReAct代理系统,在不更新模型权重、不依赖人工标注的前提下,显著提升客服任务的准确率与可靠性;其零售分支以67.5% Pass⁴成绩位列τ²-bench 2026年10月12日榜单第一,超越所有前沿模型及微调系统。
Learn how OpenAI is improving ChatGPT across low-resource programming languages, with new evaluations for software engineering, SQLite, and COBOL migration.
译文排队中,当前为原文 · enWe’re launching ReviewBench, a benchmark for code review agents built on representative GitHub pull requests, multi-source ground truth, calibrated evaluation, and production-aligned metrics. The post ReviewBench: An open benchmark for AI code review appeared first on The GitHub Blog.
译文排队中,当前为原文 · en打开 TTS 领导板: 多种语言文字对语音和语音克隆的可扩展评价
联合王国AISI和EvalEval如何创造基准成果
OpenAI概述了共享全球AI标准的途径,要求协调评价,报告和治理,以改善安全.
开放 ASR 领导板添加其首个全球南方语言