본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

중국, ‘톈수톈산’ 검증을 위해 10기의 위성 발사: 궤도상 AI 연산으로 우주 지능형 에이전트 시대 개막

2026년 10월 14일, 주que-2 개량형 원4 로켓이 위성 10기를 성공적으로 발사했으며, 여기에는 국성우항의 ‘싱쑤안’ 계획 02기 8기의 연산 능력 위성과 란타지능의 광전송 시험 위성 2기가 포함된다. 이번 발사는 위성 궤도상 AI 추론, 별 간 레이저 통신, 수십 킬로와트급 액체 냉각 방열 등 핵심 기술을 최초로 대규모로 검증한 사례이다. 이번 발사 이후, ‘싱쑤안’ 별자리의 궤도상 총 연산 능력은 50P에 달하게 되어, 중국의 우주 연산 인프라 구축이 실질적으로 본격화되었음을 의미한다.

추천 이유:자료는 티아이미디어가 공식적으로 발행한 업계 심층 보도(2026년 10월 26일 발표)에서 인용되었으며, 내용은 최근 완료된 우주 임무와 검증 가능한 기술 진전에 초점이 맞춰져 있습니다. 모든 핵심 사실(시각, 주체, 탑재물, 연산 성능 수치, 검증 방향)은 본문에서 명시적으로 제시된 바이며, CCTV 뉴스, 과기일보, 공식 시험 노드 등 공개된 출처와 상호 확인되었습니다. 해당 사건은 현재 시점 이전(2026년 10월 14일)에 발생했으며, 시의성과 실증적 근거를 갖추고 있습니다.
진행 상황 및 관련 보도

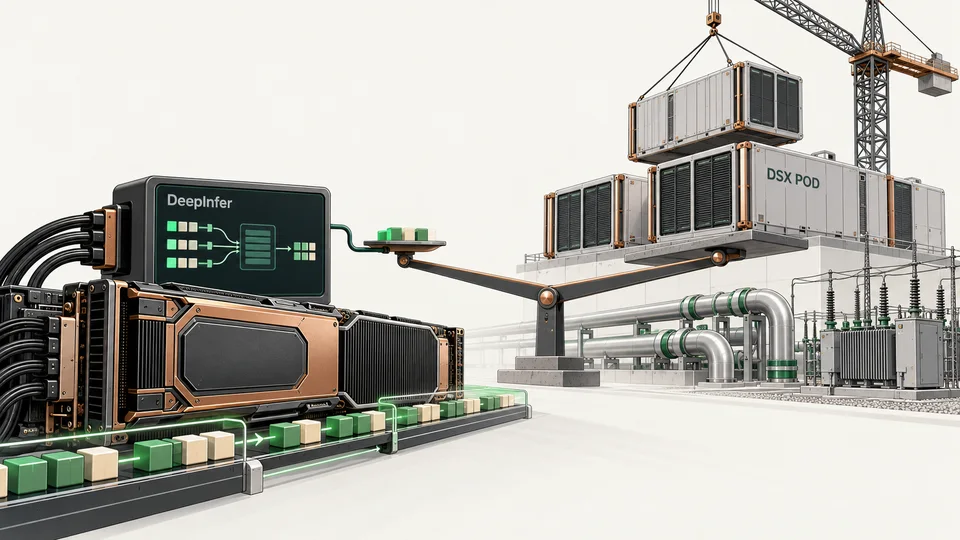
저가형 지능과 고가형 야망: DeepInfer, DSX POD 및 AI 투자 확대

제958호 《The Sequence Radar》는 추론 소프트웨어, 모듈형 AI 공장 및 기업용 AI 투자를 함께 살펴봅니다: 단일 추론 비용이 더 저렴하다고 해서 반드시 업계의 총투자 규모가 낮아지는 것은 아닙니다. 본 글은 원문을 그대로 정리했으며, DeepSeek와 엔비디아 공식 자료를 통해 기술 범위와 제공 조건을 보완했습니다.

推理软件效率与模块化AI基础设施投入的编辑示意,非实际产品照片
진행 상황 및 관련 보도

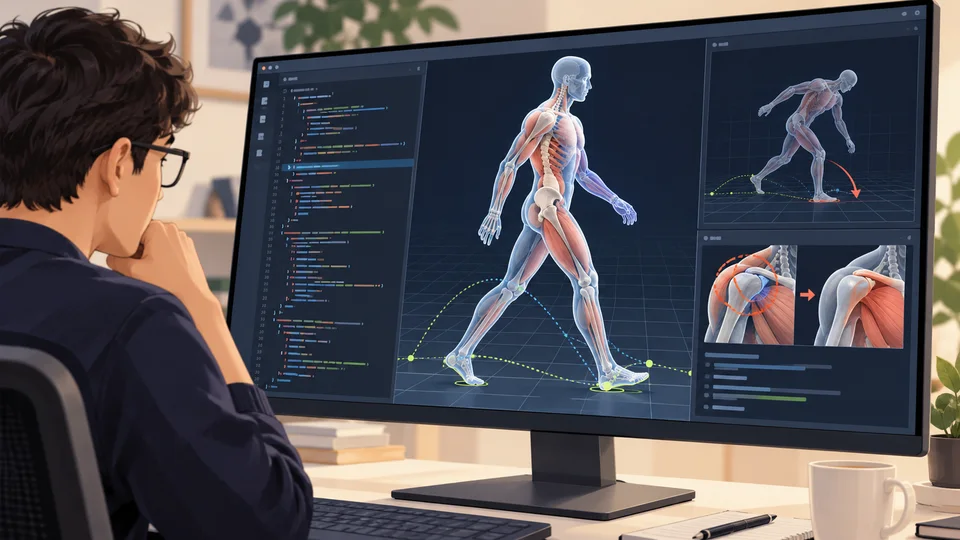
Kimi, K3.1 Pro 출시: 엔드포인트 작업 능력이 최고 수준으로 도약했으며, 시뮬레이션 디버깅과 다중 모달 프로그래밍을 통해 몸을 가진 지능의 초기 모습을 보여줍니다

Kimi는 2026년 10월 25일 K3.1 Pro 모델을 출시했으며, Terminal-Bench 4.0 터미널 작업 테스트에서 67.2%의 성공률로 1위를 차지했습니다. 또한 자체적으로 에뮬레이터 오류를 복구하고 물리 시뮬레이션, 오디오 분석, 3D 장면 구축 및 영상 편집 등 다중 작업을 수행하는 능력을 갖추고 있어, 신체 기반 지능 기술의 발전 경로를 탐구하고 있음을 보여줍니다.

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

추천 이유:본 자료는 티미디어의 공식 라이선스를 받아 발표된 실측 보고서를 기반으로 하며, Artificial Analysis, Terminal-Bench 4.0 등 권위 있는 제3자 평가 데이터와 공식 자체 테스트 결과, 그리고 필자의 다중 시나리오 기능 검증을 포괄합니다. 특히 K3.1 Pro의 실행 성능, 시뮬레이션 클로즈드 루프, 다중 모달 프로그래밍 분야에서의 실질적 진전에 초점을 맞추고 있으며, 동시에 Flash/Ultra가 아직 출시되지 않았다는 점 등 성능상의 한계와 미공개 정보를 명확히 표기하여 사실 확인과 출처 표기 요건을 준수하고 있습니다.

진행 상황 및 관련 보도

패널 제조사들이 AI로 인한 상류 원자재 비용 압박에 대응하기 위해 일제히 가격을 인상했지만, 하류 수요처의 수용도가 낮고 최종 제품의 품질 관리에도 부담이 가중되고 있다.

2026년 9월부터 TCL 화싱, BOE, 혜커 등 패널 제조사들이 잇따라 가격 인상 공지를 발표했는데, 주요 원인은 AI 대규모 모델의 발전으로 HBM 수요가 급증하면서 기성 공정 칩의 생산 용량을 압도하고, 드라이버 IC, PCB, 유리 기판 등 핵심 소재의 가격을 상승시켰기 때문이다. 코닝 등 상류 공급업체들도 동시에 가격을 인상했다. 비용 부담이 분명히 존재함에도 불구하고, 하위 단계의 TV·디스플레이 브랜드들의 구매 가격은 아직 전반적으로 오르지 않았으며, 최종 사용자들 사이에서는 과열, 블랙 스폿 등 품질 관리 관련 문제가 빈번히 발생해, 가격 인상이 실제 거래와 체험 개선으로 이어지지는 못한 상황이다.

AI大模型狂飙,面板行业也扛不住了

추천 이유:재료 시스템은 AI 산업이 직접적으로 연관되지 않은 하드웨어 업계에 미치는 크로스체인 전파 메커니즘을 규명한다—AI가 패널 수요를 직접적으로 견인하는 것이 아니라, 웨이퍼 생산능력의 재배분을 통해 전 체인에 걸친 비용 재정립을 촉발한다는 점이다. 동시에 가격 인상 행태와 시장의 실제 반응(가격 정체, 출하량 감소, 사용자 불만) 간의 뚜렷한 괴리를 보여주며, 이는 산업의 협상력과 제품 경쟁력 간의 불일치라는 근본적인 모순을 부각한다.

진행 상황 및 관련 보도

llama.cpp가 b11870 버전을 출시하여 DeepSeek-V4.1-Flash 모델을 정식으로 지원합니다.

llama.cpp는 버전 b11870에서 DeepSeek-V4.1-Flash(deepseek41) 모델을 지원하며, Engram 아키텍처를 기반으로 KV 캐시 계산 간소화, BF16 정밀도를 MXFP8로 대체, 인그래프 내 행 수집 등 여러 하위 수준 최적화를 수행했습니다. 또한 macOS, Linux, Windows, Android, iOS 및 openEuler를 포괄하는 다중 플랫폼 바이너리 빌드를 동시에 제공합니다.

진행 상황 및 관련 보도

llama.cpp가 b11865 버전을 출시했습니다: RDMA 수신 경계 검사 기능이 추가되었으며, CUDA 13.4, ROCm 10.0, Snapdragon NPU 등 다중 플랫폼 백엔드를 지원합니다.

llama.cpp 프로젝트는 빌드 버전 b11865를 출시했으며, 핵심 변경 사항으로는 RDMA 수신 로직에 메모리 경계 검사를 추가하고(PR #30399), CUDA 13.4, ROCm 10.0, Vulkan, OpenVINO, SYCL 및 퀄컴 스냅드래곤(CPU+Adreno+Hexagon)의 풀스택 이기종 컴퓨팅 백엔드를 포함해 하드웨어 가속 지원을 대폭 확장한 점이 있습니다. 또한 macOS용 KleidiAI 지원과 openEuler 빌드는 명시적으로 DISABLED로 표시되었습니다.

진행 상황 및 관련 보도

llama.cpp가 b11861 버전을 출시했습니다: minimax-m3 모델의 양자화 스케일링 텐서가 전달되지 않아 발생하는 추론 오류를 수정했습니다.

llama.cpp v.b11861은 minimax-m3 모델에서 NVFP4/MXFP8 양자화 시 스케일 텐서가 계산 그래프에 주입되지 않아 발생하던 가중치 왜곡 문제를 해결하여 ‘토큰 수프’ 현상과 잔차 소멸을 방지합니다. 또한 macOS, Linux, Windows, Android, iOS 및 openEuler를 지원하는 다중 플랫폼 바이너리 빌드를 함께 제공합니다.

진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

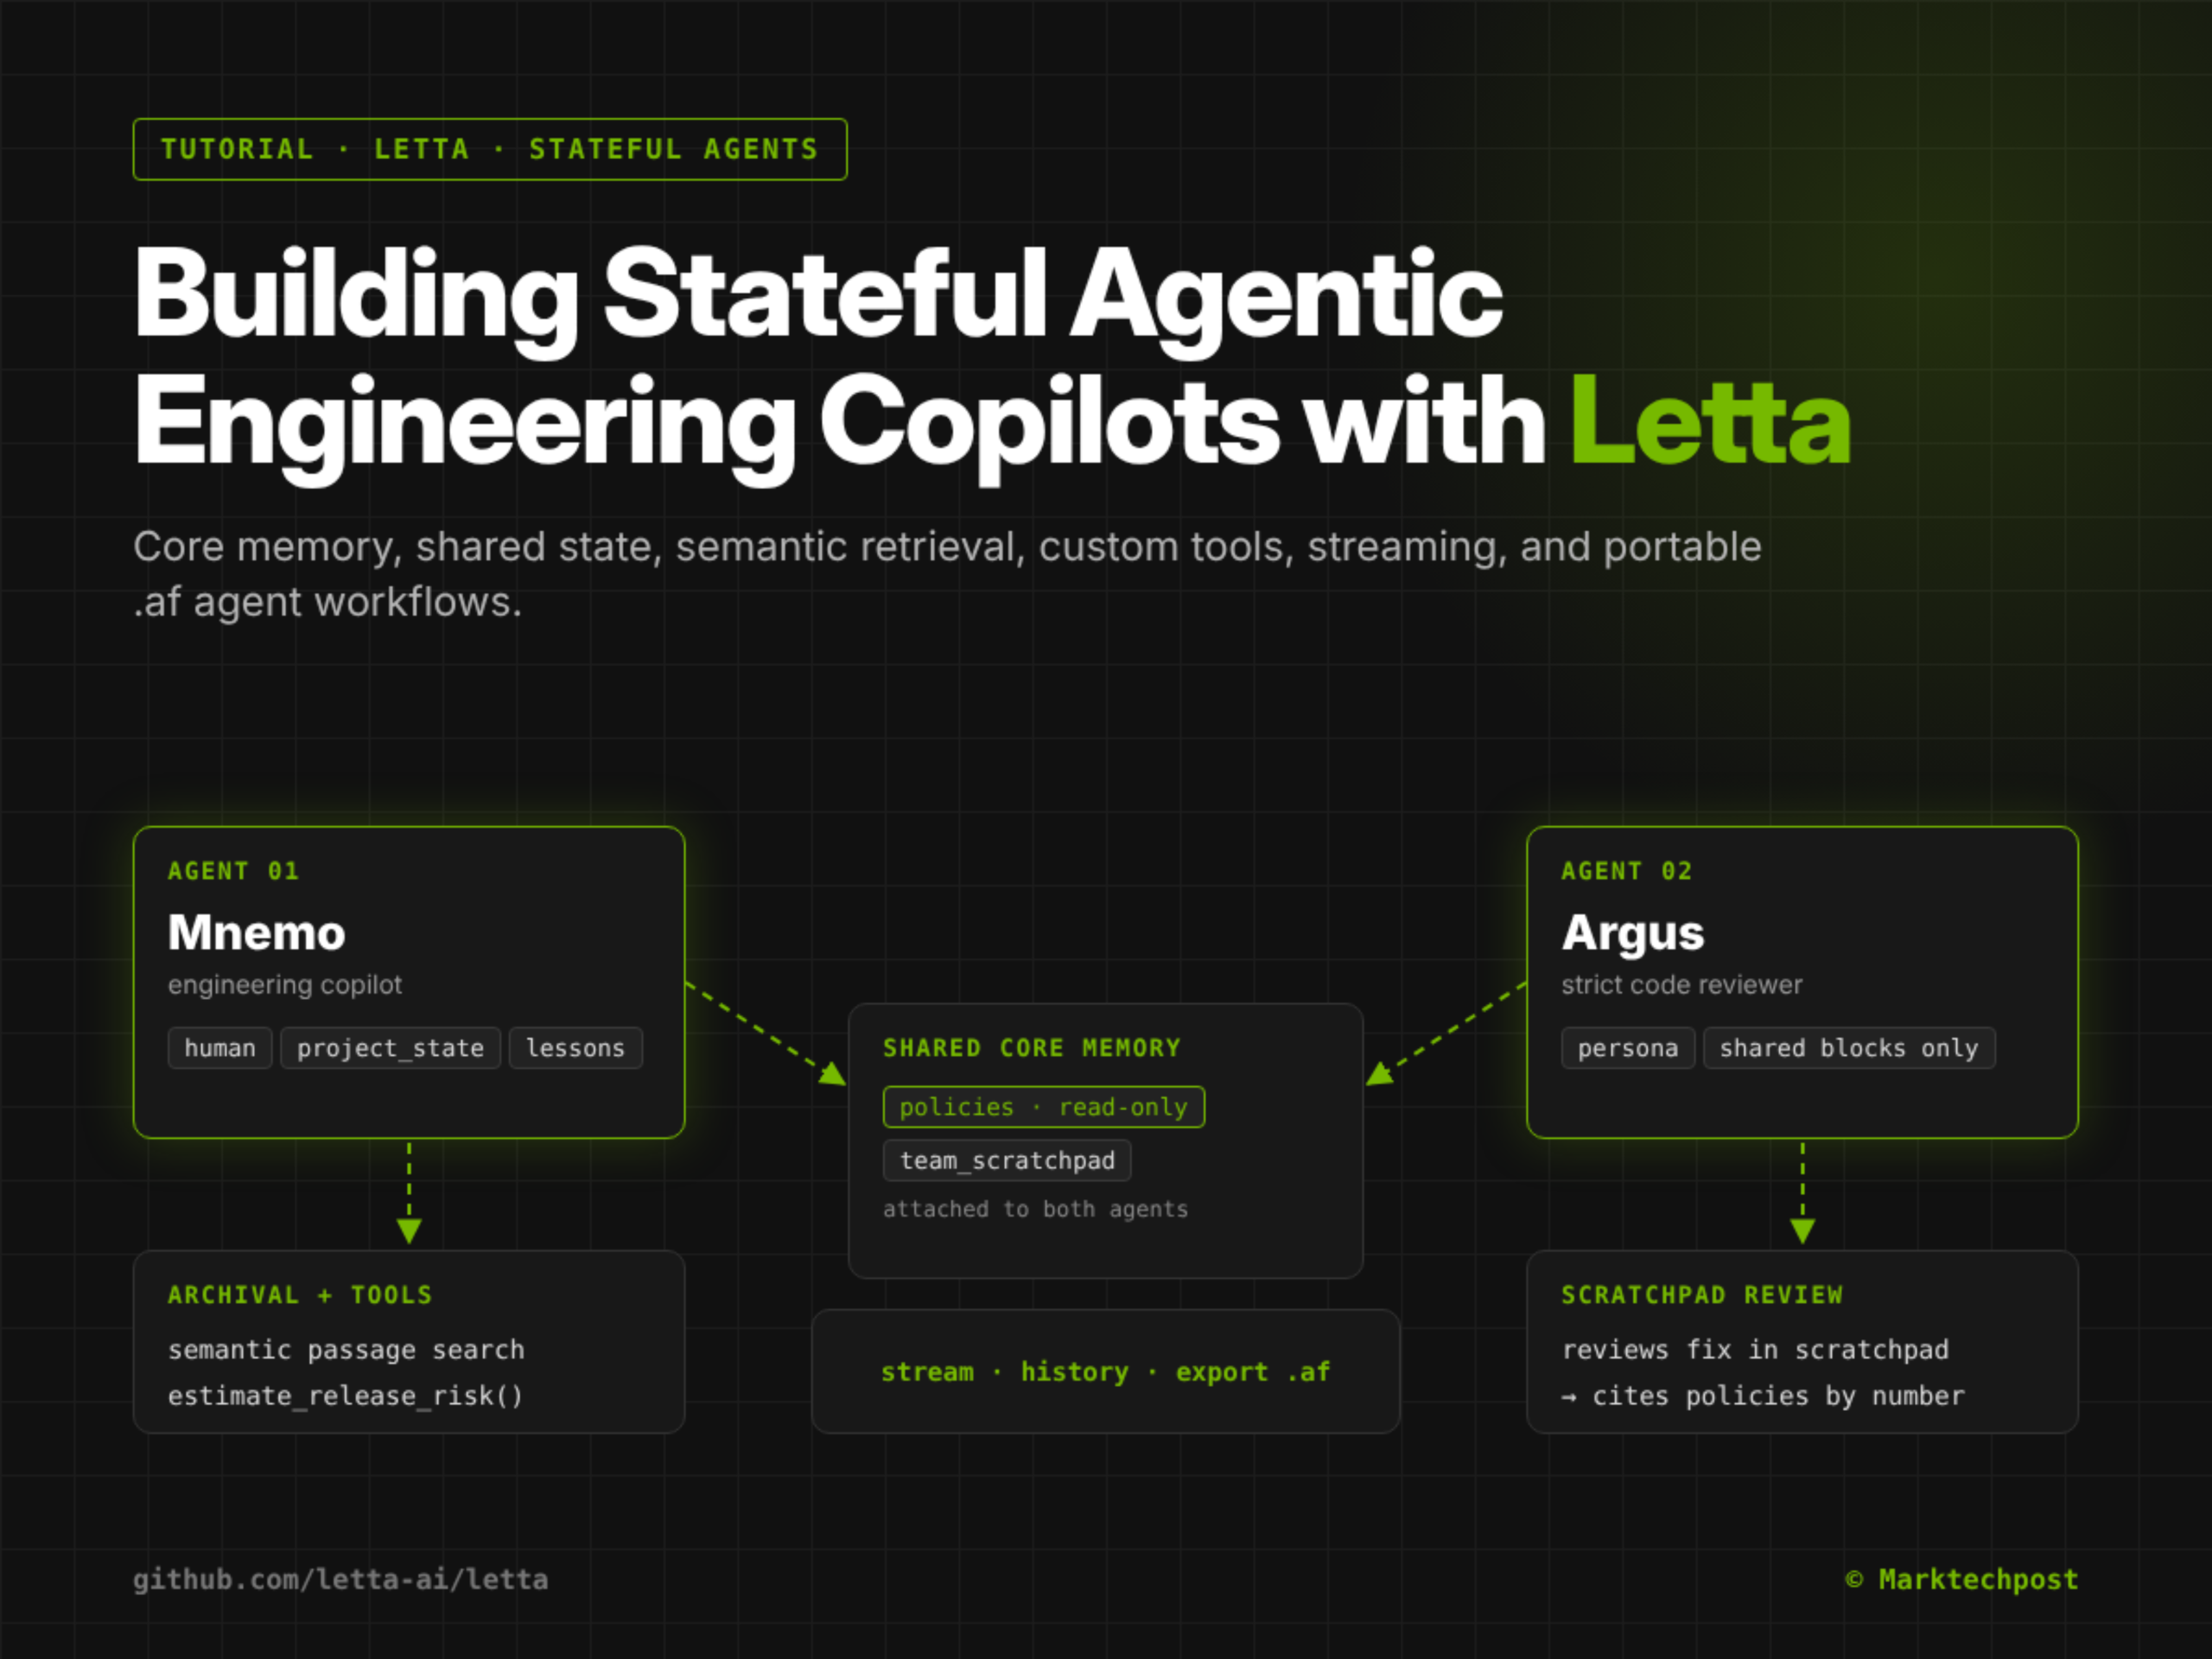
Letta 플랫폼에서 상태 기반 엔지니어링 협업자 구축 튜토리얼을 공개했습니다: 핵심 메모리, 공유 상태 및 이식 가능한 워크플로우를 지원합니다.

MarkTechPost는 2026년 10월 24일, Letta 프레임워크를 기반으로 지속적 상태를 갖춘 엔지니어링 협업자(agentic copilot)를 구축하는 방법을 소개하는 튜토리얼을 발표했습니다. 이 튜토리얼은 검증 가능한 핵심 메모리, 다중 에이전트 간 공유 메모리, 의미 기반 검색을 통한 지식 아카이브, 맞춤형 Python 도구 통합, 스트리밍 응답 및 .agent 형식(.af) 내보내기 등의 기능을 포괄합니다. 해당 내용은 기술 실무 가이드로, 성능 지표, 보안 감사 또는 생산 환경에서의 검증은 제공되지 않습니다.

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
진행 상황 및 관련 보도

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed
진행 상황 및 관련 보도

ULME 프레임워크는 텍스트 임베딩과 언어 모델링을 진정으로 통합한다: arXiv의 새로운 논문이 예측 결합 메커니즘을 제안했다

2026년 10월 24일, arXiv는 논문 arXiv:2610.30705v1을 발표하여, 인과적 디코더형 대규모 언어 모델을 위한 후처리 훈련 프레임워크인 ULME를 제안했습니다. 이 프레임워크는 예측 결합(predictive coupling) 메커니즘을 통해 텍스트 임베딩과 언어 생성 능력 간의 상호 강화적 통합을 최초로 구현했습니다. 해당 방법은 Qwen2.5/Qwen3 시리즈(0.5B–8B 파라미터)에서 검증되었으며, MTEB 지표에서 3.3–4.1점의 성능 향상을 달성하는 동시에, MMLU 등 생성 과제에서의 성능 저하를 방지했습니다.

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

추천 이유:이 논문은 현재 다중모달 LLM의 능력이 분절되어 있는 핵심 문제를 정면으로 지적한다: 임베딩과 생성은 오랫동안 독립된 모델 또는 파라미터만 공유하는 ‘가짜 통합’ 모델에 의해 담당되어 왔다. ULME는 학습 가능한 슬롯과 세 가지 목표를 결합한 공동 학습(스톱그레이디언트 예측 손실 포함)을 통해 생성 과정이 임베딩 표현을 주도적으로 형성하도록 하였으며, 이는 아키텍처 차원에서의 실질적인 획기적 발전이다. 실험 범위가 광범위하고 기준선이 강력하며 지표가 포괄적이며, 권위 있는 사전출판 플랫폼에 발표되어 시의성과 기술적 엄밀성이 모두 갖추어져 있다.

진행 상황 및 관련 보도

LLM 평가에서 집계 점수는 개별 판단의 불안정성을 은폐한다: Arena-Hard의 새로운 연구가 지시어 민감성을 밝혀내다

이 연구에서는 Arena-Hard v2.0 편지 500개를 사용하여 두 모델의 답변을 고정하고, GPT-4.1을 심판으로 삼아 8가지 명령어 조합 하에서 반복적으로 평가한 결과, 집계 점수의 변화가 매우 미미(예: ±1점)하더라도 개별 편지의 승패 판정 결과가 최대 21.2%까지 변경됨을 확인했다. 또한 명령어를 조정하면 불안정성이 더욱 확대되어 최대 28.2%포인트의 추가적인 판정 변동이 발생했지만, 집계 점수는 거의 변하지 않았다.

Behind Aggregate Scores: What Systematically Varying Arena-Hard's LLM Judge Reveals

추천 이유:이 연구는 현재 LLM 평가 관행의 핵심적 맹점을 정면으로 지적한다—즉, 집계 점수에 지나치게 의존하면서 개별 판단의 재현성과 명령어 의존성을 간과하는 문제를 말한다. 이는 선호 모델링, 인간 피드백 강화학습(RLHF) 등 세밀한 수준의 판단을 필요로 하는 과제들에 대해 중요한 방법론적 경고를 제공한다.

진행 상황 및 관련 보도

연구에서는 자가평가 강화학습 프레임워크 SARL을 제안하여 검색 증강형 대규모 모델의 검색 상태 인식 능력을 향상시켰다.

2026년 10월 24일, arXiv은 논문 arXiv:2610.30435v1을 발표하여, 기존 검색 증강형 대규모 언어 모델에서 검색 에이전트가 검색 상태에 대한 인식 능력을 갖추지 못하는 문제를 해결하기 위한 Self-Assessment Reinforcement Learning(SARL) 프레임워크를 제안했습니다.

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

추천 이유:이 연구는 검색 강화형 대규모 언어 모델이 복잡한 과제에서 이미 획득된 정보나 누락된 정보를 인식하지 못해 환각 추론과 조기 탐색 종료라는 핵심적 결함을 겪는 문제를 해결하기 위해, 테스트 시 추가적인 평가 없이도 작동하는 엔드투엔드 강화학습 방안을 제안하고, 다중 점프 추론 및 심층 연구 벤치마크에서 상당한 성능 향상을 달성했습니다.

진행 상황 및 관련 보도

도구 강화형 언어 모델의 프롬프트 민감성 연구: 도구는 정확도를 향상시키지만 표현 차이의 영향을 심화시킨다

2026년 10월 24일 arXiv 플랫폼에 게재된 연구(번호 2610.31148v1)는 도구 강화 환경 하에서 여섯 가지 오픈소스 언어 모델이 다섯 가지 분야와 다섯 가지 질문 표현 방식에 대해 비교한 결과, 대비 안정성이 향상되지 않았음을 지적했다. 오히려 도구가 프로그램이 답변할 수 있는 문제의 정확도를 높였음에도 불구하고, 문구의 차이에 따른 모델 순위 변동의 민감성은 확대되었다.

Prompt Sensitivity in Tool-Augmented Model Comparisons

추천 이유:이 연구는 새롭게 설계된 매칭 프로토콜을 활용하여, 도구 호출 전 과정의 핵심 단계들(예: 호출 결정, 도구 응답, 무호출 보고 등)을 분리함으로써, ‘정확도 향상’이 반드시 ‘보다 안정적인 비교’를 의미하지 않음을 실증적으로 규명하고, 인터페이스 설계와 명령어 세부사항이 민감도 수준을 유의미하게 조절함을 지적함으로써 모델 평가 실무에 직접적인 지침 가치를 제공한다.

진행 상황 및 관련 보도

RIFT는 동적 KV 캐시 압축 전략을 제안하여 디코딩의 구식화 문제를 완화하고, 추론 디코딩의 품질을 향상시킨다.

2026년 10월 24일, arXiv는 논문 arXiv:2610.31098v1을 발표하여 RIFT—추론 디코딩에서 초안 모델(drafter)을 위한 동적 KV 캐시 압축 방법—을 제안했습니다. 이 방법은 사전 채워진 정보와 새로 생성된 토큰 간의 균형을 맞추고, 압축 가능성을 고려한 학습을 결합함으로써, 8K토큰의 KV 캐시 예산 하에서 Qwen3.5-4B 초안 모델이 Qwen3.5-122B로 장문맥 생성을 수행할 때 전체 캐시 수용 길이의 98% 이상을 유지하도록 합니다.

RIFT: KV Cache Compression for Draft Models with Complementary Compressibility Training

추천 이유:이 연구는 긴 출력 생성 시 KV 캐시의 팽창으로 인한 하드웨어 비용 증가와 정확도 저하 간의 상충 문제에 대해 직접적으로 접근하며, ‘디코딩 노후화’(decode staleness) 현상을 최초로 명확히 정의하고 정량화한 뒤, 실현 가능한 리프레시 메커니즘과 학습 협업 방안을 제안합니다. 실험 설정은 구체적(입력 32K/출력 4K/캐시 8K)이며, 결과는 엔지니어링 차원에서의 참고 가치를 지닙니다. 출처는 arXiv 사전인쇄본으로, 게시일(2026-10-24)이 시스템의 현재 날짜(2026-10-25)와 일치하여 시의성이 강합니다.

진행 상황 및 관련 보도

새로운 연구는 추론 시 문맥 증강 방법의 효과에 의문을 제기하며, 정확도 향상이 우연한 변동일 수 있다고 밝혔다.

2026년 10월 24일 arXiv에 게재된 AI 연구 논문(번호 2610.30983v1)은 다섯 가지 추론 시 컨텍스트 증강 방법을 체계적으로 평가한 결과, 보고된 정확도 향상이 실제 능력의 증진을 반영하는 것이 아니라 방향성 없는 왜곡에 기인할 수 있으며, 이는 일부 예측을 수정하는 동시에 다른 예측을 손상시키는 현상으로 나타날 수 있음을 밝혀냈다.

A Reality Check of Inference-Time Context Augmentation Methods

추천 이유:이 논문은 최초로 방법, 모델, 데이터셋을 아우르는 통합 평가 프레임워크를 구축하며, 성능 향상에만 의존하면 신뢰성의 결함이 은폐되기 쉽다는 점을 지적합니다. 특히, 새로운 정보를 도입하지 않는 filler-token 방식은 결정 경계 근처의 예측에 주로 영향을 미치므로 실제 배포에는 직접 적용하기에 적합하지 않음을 경고합니다.

진행 상황 및 관련 보도

Protegrity-PII: 새로운 PII 식별 모델 출시, 정형 및 비정형 텍스트 지원

2026년 10월 24일, 연구팀은 arXiv(번호 2610.30518v1)에 개인식별정보(PII) 식별을 위한 새로운 의사결정 모델인 Protegrity-PII 모델을 발표했다. 이 모델은 새로운 벤치마크인 PII-SCOPE에서 유형화된 재현율 0.915와 정확도 0.907을 달성했으며, 추론 속도는 100만 문자당 0.49초, 비용은 100만 문자당 단 0.0005달러(단일 RTX 6000, 배치 처리 기준)였다.

Protegrity-PII Technical Report

추천 이유:이 기술 보고서는 정량화된 성능 지표, 명확한 하드웨어 및 비용 조건, 새롭게 제안된 벤치마크 PII-SCOPE, 그리고 분포 외 일반화 능력에 대한 실증적 비교를 제공하며, 연구의 투명성과 엔지니어링 참고 가치를 갖습니다. 발표일시(2026-10-24)는 현재 시점(2026-10-26)보다 늦지 않아 유효한 최근 성과에 해당합니다.

진행 상황 및 관련 보도

연구에서는 자회귀 대규모 모델을 제어하여 전략적으로 정밀한 병렬 추론으로 컴파일함으로써 계층형 RAG의 효율성을 향상시킬 것을 제안한다.

2026년 10월 24일 arXiv에 게재된 연구 논문(번호 2610.30664v1)은 계층적 검색 증강 생성(Hierarchical RAG)에서 대규모 언어 모델의 자회귀 제어 로직을 정책 정확(policy-exact)한 병렬 추론 프로세스로 컴파일하는 새로운 방법을 제안하며, MetaX 장치에서 제어 지연을 35–47% 감소시키는 동시에 정책 일관성을 84–89% 유지한다고 밝혔다.

Compiling Autoregressive LLM Control into Policy-Exact Parallel Inference for Hierarchical RAG

추천 이유:이 성과는 LLM이 구조화된 의사결정 제어기로 활용될 때 일반적으로 직렬 텍스트 디코딩에 의존하는 병목 현상을 해결하기 위해, 이론적으로 입증 가능한 병렬 컴파일 방안을 제시한다. 실험은 실제 하드웨어(MetaX, H800)와 다중 데이터 분할을 기반으로 검증되었으며, 처리 속도가 뛰어나고 기술적 세부사항이 명확하여 최첨단 신뢰성 있는 AI 시스템 최적화 연구에 해당한다.

진행 상황 및 관련 보도

FusionEval 발표: 대규모 언어 모델 통합을 위한 새로운 벤치마크 테스트

2026년 10월 24일, 연구자들은 arXiv에 논문 arXiv:2610.30162v1을 발표하여, 대규모 언어 모델의 통합 방법 평가를 위해 설계된 최초의 통합 벤치마크인 FusionEval을 제안했다. 이 벤치마크는 추론 체인 길이, 도구 호출 등 취약한 부분을 포괄하며, 학습 기반 및 학습 불필요형 통합 방법 간의 비교도 지원한다.

FusionEval: Benchmarking Model Fusion for Large Language Models

추천 이유:이 벤치마크는 기존 평가에서 장기 체인 추론과 도구 활용에 대한 포괄성이 부족한 점을 보완하며, 평균 성능과 최악의 성능 간의 명확한 구분을 제공하고, Qwen3/Llama 기반의 재현 가능한 전문가 풀, GPU 메모리 및 실행 시간을 포함한 다차원 지표, 그리고 오픈소스 코드를 제공하여 강력한 실무 지침성을 갖추고 있습니다.

진행 상황 및 관련 보도

연구는 특이값 스펙트럼을 통한 간섭으로 대형 언어 모델의 능력 분포를 조절한다: Llama 및 Qwen 모델에 대한 실증 분석

2026년 10월 24일 arXiv(번호 2610.30676v1)에 게재된 한 AI 연구는 오픈소스 Llama 및 Qwen 지침微調 모델 다섯 가지에 대해 후속 특이값 스펙트럼 평활화와 첨두 섭동을 적용한 결과, 이러한 경량 간섭이 사실 지식, 언어 이해, 연역 추론의 세 가지 능력 간의 성과 균형을 체계적으로 재편할 수 있음을 밝혀냈다.

Spectral Smoothing and Spiking Perturbations Reconfigure Capability Profiles and Selective Task Performance in Large Language Models

추천 이유:이 논문은 다중 모델 및 다중 작업 프레임워크 하에서 변환기의 전방향층 특이값 스펙트럼 구조가 하위 작업 성능에 미치는 인과적 영향을 최초로 실증적으로 검증함으로써, 성능 배치의 구조적 민감성 법칙을 규명하고 모델 성능의 해커팅 및 제어 가능한 편집을 위한 새로운 경로를 제시하였다. 모든 결론은 공개된 모델과 표준 평가 기준에 기반하며, 방법은 투명하고 평가 차원은 포괄적이다.

진행 상황 및 관련 보도