
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

SAGEベンチマークとGARフレームワークの公開:マルチモーダルな意味的整合性評価の推進

2026年10月26日、arXivは論文arXiv:2610.31838v1を公開し、Sense-Aligned Grounding Evaluation(SAGE)——統一された10候補画像選択基準——を提案するとともに、名詞・動詞・実体中心の多モーダルなグラウンディング評価を実施するための、学習非依存型のGloss-Augmented Reasoning(GAR)フレームワークも併せて提示した。

新闻源配图 · arXiv cs.CL

注目する理由:本研究は、VWSD、VerSe、WikiDiverseの3種類のタスクを用語中心のグラウンドトゥルース評価プロトコルに統一し、混同行動による難負例の導入とコンテキスト交換による診断メカニズムを提案しました。さらに、定義の強化と制約による推論の誘導が協調して作用することでHits@1指標を大幅に向上させること(65.90→71.22)を実証し、マルチモーダルな意味対応の評価においてより細粒度で解釈可能な新たなパラダイムを提供しています。

経緯と関連報道

物理学に基づく最適化のためのエンドツーエンド微分可能な拡散条件付け

arXiv:2610.31721v1 発表タイプ:新規 要旨:評価コストが高く、複雑な制約条件下で高次元の物理系を最適化することは、科学および工学における中心的な課題である。オフラインのモデルベース最適化(MBO)では、テスト時に真の目的関数にアクセスできない状況下で、固定されたデータセットのみを用いて設計を改善しなければならない。しかし、既存の手法は一般的に保守的すぎる、代理モデルの無制限な活用、あるいは精密な物理的目標に対して候補を精緻に修正できない静的な推論時サンプリングとして機能するといった問題を抱えている。本稿では、確定的サンプリングにより逆ノイズ除去チェーンが条件付信号に関して微分可能となるという事実を活用した、オフラインMBO向けの微分可能な拡散条件付け(D2C)を提案する。D2Cは…

End-to-End Differentiable Diffusion Conditioning for Physics-Informed Optimization
経緯と関連報道

SyncVid:同期ビデオ生成のための世界不変拡散モデル

arXiv:2610.31765v1 発表タイプ:新規 要旨:単一の参照ビデオから動的シーンの複数の映像を生成するには、視点間で観測された内容と未観測の内容を一貫して合成する必要があります。既存のビデオ拡散におけるカメラ制御手法は、通常、カメラ埋め込み、クロスビュー注意機構、幾何学的条件付けといったアーキテクチャ上の仕組みに依存しています。しかし、これらの手法は静的なシーンコンテンツに対しては有効であっても、視点間および時間経過において一貫性が求められる細部にわたる動的ジオメトリにはしばしば対応しきれません。我々は、各2次元画像平面で独立にサンプリングを行うのではなく、ソースビデオから導かれる標準的な3次元空間においてガウスノイズの事前分布をサンプリングし、それをターゲットとなるカメラへラスタライズすることで、拡散プロセス自体を同期させます。我々のm

SyncVid: World-Equivariant Diffusion for Synchronized Video Generation
経緯と関連報道

屋内無線地図推定のための協調的文脈内学習

arXiv:2610.31702v1 発表タイプ:新規 要旨:屋内無線地図推定(RME)は、カバレッジ計画、位置推定、ネットワーク展開などの無線通信アプリケーションにおいて不可欠である。しかし、既存の手法の多くは、高コストなラベル付きデータとタスク固有のモデル学習を必要とする教師あり学習パラダイムに従っている。さらに、屋内環境には建物のレイアウトや構造といったプライバシーに関わる情報が含まれており、これらを集中管理することはしばしば困難である。これらの課題に対処するため、私たちは初めて、屋内RMEを協調的文脈内学習(ICL)問題として定式化する試みを行った。提案するPoly-Rippleは、複数のクライアントがモデルの更新なしに大規模自己回帰型視覚モデル(LAVM)を用いてICLを行うフレームワークである。各クライアントは、自身のプライベートなデモンストレーションによってプロンプトを与えられる。

Collaborative In-Context Learning for Indoor Radio Map Estimation
経緯と関連報道

文脈または知識:大規模言語モデルが自らの回答をどのように帰属させるか

arXiv:2610.32109v1 発表タイプ:新規 要旨:言語モデルは、与えられた文書や自身のパラメトリックな知識に基づいて質問に答えることができる。では、後になってその回答の出所を問われた際、どのような基準で出所を報告するのか?本研究では、回答生成後かつ出所に関する質問が提示される前に、モデルのキーバリュー(KV)キャッシュに介入することでこの問題を検討した。4つのモデル(7B~32B)を用いた制御された事実確認タスクにおいて、文書のキャッシュを変更または削除しても、出所の報告内容には一切影響が見られなかった。一方で、同一の質問と回答トークンを用いた複数回の実行間で質問と回答のキャッシュを移植すると、その報告内容は受け渡され、寄贈元の出所報告に従う一方で、受領側の文書内容は変化しなかった。さらに、比較的小規模な2つのモデルでは、出所に関する質問が提示される前に適合させた方向へQ&A値を操作することで、出所の報告内容を意図的に制御することも可能であった。

経緯と関連報道

ミュオンの前処理はいつ、どのように行われるのか?構造化された勾配ノイズの役割

arXiv:2610.31728v1 発表タイプ:新規 要旨:ミュオンは大規模言語モデルの学習において人気の最適化手法となっているが、その理論的基盤は依然として十分に解明されていない。本研究では、勾配ノイズの幾何学的特性がミュオンの前処理による利点をどのように形成するかを検討する。まず、古典的な等方性ノイズ仮定のもとでは、ミュオンは学習率の再スケーリング以上の加速効果をもたらさないことを理論的および実験的に示す。これを受けて、私たちは異種タスクの発生頻度を持つ連想記憶におけるミニバッチサンプリングから生じる構造化されたノイズについて調査を開始した。二つのタスクに対する正確なバランス閾値を導出し、さらに複数タスクへの拡張を通じて、タスクカバレッジと勾配の信頼性がいかに協働して学習を形作るかを明らかにする。我々の分析によれば、ミュオンは…を緩和できることが示される。

When and How Does Muon Precondition? The Role of Structured Gradient Noise
経緯と関連報道

大規模言語モデルの分布整合性とその一般化特性

arXiv:2610.31687v1 公告タイプ:新規 要旨:大規模言語モデルは、アンケート調査などにおいて、人間の行動をシミュレートし、分析するための手段としてますます広く利用されています。これらの用途において重要な特性は、出力が分布整合性を満たすことであり、すなわち、出力の分布をある参照(ここでは人間の)分布に一致させることです。分布整合性を実現する際の障壁の一つは、少量の学習データから一般化することです。本研究では、(1) 大規模言語モデルをどのように分布整合させるか、および (2) いったん整合された大規模言語モデルが、未見のサンプルや関連しないトピック・タスクに対してもどのように一般化できるかを検討しています。二つの大規模ベンチマークを用いて、大規模言語モデルは確かに分布整合性を達成でき、同一ドメイン内の未見の質問に対しても一般化可能であることを示しました。一方で、トピック間の一般化は、各トピック間の関係性に依存します(例えば、

経緯と関連報道

金融犯罪分析のための敵対的ロバスト性を備えた多グラフニューラルネットワークへ

arXiv:2610.31718v1 発表タイプ:新規 要旨:金融取引ネットワークは自然に多グラフとして表現され、同一の口座ペア間の繰り返し取引は異なる辺としてモデル化される。近年提案された多グラフニューラルネットワークのアーキテクチャは、この構造を明示的に活用することで、マネーロンダリング防止(AML)タスクにおいて高い性能を実現している。しかし、検出を回避するために取引構造を操作する敵対者に対するそのロバスト性については、依然としてほとんど研究されていない。本稿では、ノード・エッジ接続行列を用いた多グラフニューラルネットワークに対する構造攻撃および敵対的学習のための初のスケーラブルなフレームワークを提示し、このような多グラフ上で構造的な摂動を最適化するため、射影勾配降下法および射影ランダム化ブロック座標降下法を適用している。

Towards Adversarially Robust Multigraph Neural Networks for Financial Crime Analysis
経緯と関連報道

LazyFlash:長文コンテキストの高速微調整のための前方は密集、後方は疎なアテンション

arXiv:2610.31911v1 発表タイプ:新規 要旨:大規模言語モデル(LLMs)がますます長いシーケンスを処理するにつれ、アテンションは主要な計算上のボトルネックとなっています。疎なアテンション手法は主に推論段階での利用を対象としていますが、多くの手法は依然として密集型で学習を行ったり、疎な学習に対応できなかったりします。さらに、その追加の複雑さにより、疎さを実際の実行時間の短縮へと結びつけることが難しく、結果として実用的には密集型アテンションが広く用いられています。本論文では、アテンションの学習は後方パスが支配的であるという観察に基づき、前方パスを完全に密集型に保ちつつ、後方パスを疎にするLazyFlashという手法を提案します。LazyFlashは前方パスを厳密に密集型に維持するため、学習済みモデルは従来の密集型モデルのままであり、vLLMなどの既存システムでも一切変更なしにサービス可能です。一方、後方パスについては、LazyFlashは勾配を…

経緯と関連報道

エッジによるLLMトレーニングの民主化:課題・システム・今後の展望

arXiv:2610.32215v1 発表タイプ:新規 要旨:現代のGPUデータセンターにおける計算能力の向上により、一部の産業大手企業が膨大なデータを用いて大規模言語モデル(LLM)を訓練し、展開できるようになりました。しかし、これらのモデルとその学習データの圧倒的な規模は、集中型の開発をますます維持困難にすると同時に、関連するプライベートデータを保有しながら同等のインフラを持たない小規模機関を排除しています。本論文では、分散型LLMトレーニングに関する我々の立場を、事前学習および微調整のパラダイムを中心に整理し、フェデレーテッド学習、スプリット学習、そして分散型アプローチを取り上げ、それらが地理的に分散した環境下で、多様なハードウェアや信頼性の低い接続状況においてどの程度実用可能かを評価します。さらに、我々は「統一された」システムを提案します。

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
経緯と関連報道

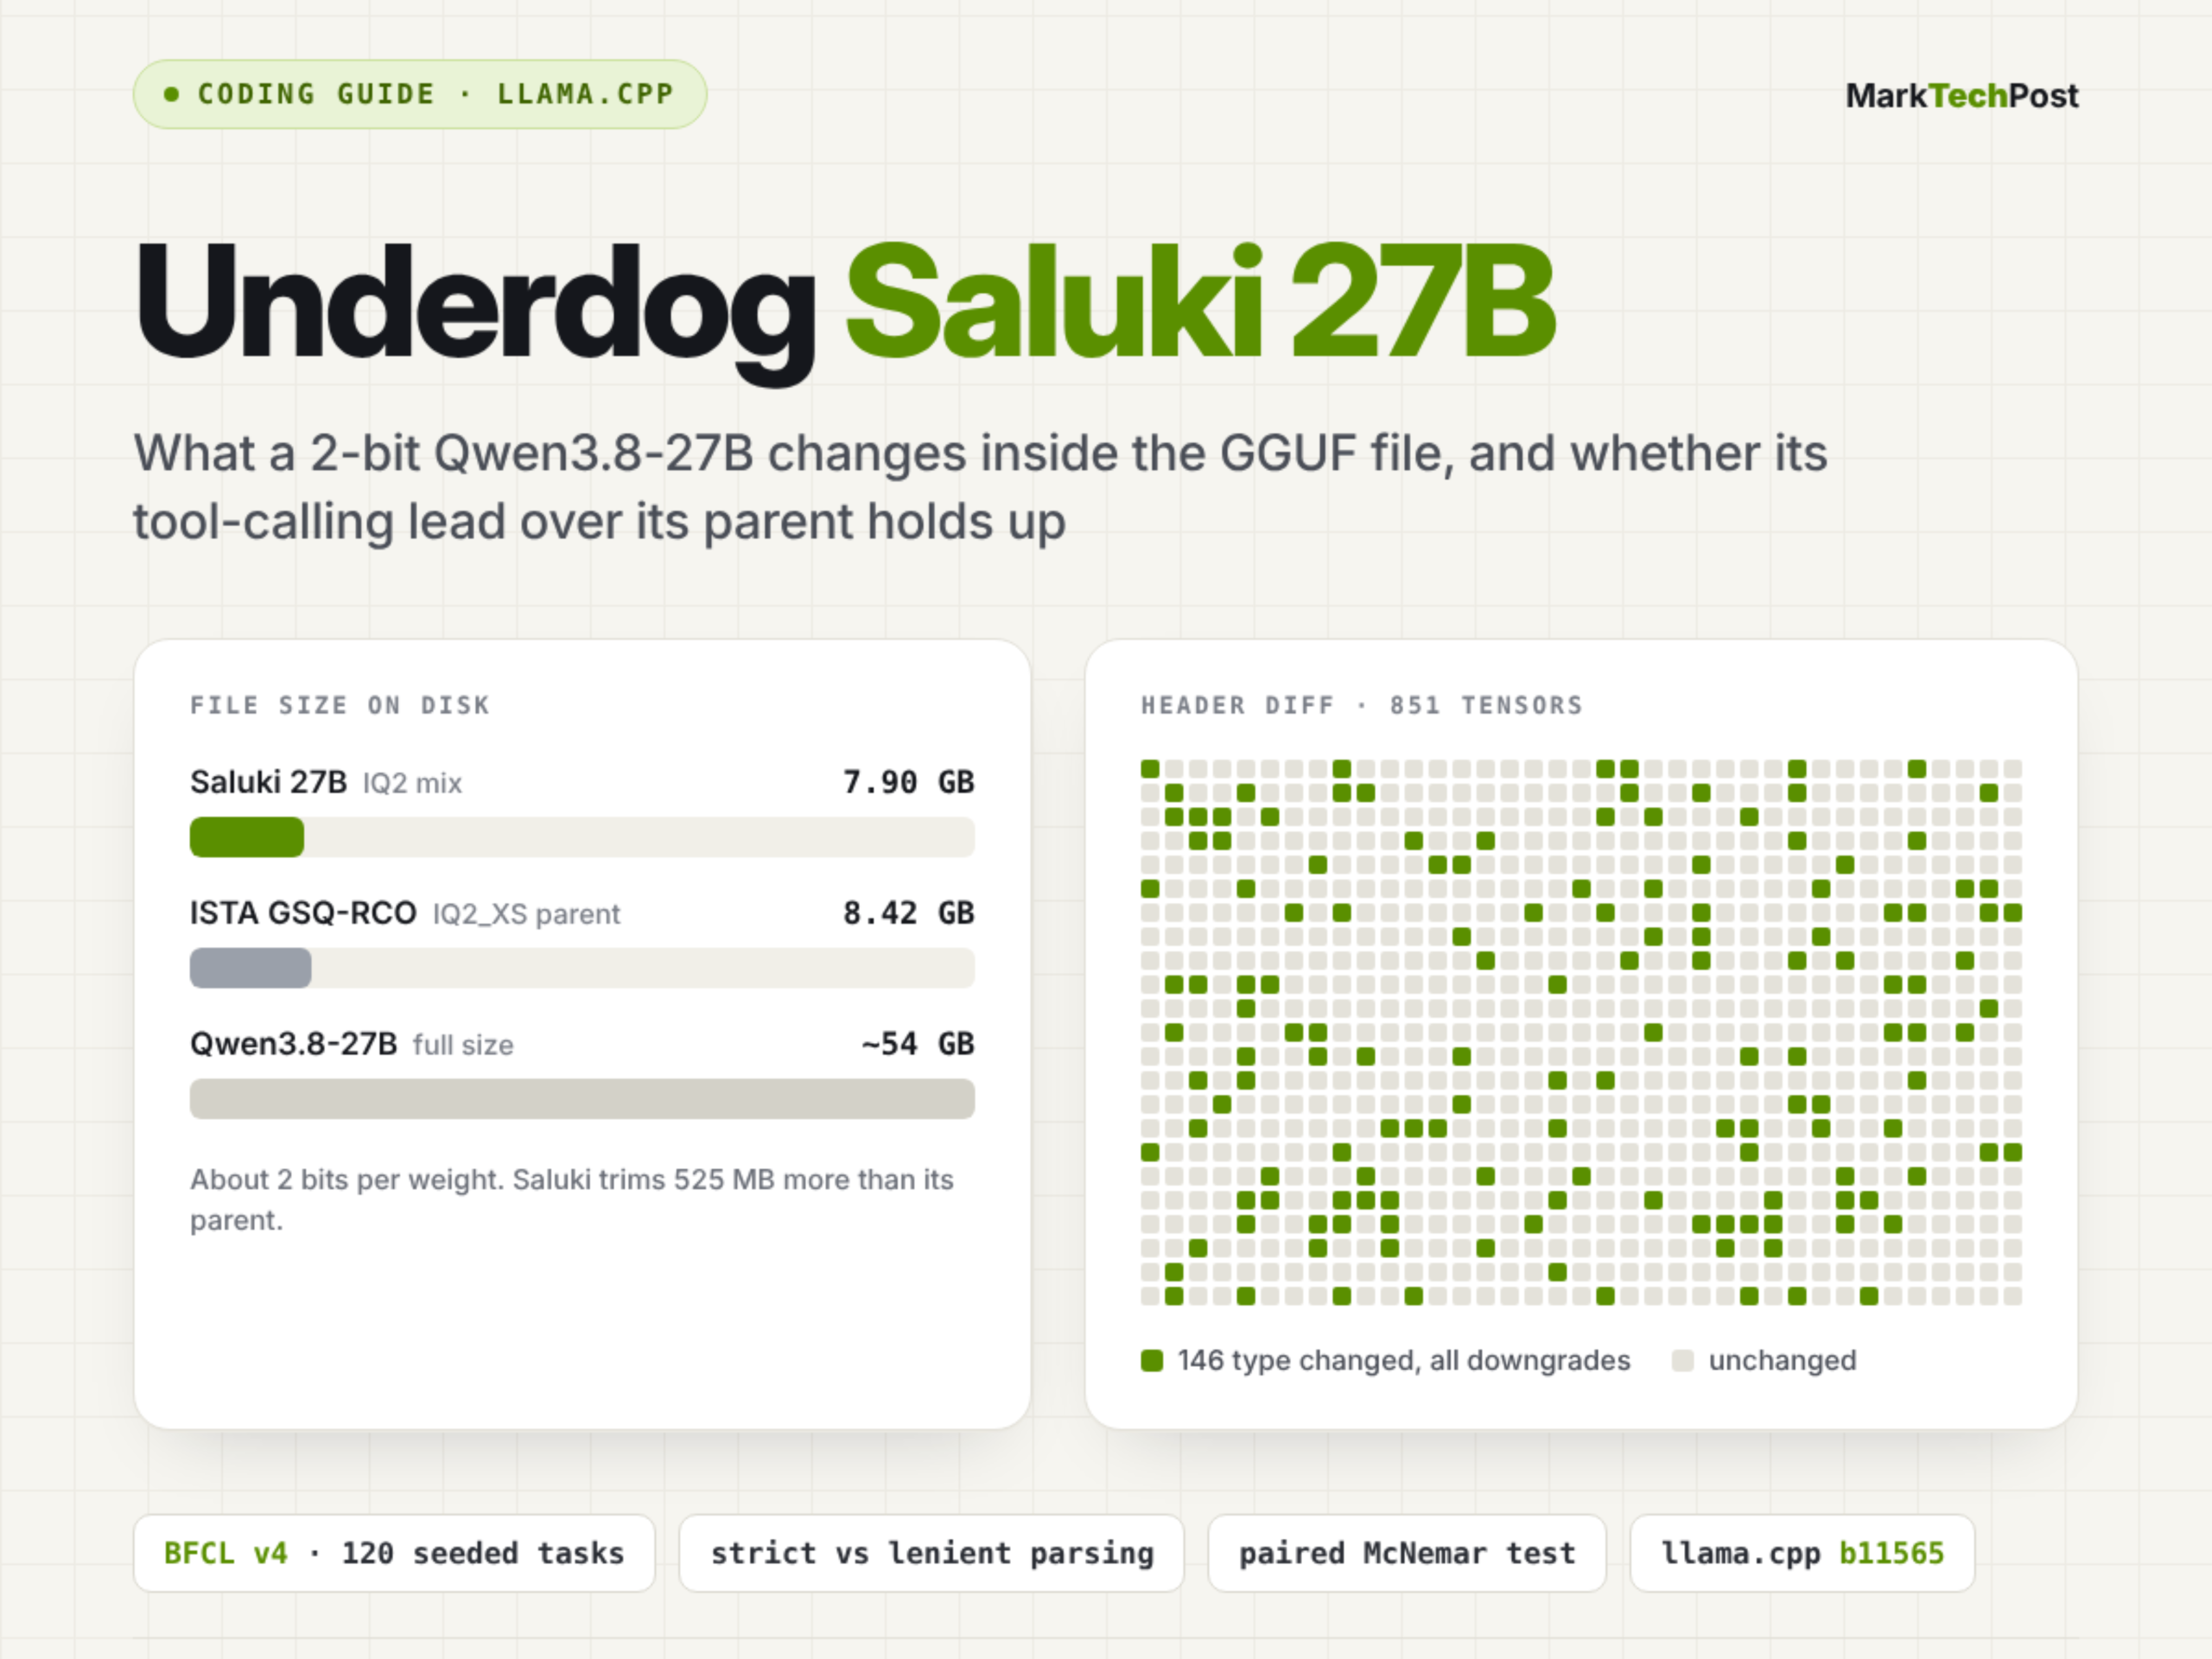
アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

セバスチャン・ラシュカが8本のビデオコース「ゼロから推論モデルを構築する」を公開しました

セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。

注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。

経緯と関連報道

CiteAnchor:幻影引用の検出と解決のためのソース意識型グラウンディング

arXiv:2610.30355v1 発表タイプ:新規 要旨:幻影引用は、科学的主張の背後にある証拠を追跡し、その信憑性を検証することを困難にします。これらの引用を検出するのは、書誌情報が不完全であったり、ソースの種類や出版物のバージョンによって異なるため、非常に難しいです。妥当な一致だけでは、その引用が正当化されるわけでも、その背後にあるソースが特定できるわけでもありません。私たちは、ソースの復元可能性について注釈付きで構築された、実世界の幻影引用423件からなるベンチマークであるCiteResolveを提案します。さらに、ソースごとに検索とフィールドレベルの検証を適応させ、引用の妥当性および固有のソースが復元可能かどうかを個別に判定する、ソース意識型グラウンディングフレームワークであるCiteAnchorを提案します。既存の検出ベンチマークにおいて、CiteAnchorはGPT-5.6を用いてF1スコア0.841を達成しました。

CiteAnchor: Source-Aware Grounding for Hallucinated Citation Detection and Resolution
経緯と関連報道

研究では、LLMが生成する合成調査の回答者カバー度を評価する新たな指標RCGを提案した

同論文は2026年10月24日、arXivに掲載され(番号2610.30900v1)、大規模言語モデル(LLM)が生成する合成調査回答者について、完全な回答プロファイル空間における実際の人類回答者のカバー度を測定する新たな評価指標「回答者カバレッジギャップ」(RCG)を提案している。

Silicon Samples Match the Answers but Not the Respondents

注目する理由:既存の評価手法は、単一設問の解答分布や設問間の相関にのみ着目しており、LLMが生成した回答者が実際の母集団に存在する解答組み合わせを再現しているかどうかを識別することはできません。RCGは初めて、全量の回答プロファイルに基づいてカバー不足を定量化し、米国の2つの社会調査データにおいて、テスト対象のすべてのLLMで顕著な未カバー層が存在し、しかもそれらの性能が単純なマージナルサンプリングのベースラインおよびガウス・コピュラモデルよりも劣っていることを実証しました。

経緯と関連報道

新たな研究でReflectPOフレームワークが提案され、大規模言語モデルエージェントの長期間タスクにおける自律的誤り訂正能力が向上しました

2026年10月24日、arXivは「ReflectPO:長周期LLMエージェント向けの反省誘導型戦略最適化」と題する研究論文(ID 2610.30933v1)を公開し、ツール強化型大規模言語モデルエージェントが複雑で多段階かつ状態依存型のタスクにおいて自律的に誤りを回復する能力を向上させるための、ReflectPOと名付けられた強化学習フレームワークを提案した。

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

注目する理由:本論文は、最近発表された最先端のAI研究であり、現在のLLMエージェントの実用化における重要な課題である、長期間にわたるタスクにおける初期段階での誤りの累積効果に焦点を当てています。著者が提案する「Reflection-Guided Sampling」と「Tree-Structured Credit Assignment」の二重構成による設計は、方法論的に革新的であり、二つのツール利用ベンチマークにおいて複数のベースラインを実証的に上回っており、技術的な参考価値を有しています。

経緯と関連報道

Amazon SageMaker AIがマルチラウンド強化学習(MTRL)フレームワークを発表し、エージェントによる多段階タスクのエンドツーエンド学習をサポートします

AWSはMulti-Turn Reinforcement Learning(MTRL)機能をリリースし、ユーザーはSageMaker AI上で、ステップ単位のアノテーションなしに、タスク全体の遷移と最終的な結果に基づいて大規模モデルエージェントを訓練できるようになりました。Wordleを例に、AgentCoreのデプロイ、データ準備、PPOトレーニング、報酬設計、コスト分析に至るまで、一連のワークフローを実演しています。

経緯と関連報道

AWS CDKによる再利用可能なコンストラクトの構築により、SageMakerエンドポイントのスケールアップ/スケールダウン更新におけるブロッキング問題を解決

SageMakerのリアルタイムAIエンドポイントがApplication Auto Scalingに登録されている場合、AWS CDKやCloudFormationでインスタンスタイプやインスタンス数などの設定を直接更新すると失敗します。本稿では、カスタムリソースに基づくCDK構築手法を提案し、厳密な依存関係によるオーケストレーションを通じて、エンドポイントの設定とスケーリングポリシーをアトミックかつ手動による更新不要で実現します。

経緯と関連報道

Amazon SageMakerがトレーニングセッションAPIをリリース:ユーザーは独自の大規模モデルの学習ループを記述でき、GPUの管理が不要になります

Amazon SageMakerは、Training Sessions APIをリリースし、ユーザーが純粋なPythonスクリプトでSFT、RLHF、GRPO、KTOなどのカスタム大規模モデルの学習ロジックを実装できるようにしました。GPUリソースのスケジューリング、フォールトトレランス、分散実行、およびチェックポイント管理はすべてサービスによってホストされます。

経緯と関連報道

Switch 2が古いゲームとAIを用いて脱獄に成功し、Modderが『Mario Kart World』のカスタムキャラクターを披露

The Vergeの報道によると、著名なModderであるSammy Hajhamid(ネット名:pepsipu)は、Nintendo Switch 2の脱獄に成功したと発表しました。彼のツール「ns2jb」はOpenAI Codexの支援を受けて開発され、古いゲームを利用して脆弱性を引き起こしています。デモ動画では、『Mario Kart World』がシナモロールや赤い怒りの鳥、ピーター・グリフィン、Minecraftのスティーブなど、非公式キャラクターを含む改造版で動作している様子が確認されています。

経緯と関連報道

欧州の複数の機関がNVIDIA Earth-2オープンソースモデルを導入し、地域に特化した天気予報および気候予測アプリケーションの推進を図っています

NVIDIAは、欧州向けのオープンソースAIモデルファミリー「Earth-2」を発表しました。これには、地域特化型の短時間予報モデル「StormScope EU」が含まれており、AXA、Vaisala Xweather、マンチェスター大学、TotalEnergiesなどの機関と連携して実際の運用環境での検証を実施しています。対象となるタスクには、暴風雨リスク評価、大気質モデリング、太陽光発電予測、およびレーダーによる地形復元などが含まれます。

経緯と関連報道