本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

中国が10機の衛星を打ち上げ、「天数天算」を実証:軌道上でのAI計算により、宇宙インテリジェントエージェント時代が幕を開ける

2026年10月14日、朱雀二号改型ロケット遥四号は10機の衛星を成功裏に打ち上げました。これには、国星宇航の「星算」計画02組の8機の演算能力衛星および藍塔智能の2機の光伝送試験衛星が含まれており、衛星による軌道上AI推論、衛星間レーザー通信、万ワット級液冷式熱放散などの重要技術が初めて大規模に実証されました。今回の打ち上げ時点で、「星算」星座の軌道上総演算能力は50Pに達し、中国における宇宙演算ハブの構築が実質的に具体化したことを示しています。

注目する理由:本資料は、钛媒体が許諾して公開した業界の深層報道(2026年10月26日掲載)に基づいて作成されており、内容は直近に完了した宇宙ミッションおよび検証可能な技術進展に焦点を当てています。時間・主体・搭載物・計算能力の数値・検証方向といったすべての重要な事実については、文中で明示的に述べられており、さらに中国中央テレビニュース、科技日報、公式試験ノードなど公的信頼源とも相互に照合されています。なお、本件は現時点(2026年10月14日)以前に発生しており、時効性と実証的根拠を備えています。
経緯と関連報道

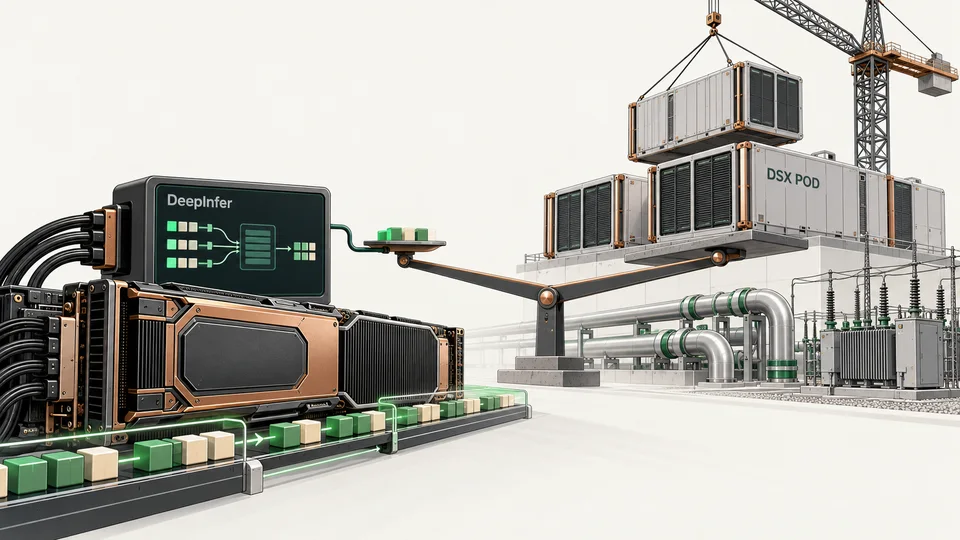
低価格のスマートさと高価な野心:DeepInfer、DSX POD、そしてAIへの投資拡大

第958号『The Sequence Radar』では、推論ソフトウェア、モジュール型AI工場、そして企業向けAIへの投資を一堂に集めて考察しています。単回の推論コストが安くなったからといって、業界全体の総投資額が必ずしも低下するわけではありません。本稿は元記事をそのまま整理し、DeepSeekおよびNVIDIAの公式資料を用いて技術範囲と納品条件を補足しました。

推理软件效率与模块化AI基础设施投入的编辑示意,非实际产品照片
経緯と関連報道

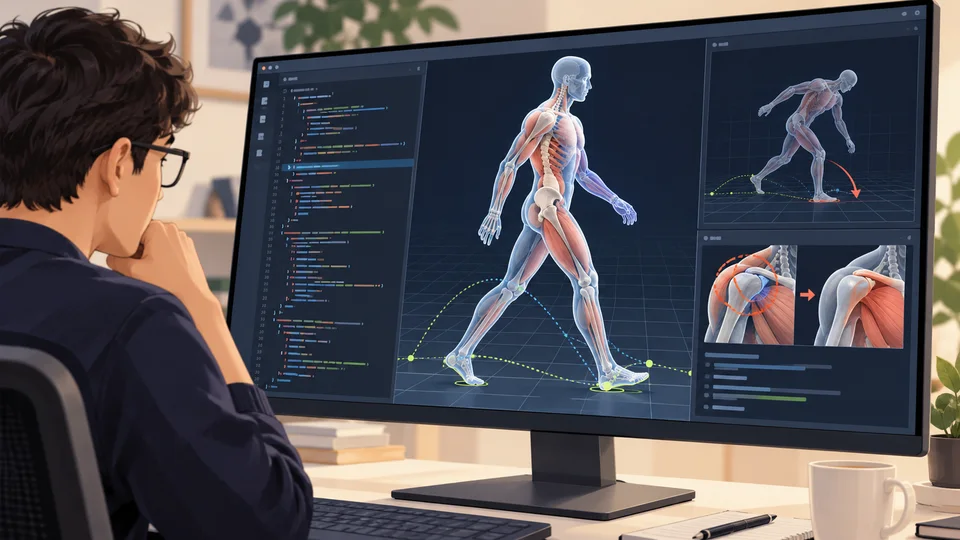
KimiがK3.1 Proを発表:エンドポイントタスク能力がトップに躍進、シミュレーションによるデバッグとマルチモーダルプログラミングにより具現知能の原型を示す

Kimiは2026年10月25日にK3.1 Proモデルを発表し、Terminal-Bench 4.0のタスクテストにおいて成功率67.2%で首位に立った。また、エミュレーターのバグを自律的に修正し、物理シミュレーション、音声解析、3Dシーン構築、動画編集といった多様なタスクをこなす能力を備えており、身体拡張型知能技術の道筋を探る方向性を示している。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

注目する理由:本資料は、钛媒体が許諾して公開した実測レポートに基づいており、Artificial Analysis、Terminal-Bench 4.0 などの権威ある第三者評価データ、公式による自主テスト結果、ならびに著者による多様なシーンにおける機能検証を網羅しています。K3.1 Pro の実行性能、シミュレーションのクローズドループ、マルチモーダルプログラミングにおける実質的な進歩に焦点を当てるとともに、性能上の限界や未公表の情報(例:Flash/Ultra はまだリリースされていない)についても明示しており、事実確認および出典表示の要件に準拠しています。

経緯と関連報道

パネルメーカー各社は、AIによる上流コストの圧迫に対応するため一斉に価格を引き上げているが、下流の受け入れ度は低く、端末製品の品質管理にも圧力がかかっている

2026年9月以降、TCL華星、京東方、惠科などのパネルメーカーが相次いで値上げ通知を発表しています。その主な要因は、AI大規模モデルの発展に伴うHBM需要の急増により、成熟プロセス向け半導体の生産キャパシティが逼迫し、ドライバIC、PCB、ガラス基板など主要部材の価格が上昇していることです。同時に、コーニングをはじめとする上流サプライヤーも一斉に価格を引き上げています。コスト面での圧力は明確ですが、下流のテレビ/ディスプレイブランドによる調達価格は広く値上がりしておらず、端末ユーザーからは過熱やブラックスポットといった品質管理上の問題が頻発しているとの不満が寄せられています。そのため、値上げはまだ実際の取引価格の上昇や体験の向上には反映されていません。

AI大模型狂飙,面板行业也扛不住了

注目する理由:材料システムは、AI産業が直接的な関連性のないハードウェア業界に及ぼすクロスチェーンによる伝播メカニズムを明らかにした——AIによるパネル需要の押し上げではなく、ウェハ生産能力の再配分を通じて全チェーンにわたるコストの再設定が引き起こされているのだ。同時に、価格上昇の動きと市場の実際の反応(価格の硬直化、出荷の減少、ユーザーからの苦情)との間に顕著な乖離が存在することも示しており、産業における交渉力と製品力の不一致という深い矛盾を浮き彫りにしている。

経緯と関連報道

llama.cpp が b11870 バージョンをリリースし、DeepSeek-V4.1-Flash モデルを正式にサポートしました

llama.cppはバージョンb11870において、DeepSeek-V4.1-Flash(deepseek41)モデルへの対応を追加し、そのEngramアーキテクチャに対してKVキャッシュ計算の簡略化、BF16精度によるMXFP8代替、in-graph行gatherなど、複数の低レベル最適化を施しました。同時に、macOS、Linux、Windows、Android、iOSおよびopenEulerを網羅するマルチプラットフォームのバイナリビルドも提供しています。

経緯と関連報道

llama.cpp が b11865 バージョンをリリース:RDMA 受信の境界チェックを追加し、CUDA 13.4、ROCm 10.0、Snapdragon NPU など、複数のプラットフォーム向けバックエンドをサポート

llama.cpp プロジェクトはビルドバージョン b11865 をリリースし、主要な変更点として、RDMA 受信ロジックにメモリ境界チェックを追加(PR #30399)するとともに、ハードウェアアクセラレーションのサポートを大幅に拡張しました。これにより、CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL、さらに Qualcomm Snapdragon(CPU+Adreno+Hexagon)によるフルスタックの異種計算バックエンドが対象となります。なお、macOS における KleidiAI のサポートおよび openEuler 上でのビルドは、明示的に DISABLED とマークされています。

経緯と関連報道

llama.cpp がバージョン b11861 をリリース:minimax-m3 モデルの量子化スケーリングテンソルが伝達されないことで生じる推論エラーを修正

llama.cpp v.b11861 では、minimax-m3 モデルにおいて NVFP4/MXFP8 の量子化下でスケールテンソルが計算グラフに注入されないために生じていた重みの歪み問題を修正し、『token soup』や残差の埋没を回避しました。また、macOS、Linux、Windows、Android、iOS、openEuler を網羅するマルチプラットフォーム対応のバイナリビルドも同時に提供されています。

経緯と関連報道

セバスチャン・ラシュカが8本のビデオコース「ゼロから推論モデルを構築する」を公開しました

セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。

注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。

経緯と関連報道

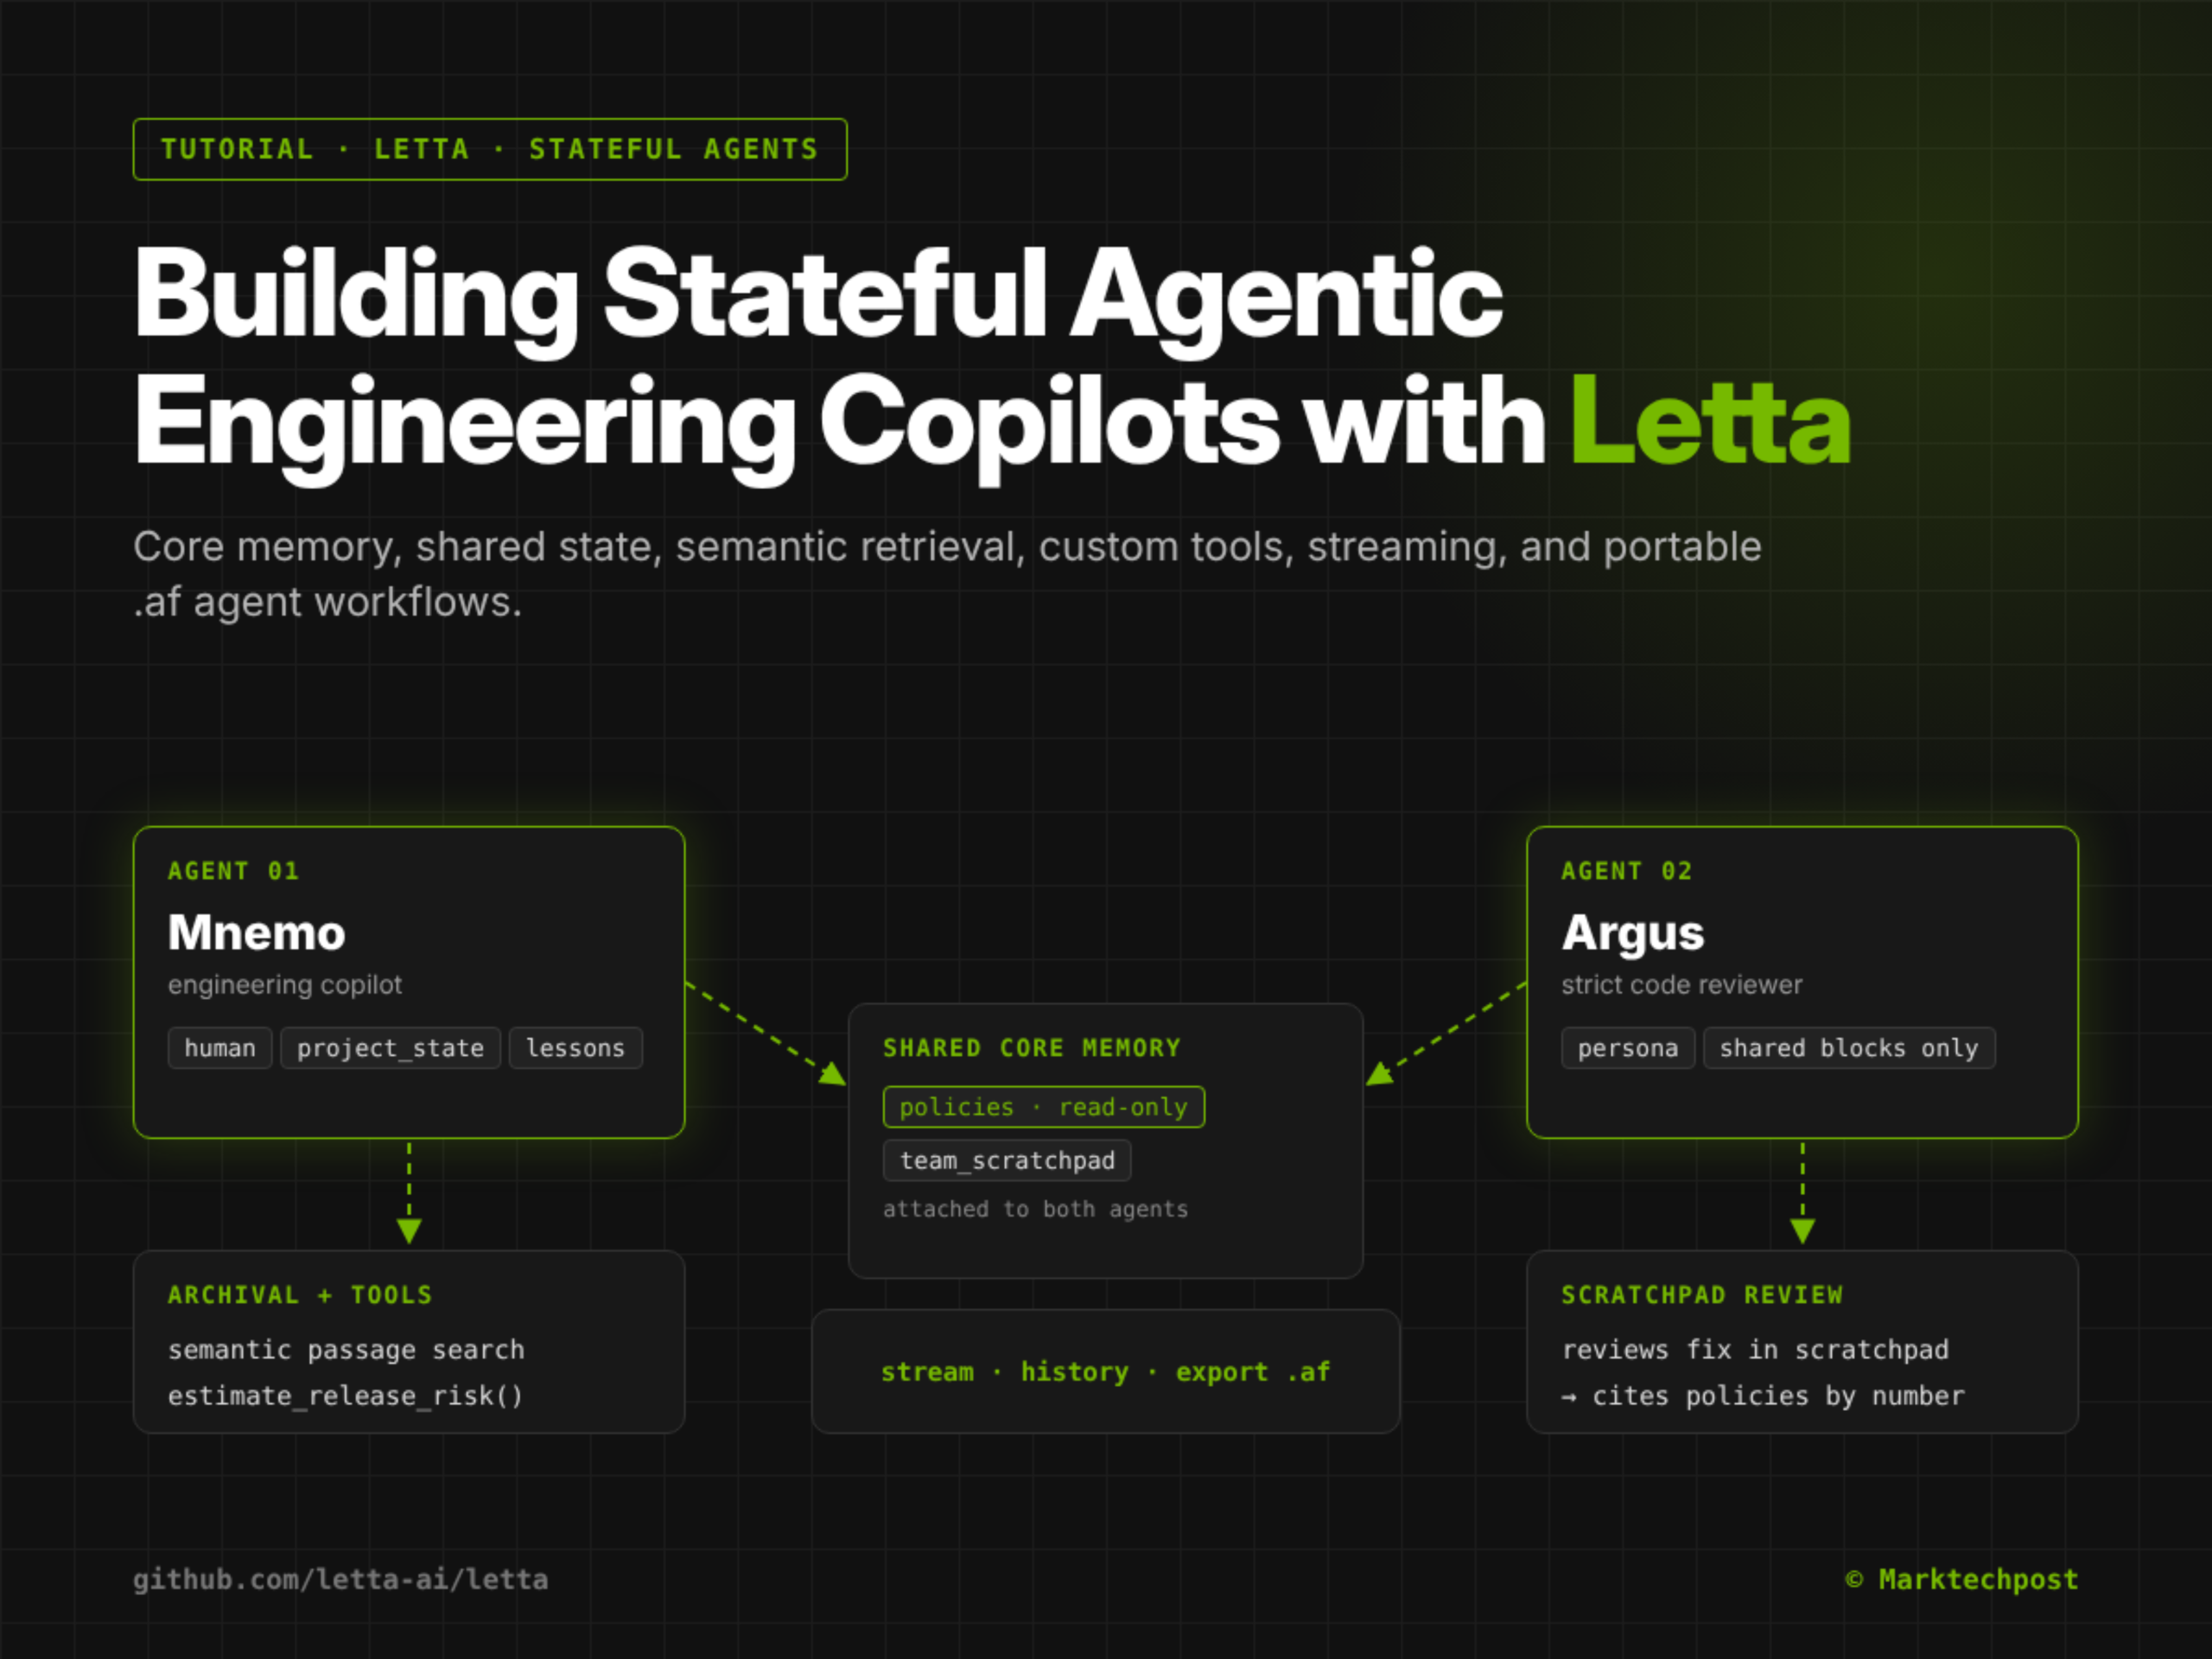
Lettaプラットフォームが、ステートフルなエンジニアリングにおける共同作業者向けの構築チュートリアルを公開:コアメモリ、共有状態、およびポータブルなワークフローをサポート

MarkTechPostは2026年10月24日、Lettaフレームワークを基に永続的状態を備えたエンジニアリング協働者(agentic copilot)を構築する方法を紹介するチュートリアルを公開しました。内容には、検証可能なコアメモリ、マルチエージェント間の共有メモリ、セマンティック検索による知識のアーカイブ、カスタムPythonツールの統合、ストリーミング応答、および .agent形式(.af)でのエクスポートといった機能が含まれます。本稿は技術実践ガイドであり、性能指標やセキュリティ監査、あるいは本番環境での検証については提供されていません。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
経緯と関連報道

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed
経緯と関連報道

ULMEフレームワークは、テキスト埋め込みと言語モデリングを真に統合する:arXivの新論文が予測結合メカニズムを提案

2026年10月24日、arXivは論文arXiv:2610.30705v1を公開し、因果推論型デコーダーに基づく大規模言語モデル向けの後訓練フレームワークであるULMEを提案しました。この手法は、予測的結合(predictive coupling)メカニズムを用いることで、テキスト埋め込みと言語生成能力を相互に強化しつつ統合することを初めて実現しました。本手法はQwen2.5/Qwen3シリーズ(0.5B~8Bパラメータ)において有効性が確認されており、MTEBスコアで3.3~4.1ポイントの向上を達成するとともに、生成タスク(MMLUなど)の性能も低下させませんでした。

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

注目する理由:本論文は、現在の多モーダルLLMにおける能力の断片化という核心的な問題を正面から指摘している。すなわち、埋め込みと生成は長らく独立したモデル、あるいはパラメータのみを共有する“疑似統一”モデルによって担われてきた。ULMEは、学習可能なスロットと三目標による共同学習(ストップグレード付き予測損失を含む)により、生成プロセスが埋め込み表現を能動的に形成する仕組みを実現しており、アーキテクチャレベルでの実質的な飛躍である。実験の範囲は広く、ベースラインも強力で、評価指標も網羅的であり、さらに権威あるプレプリントプラットフォームに公開されているため、タイムリーさと技術的厳密性の両面を備えている。

経緯と関連報道

LLM評価における集約スコアは個々の判定の不安定性を隠す:Arena-Hardによる新たな研究が指示に対する感度を明らかにした

本研究では、Arena-Hard v2.0のプロンプト500件を用い、2つのモデルによる回答を固定したうえで、GPT-4.1を審判として8種類の指示組み合わせ下で繰り返し評価を行った。その結果、集約スコアの変動がわずか(例えば±1ポイント)であっても、個々のプロンプトごとの判定結果(勝/引き分け/敗)が最大21.2%で変化することが明らかになった。さらに、指示の調整により不安定性は一層拡大し、最大で28.2ポイントもの追加の判定変動が生じる一方で、集約スコア自体はほとんど変化しない場合もあることが示された。

Behind Aggregate Scores: What Systematically Varying Arena-Hard's LLM Judge Reveals

注目する理由:本研究は、現在のLLM評価実践における核心的な盲点——集約スコアへの過度な依存と、個々の判定の再現性および指示依存性の無視——に鋭く切り込み、嗜好モデリングやヒューマン・フィードバック強化学習(RLHF)など、細粒度の判定を必要とするタスクに対して重要な方法論上の警鐘を提示する。

経緯と関連報道

研究では、自己評価強化学習フレームワークSARLを提案し、検索拡張型大規模モデルの探索状態認識能力を向上させました。

2026年10月24日、arXivは論文arXiv:2610.30435v1を公開し、既存の検索強化型大規模言語モデルにおいて、検索エージェントが検索状態を認識する能力を欠いているという問題を解決することを目的とした、自己評価強化学習(SARL)フレームワークを提案しました。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

注目する理由:本研究は、検索強化型大規模言語モデルが複雑なタスクにおいて、既知または欠落した情報を認識できないことから生じるハルシネーションによる推論や探索の早期終了という重要な課題に対し、テスト時の追加評価を必要としないエンドツーエンドの強化学習手法を提案し、マルチジャンプ推論および深層研究のベンチマークにおいて顕著な性能向上を実現しました。

経緯と関連報道

ツール強化型言語モデルのプロンプト感度に関する研究:ツールは精度を向上させる一方で、表現の差異による影響を悪化させる

2026年10月24日付でarXivプラットフォームに掲載された研究(番号2610.31148v1)は、ツール強化条件下において、6種類のオープンソース言語モデルについて、5つの分野および5種類の質問表現に対する比較安定性が向上しなかったことを指摘している。むしろ、ツールによってプログラムが回答可能な質問の正確率は向上したものの、表現の違いに伴うモデル間ランキングの変動に対する感度は拡大した。

Prompt Sensitivity in Tool-Augmented Model Comparisons

注目する理由:本研究では、新たに設計されたマッチングプロトコルを用い、ツール呼び出しの全プロセスにおける重要な段階(たとえば呼び出しの意思決定、ツールの応答、非呼び出しレポートなど)を分離することで、実証的に「精度の向上」が必ずしも「より安定した比較」を意味しないことを明らかにしました。さらに、インターフェース設計および命令の細部が感度の程度を顕著に調整することを示し、モデル評価の実践に対して直接的な指針となる価値を有しています。

経緯と関連報道

RIFTは、動的なKVキャッシュ圧縮戦略を提案し、デコードの古さによる問題を緩和して、推測デコードの品質を向上させます。

2026年10月24日、arXivは論文arXiv:2610.31098v1を公開し、RIFT——推測デコードにおけるドラフトモデル(drafter)向けの動的KVキャッシュ圧縮手法——を提案しました。この手法は、事前埋め込み情報と新規生成トークンのバランスを取るとともに、圧縮可能性を考慮した訓練を組み合わせることで、8KトークンのKVキャッシュ予算のもと、Qwen3.5-4BのドラフトモデルがQwen3.5-122Bに対して長文コンテキスト生成を実行する際に、全キャッシュの受け入れ可能な長さを98%超に維持することを可能にします。

RIFT: KV Cache Compression for Draft Models with Complementary Compressibility Training

注目する理由:本研究は、長文出力生成においてKVキャッシュの膨張がもたらすハードウェアコストの増大と精度低下という矛盾に正面から取り組み、『デコードの陳腐化』(decode staleness)現象を初めて明確に定義・定量化するとともに、実装可能な更新メカニズムと学習との協調手法を提案している。実験条件は具体的で(入力32K/出力4K/キャッシュ8K)、得られた結果は工学的な参考価値が高い。出典はarXivのプレプリントであり、公開日時(2026年10月24日)はシステムの現在日付(2026年10月25日)と一致しており、高いタイムリー性を有している。

経緯と関連報道

新たな研究により、推論時のコンテキスト強化手法の効果に疑問が生じている:精度向上は単なるランダムな擾乱による可能性も

2026年10月24日付でarXivに掲載された(番号2610.30983v1)AI研究論文では、推論時の文脈強化手法5種類を体系的に評価し、報告された精度向上が必ずしも実際の能力向上を反映しているわけではなく、むしろ無方向性の擾乱によるものである可能性があることを明らかにした——すなわち、一部の予測は修正される一方で、他の予測は損なわれるという結果である。

A Reality Check of Inference-Time Context Augmentation Methods

注目する理由:本論文は、手法・モデル・データセットを横断する統一的な評価フレームワークを初めて構築し、性能向上のみに依存すると信頼性の欠陥が隠されやすいことを指摘しています。特に、フィラートークン型の手法(新たな情報を導入しない手法)は、意思決定境界付近の予測を主に乱すため、実際の運用への直接適用には適さないことを警鐘しています。

経緯と関連報道

Protegrity-PII:新しいPII識別モデルがリリースされ、構造化テキストおよび非構造化テキストをサポートします

2026年10月24日、研究チームはarXiv(ID 2610.30518v1)にProtegrity-PIIモデルを公開しました。これは個人識別情報(PII)の識別を対象とした新しい意思決定モデルであり、新たなベンチマークであるPII-SCOPEにおいて、タイプ別リコール率0.915、精度0.907を達成しています。推論速度は0.49秒/百万文字で、コストはわずか0.0005ドル/百万文字(単一RTX 6000、バッチ処理時)です。

Protegrity-PII Technical Report

注目する理由:この技術報告書は、定量的な性能指標、明確なハードウェアおよびコスト条件、新たに提案されたベンチマークPII-SCOPE、ならびに分布外一般化能力に関する実証的比較を提供しており、研究の透明性と工学上の参考価値を備えています。公開日時(2026年10月24日)は現在時刻(2026年10月26日)より遅くなく、有効な近時の成果に該当します。

経緯と関連報道

研究では、自己回帰型の大規模モデルによる制御を戦略的に正確な並列推論へとコンパイルし、階層型RAGの効率を向上させる手法が提案されています。

2026年10月24日付でarXivに掲載された研究論文(ID 2610.30664v1)は、階層型検索強化生成(Hierarchical RAG)における大規模言語モデルの自己回帰制御ロジックを、ポリシー厳密(policy-exact)な並列推論フローへとコンパイルする新手法を提案しており、MetaXデバイス上で制御遅延を35~47%低減しつつ、同時に84~89%のポリシー一貫性を維持しています。

Compiling Autoregressive LLM Control into Policy-Exact Parallel Inference for Hierarchical RAG

注目する理由:本成果は、LLMを構造化された意思決定コントローラとして用いる際に広く見られる、逐次的なテキストデコーディングに依存するボトルネックに対し、理論的に証明可能な並列化コンパイル手法を提案しています。実験は実機(MetaX、H800)および複数のデータ分割を用いて検証されており、高い効率性と明確な技術的詳細を備え、最先端の信頼性あるAIシステムの最適化に関する研究です。

経緯と関連報道

FusionEvalの公開:大規模言語モデルの統合に向けた新たなベンチマークテスト

2026年10月24日、研究者はarXivに論文arXiv:2610.30162v1を公開し、大規模言語モデルの融合手法の評価に特化した初の統一ベンチマークであるFusionEvalを提案しました。同ベンチマークは、推論チェーンの長さやツール呼び出しといった脆弱な部分を網羅しており、学習型と非学習型の融合手法の比較も可能にしています。

FusionEval: Benchmarking Model Fusion for Large Language Models

注目する理由:このベンチマークは、既存の評価において長鎖推論とツール利用へのカバーが不十分であった点を補完し、平均性能と最悪時の能力保持を明確に区別するとともに、Qwen3/Llamaに基づく再現可能な専門家プール、GPUメモリや実行時間などの多次元指標、およびオープンソースコードを提供しており、高い実践的指導性を備えています。

経緯と関連報道

研究では、特異値スペクトルによる介入を通じて大規模言語モデルの能力分布を調整する手法を検討しており、LlamaおよびQwenモデルに対する実証分析を行っています。

2026年10月24日付のarXiv(番号2610.30676v1)に掲載されたあるAI研究では、5種類のオープンソースLlamaおよびQwenの指令微調整モデルに対して、後処理として特異値スペクトルの平滑化と尖鋭部の摂動を施したところ、この軽量な介入が、事実知識、言語理解、演繹的推論という3つの能力に関する性能のトレードオフを体系的に再構築することを明らかにしました。

Spectral Smoothing and Spiking Perturbations Reconfigure Capability Profiles and Selective Task Performance in Large Language Models

注目する理由:本論文は、マルチモデル・マルチタスクのフレームワークにおいて、トランスフォーマーの前馈層の特異値スペクトル構造が下流の能力に与える因果的影響を実証的に初めて検証し、能力配置の構造的な敏感性に関する法則を明らかにすることで、モデルの能力のデカップリングおよび制御可能な編集に新たな道筋を提供しました。すべての結論は公開モデルと標準的な評価に基づいており、手法は透明で、評価の次元も網羅的です。

経緯と関連報道