
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

Transformer理論の検証

arXiv:2610.32104v1 発表タイプ:新規 要旨:トランスフォーマー アーキテクチャの能力と限界を特徴付けるため、複数の形式理論が提案されており、それぞれがアーキテクチャの異なる側面を捉えるために異なる抽象化手法を用いている。これらの理論は、その基礎となる仮定や概念的枠組みに違いがあるため、トランスフォーマーにとってどのタスクが容易でどのタスクが困難かという予測において一致しないことがある。本研究では、トランスフォーマーの能力に関する7つの理論(Star-free、$\mathsf{AC}^0$、$\mathsf{TC}^0$、C-RASP、MPC、BAPO、および Sensitivity)を整理し、それらの結果を、異なる計算構造を網羅する一連のタスクに対する共通の予測マトリックスへと変換した。さらに、このマトリックスを完成させるための新たな理論的成果を提示する。その後、理論的な評価を行った
経緯と関連報道

LazyFlash:長文コンテキストの高速微調整のための前方は密集、後方は疎なアテンション

arXiv:2610.31911v1 発表タイプ:新規 要旨:大規模言語モデル(LLMs)がますます長いシーケンスを処理するにつれ、アテンションは主要な計算上のボトルネックとなっています。疎なアテンション手法は主に推論段階での利用を対象としていますが、多くの手法は依然として密集型で学習を行ったり、疎な学習に対応できなかったりします。さらに、その追加の複雑さにより、疎さを実際の実行時間の短縮へと結びつけることが難しく、結果として実用的には密集型アテンションが広く用いられています。本論文では、アテンションの学習は後方パスが支配的であるという観察に基づき、前方パスを完全に密集型に保ちつつ、後方パスを疎にするLazyFlashという手法を提案します。LazyFlashは前方パスを厳密に密集型に維持するため、学習済みモデルは従来の密集型モデルのままであり、vLLMなどの既存システムでも一切変更なしにサービス可能です。一方、後方パスについては、LazyFlashは勾配を…

経緯と関連報道

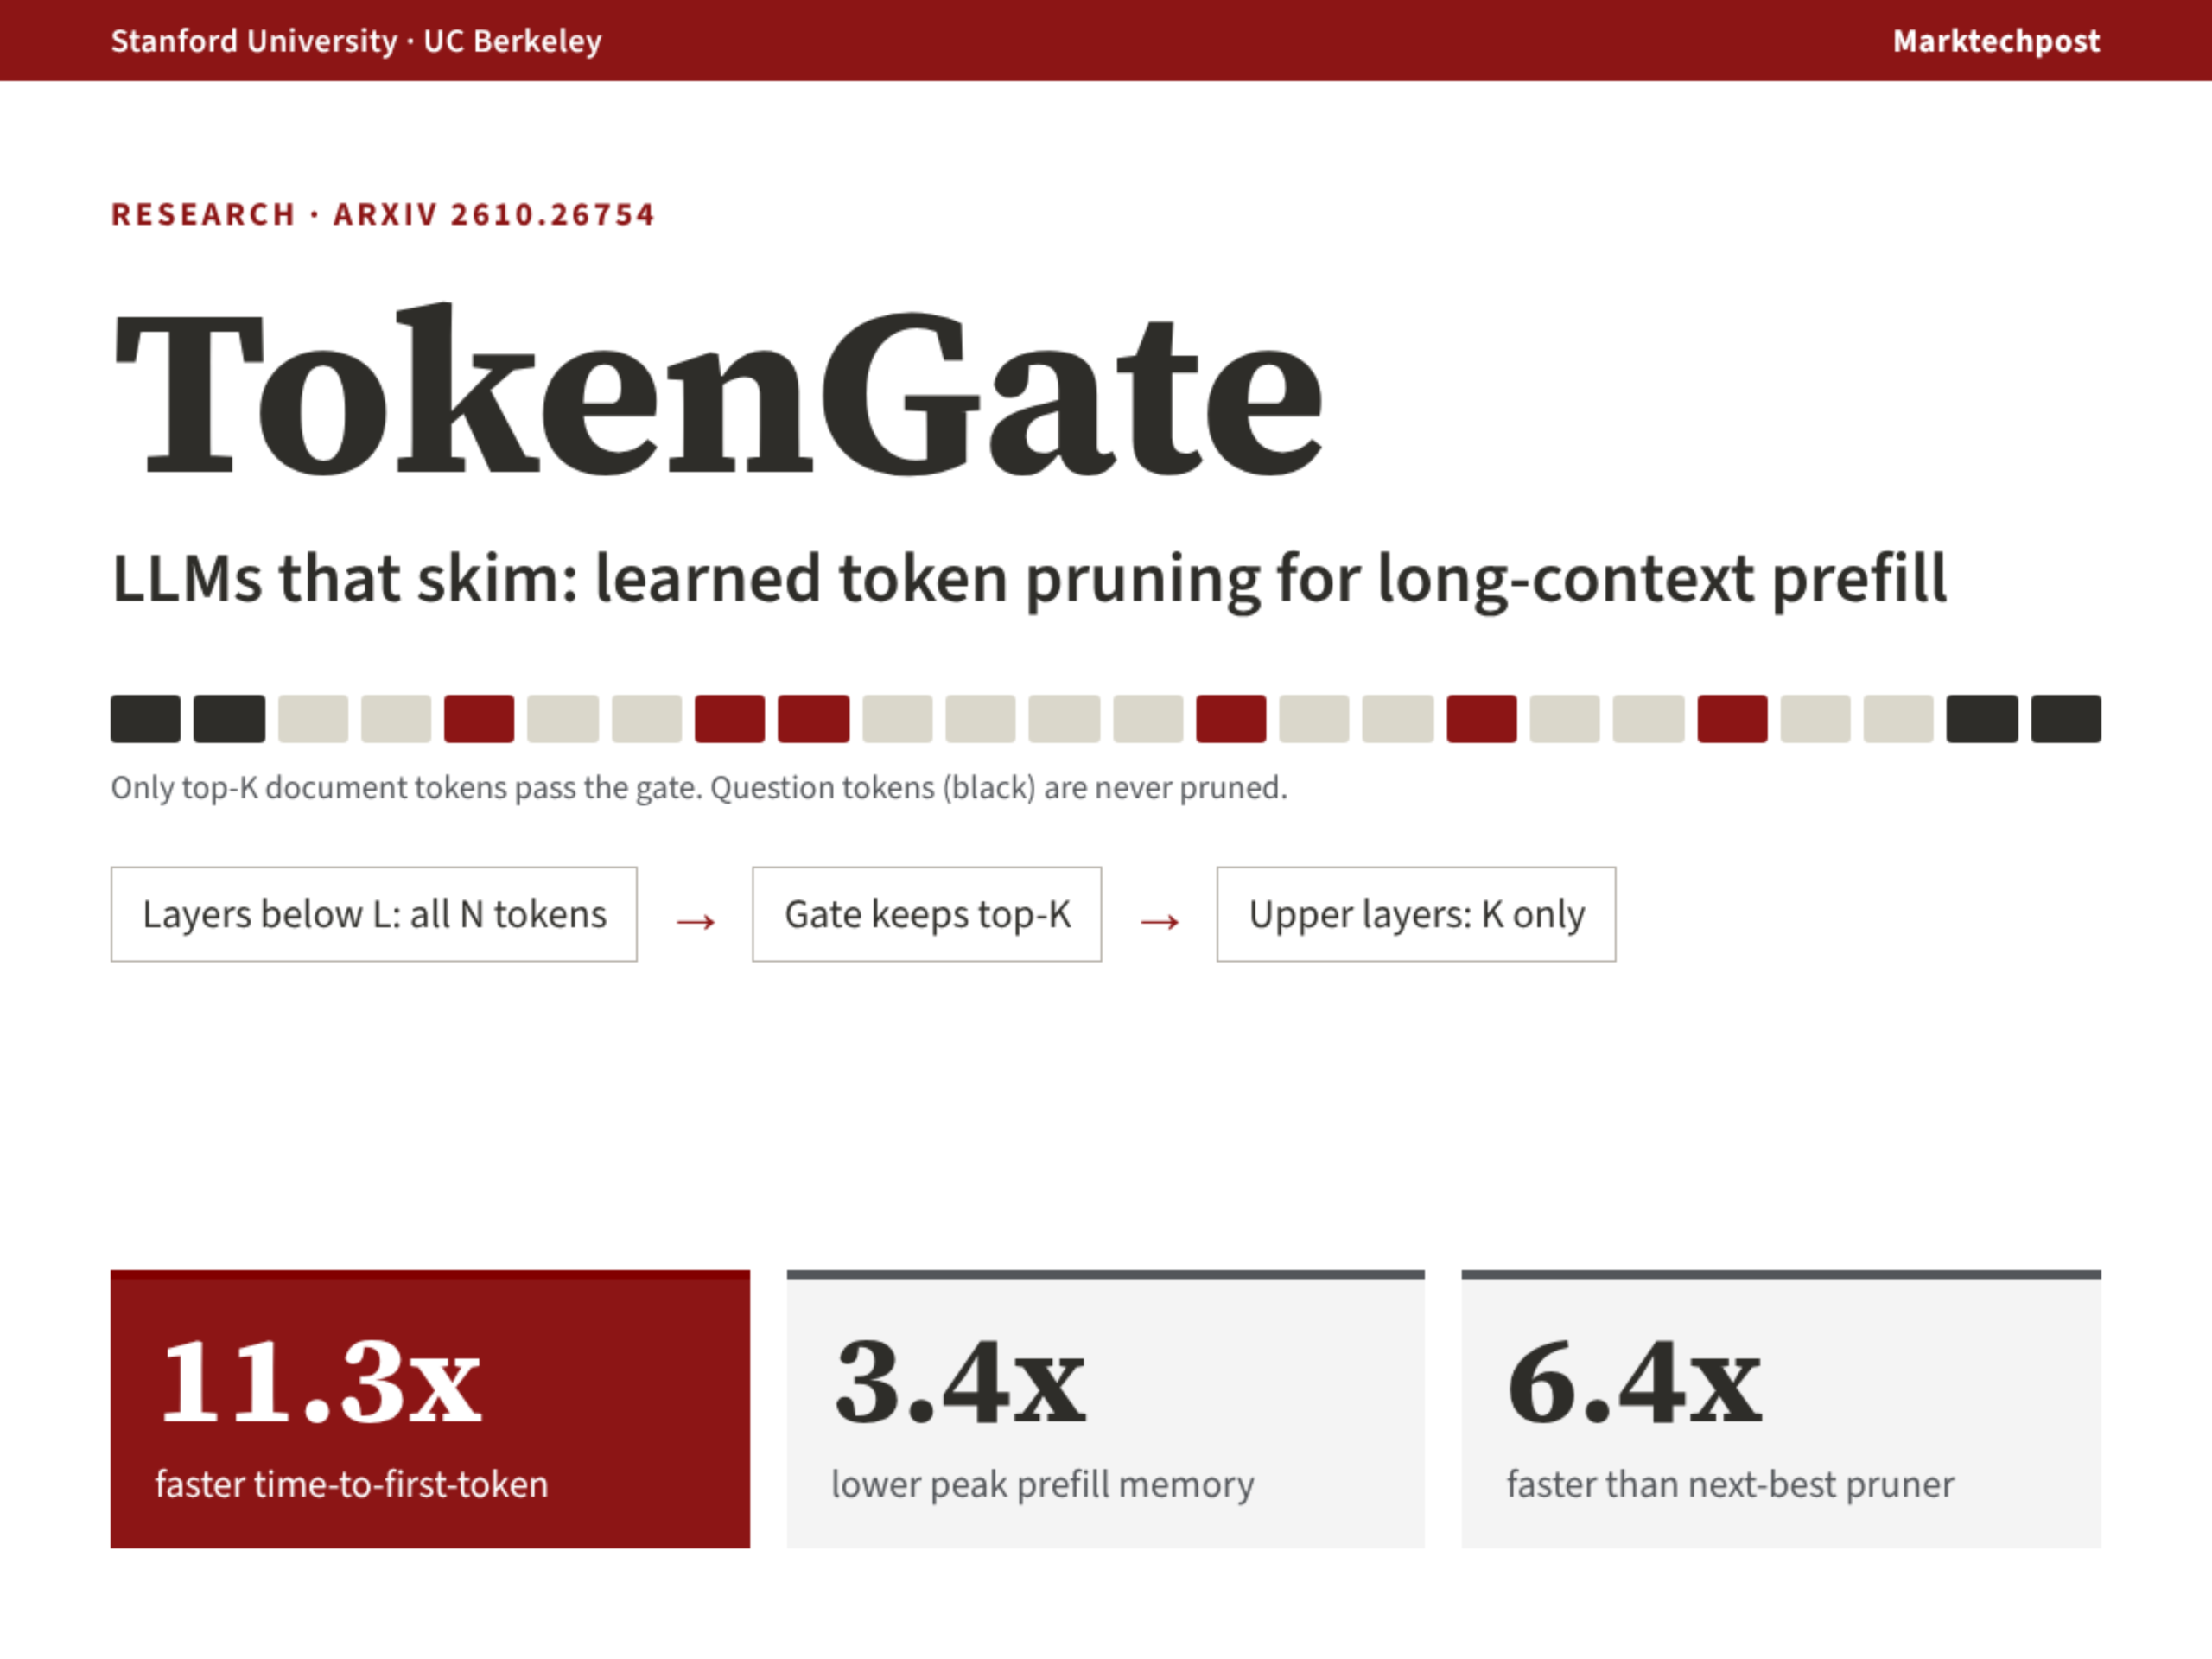
スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

低資源言語における研究の進捗と言語的包摂の測定

arXiv:2610.30296v1 発表タイプ:新規 要旨:大規模言語モデル(LLMs)は、低資源言語および多言語NLPに関する研究を加速させてきたが、公平な研究環境の実現にどの程度寄与しているかについては未だ明らかになっていない。本研究では、2020年から2025年にかけて公開された査読付きオープンアクセス論文1,158件を対象に、低資源言語(LRLs)への研究関心や、言語・話者集団間の代表性を分析した。出版数以外の観点から言語的包摂を評価するため、研究成長、代表性拡充、代表性継続性、分布的公正性の4つの次元で言語的包摂を測定する多次元フレームワーク「言語的包摂フレームワーク(LIF)」を提案する。年間の論文数は52件から415件へと5.4倍に増加した一方で、ACLアンソロジーにおける

Measuring Research Progress and Linguistic Inclusion in Low-Resource Languages
経緯と関連報道

PyTorch 2.15 は MPS を正式にサポート:FP8、MoE の高速化、および Metal カーネルが全面的にアップグレードされました

PyTorch 2.15 は、Apple Silicon Mac に重大な MPS バックエンドのアップグレードをもたらし、macOS 上で初めて FP8 テンソル演算をネイティブにサポートします。また、MoE モデルのデコード速度が 5~6.5 倍に向上し、ビデオ VAE のデコードにおけるピークメモリ使用量は 270 GiB から 8 GiB へと大幅に削減され、さらに多数のオペレーターが MPSGraph から専用の Metal カーネルへ移行されました。

経緯と関連報道