
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。
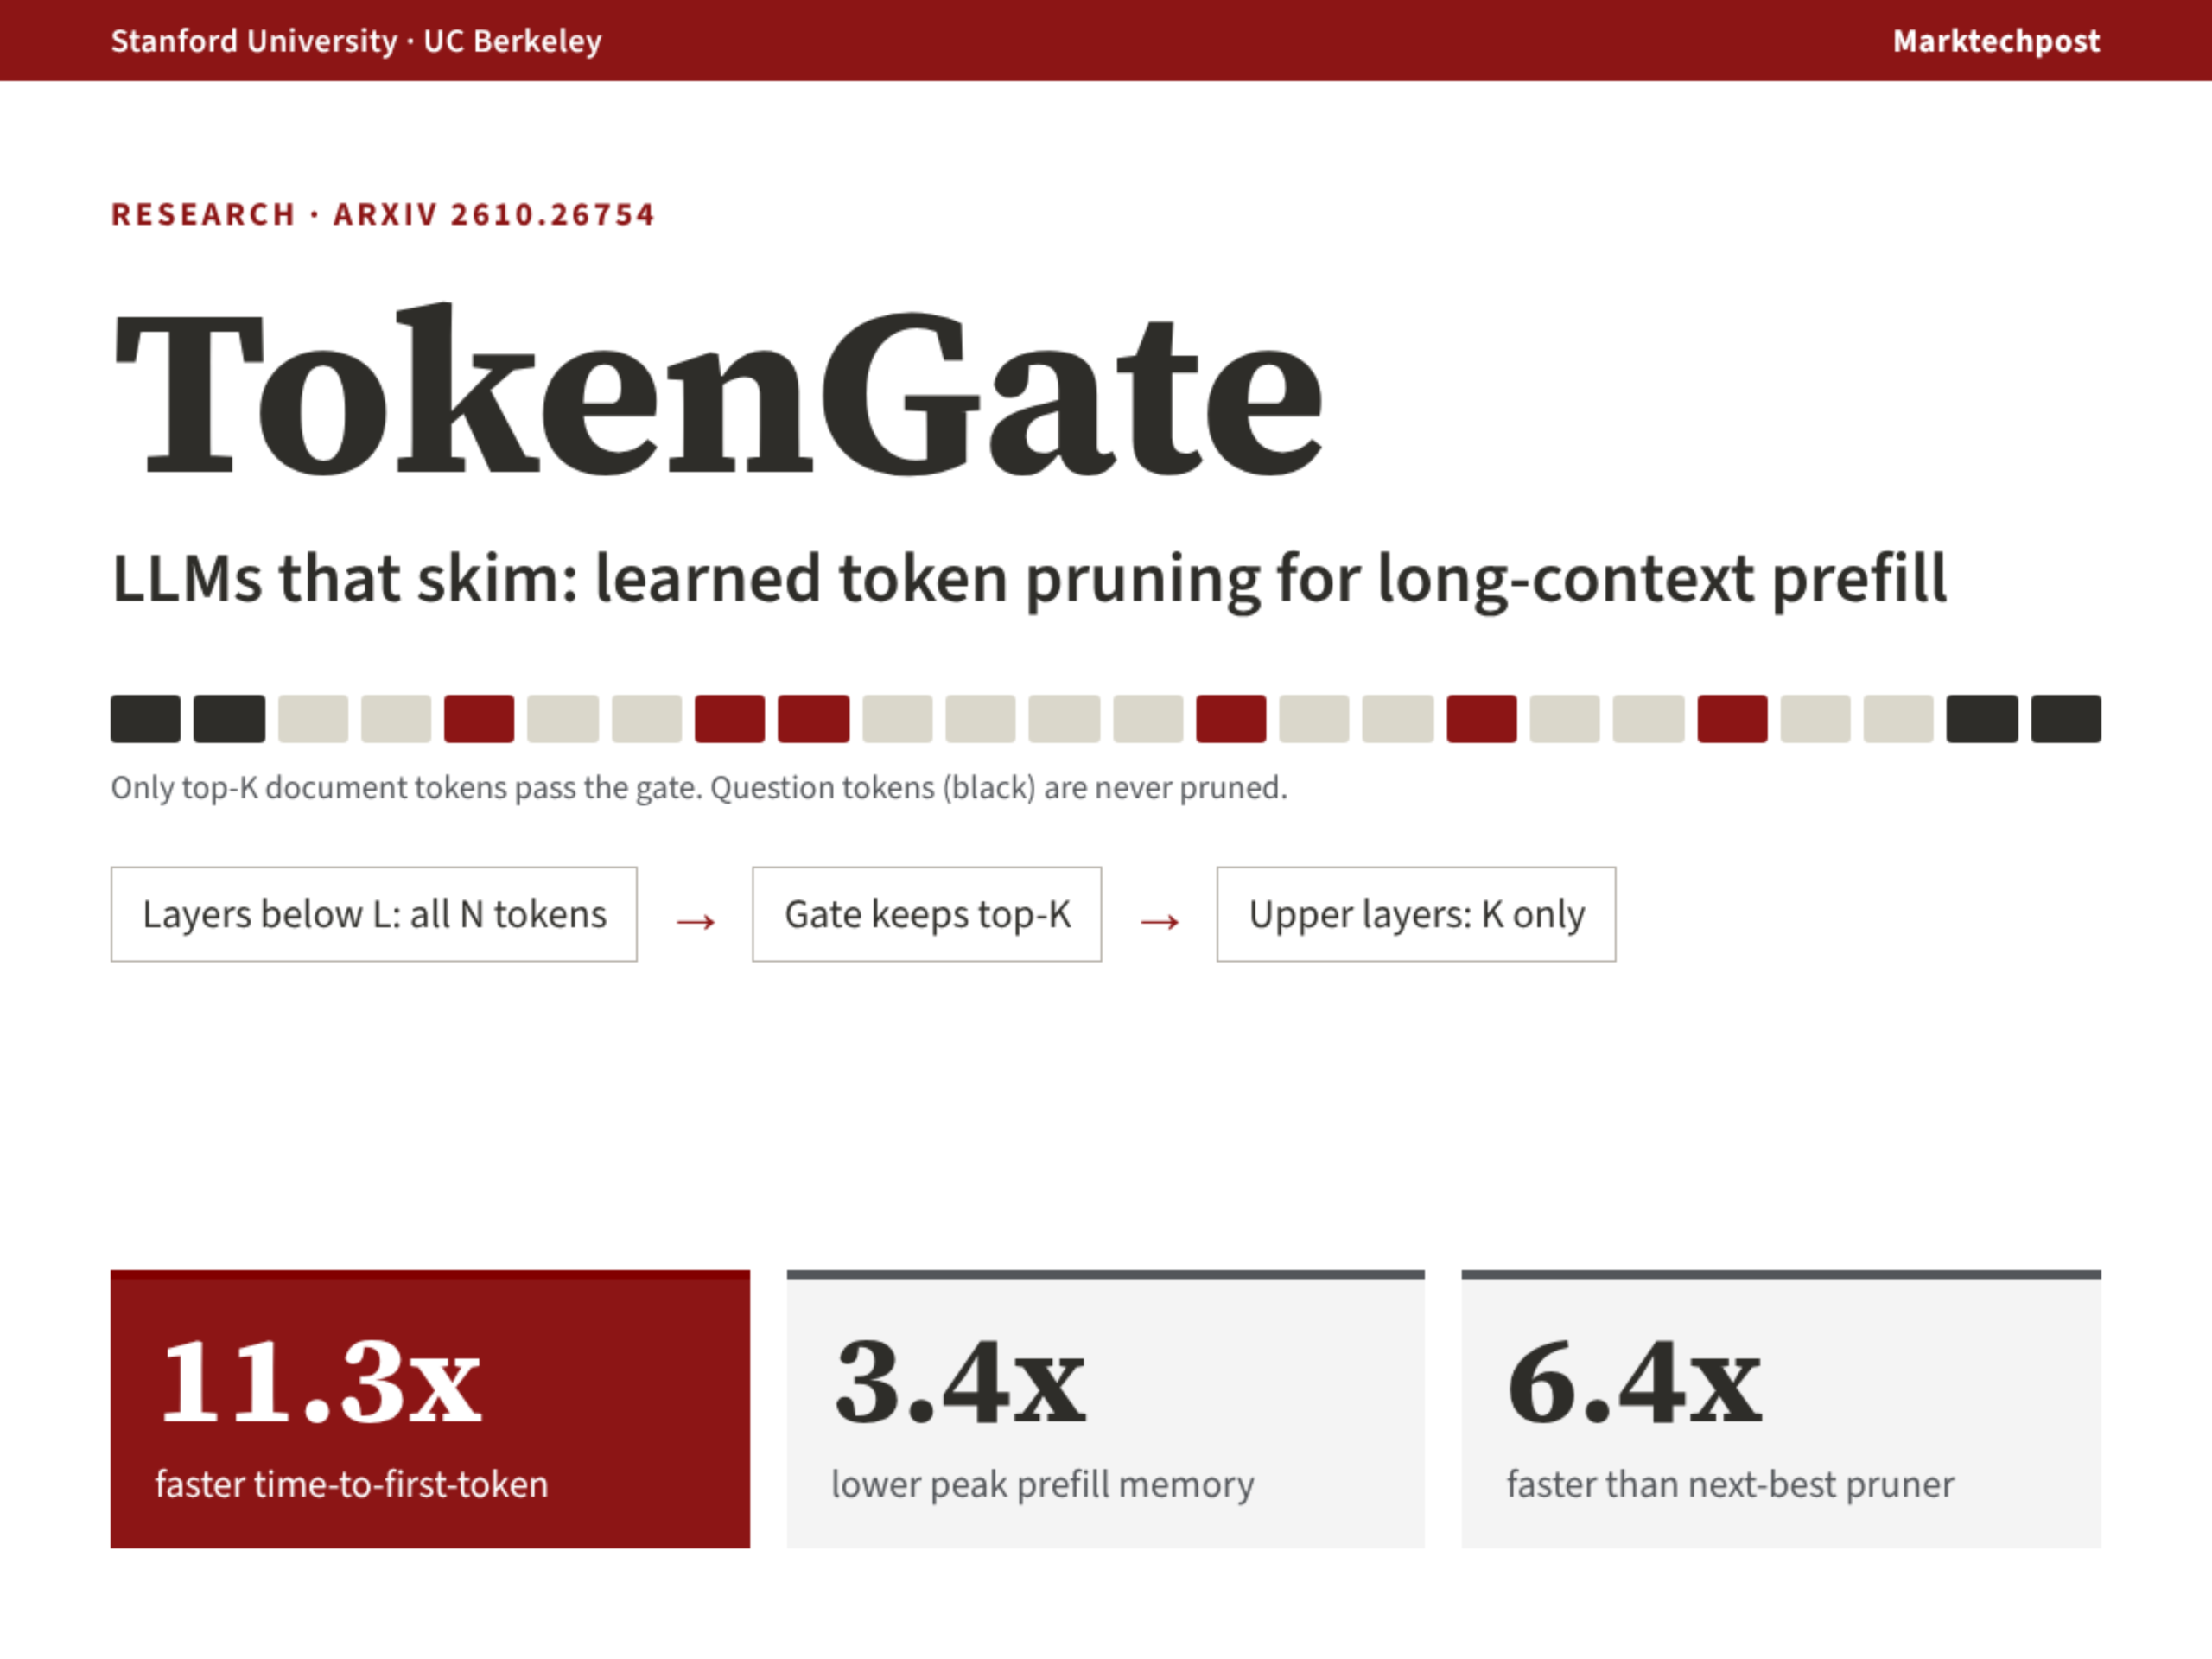
Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

新たな研究により、オープンブックの評価は主に読書行動を測定するものであり、知識の蓄積を測るものではないことが明らかになった

2026年10月24日に公開されたarXiv論文(2610.31017v1)は、文書レベルのLoRAアダプター評価において、オープンブックスコアリングはアダプターが対象文書の知識を実際に符号化しているかどうかよりも、モデルの即時読解能力に強く依存していることを示していると指摘している。ランダムなアダプターは、オープンブックタスクにおいて専門家向けアダプターの優位性の82%を再現できるが、ソーステキストを持たないクローズタスクではわずか2%しか再現できず、統計的にゼロと区別できないという結果となった。

Mostly Reading: What Open-Book Scores Measure in Document-Level LoRA Adapters

注目する理由:本研究は、系統的な制御実験(Wikipedia記事150件、Llama-3.1-8B-Instructモデル、二重タスク比較)を通じて、現在のオープン書評価パラダイムの根本的な限界を明らかにした。すなわち、この手法では「読むこと」と「記憶すること」を効果的に区別できず、知識編集型および検索型アダプターの実際の有用性に対して方法論上の課題をもたらしている。さらに、論文では「一見きれいだが誤った結果」を招く静かなエラーが4つ報告されており、再現性に関するリスクが浮き彫りになっている。

経緯と関連報道