本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

FlatCake:大規模言語モデルのサービス向けフラットなKVキャッシュストレージアーキテクチャ

arXiv:2610.38355v1 発表タイプ:新規 要旨:KVキャッシュの再利用は大規模言語モデルのサービスを加速させるが、既存のシステムではホストのDRAMとNVMe SSDを階層的なヒエラルキーとして管理しており、DRAMが中間キャッシュとして機能している。しかし、実際の大規模言語モデルのワークロードは、この階層構造の二つの前提をいずれも破っている。第一に、バイモーダルな再利用によりDRAMの時間的フィルタリングが無効化される。というのも、ワークロードは長い再利用距離を持つワンショットブロックか、DRAM容量を超える数ギガバイト規模のエージェントセッションによって支配されており、その結果SSDが重要な読み取りパスに置かれているからである。第二に、DRAMによるステージングと、排出現象に基づくレイアウトがSSDの復元処理をボトルネックにしている。進行中のプレフィックスのためにホストのステージングバッファを保持すると、負荷下で競合が生じてプリフェッチが中断されてしまう一方で、段階的な排出現象によってセッション内のブロックがSSD全体に散らばり、大規模なシーケンシャルリードが妨げられる。我々は…
経緯と関連報道

解説を読まずにスコアリングを行う:自動解釈可能性評価における構造的ショートカット

arXiv:2610.37676v1 公表タイプ:新規 要旨:自動解釈可能性は、スパースオートエンコーダー(SAE)の特徴について、評価例に対してその特徴がどの位置で活性化するかをトークンごとに予測させたり、マークされたトークンがその特徴に適合しているかどうかを判定させたりすることで、解説を評価します。我々は、評価データの標準的な処理パイプラインのみを用いても、解説を読まないままスコアリングが可能であることを示しました。Neuronpediaに保存されているGPT-2 smallモデルのランダムな500個の特徴に対するファジング実行において、活性化した例の91.3%が中心トークン上でピークを持つように切り取られており、さらに中心トークンがマークされていれば「はい」と判定するルールは、パイプラインのコードから再構築されたマークに基づいて計算した結果、保存済みのLLMスコアラーの0.838に対し、バランスのとれた精度0.979を達成しています。一方、マーク数のみを参照するルールでは0.969を記録しました。T

経緯と関連報道

Anthropicが世界No.1のLLMを安全に提供する方法:脳と手を分離する

ケイトリン・レスとアンジェラ・ジ앙がLatent Spaceに登場し、Claudeプラットフォームの背後にある技術について解説します。Opus 5.5のリリース、モデルの「脳」とエージェントの「手」の分離、APIのスケーリング、そして信頼性の高いマネージドエージェントの構築について語ります。新たな導入部分では……

How Anthropic ships the #1 LLM in the World safely: Separating the Brain from the Hands — Latent Space social card
経緯と関連報道

Mirendilが、1,000万トークンのコンテキストを備えた初のモデルであるFern 0.1をリリース

Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

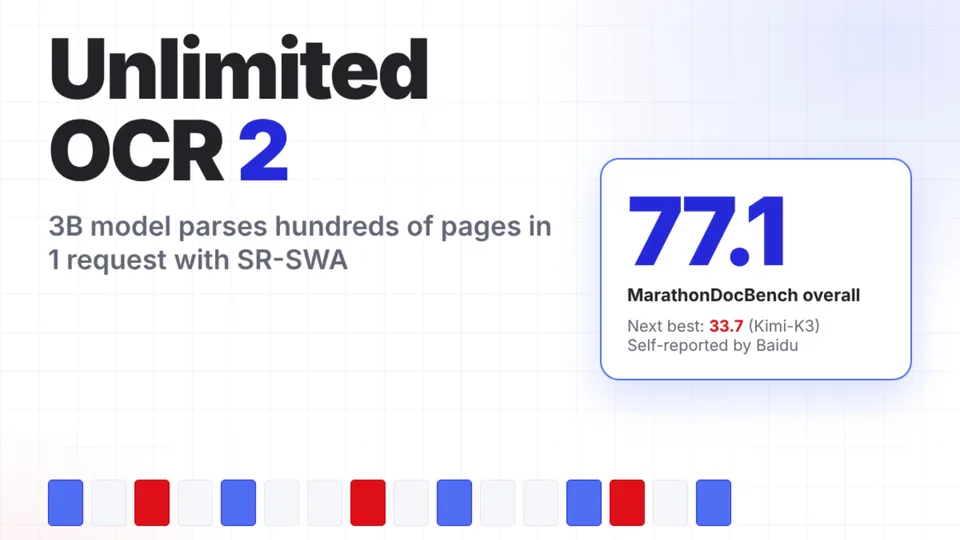
百度が、数百ページに及ぶ文書の解析向けのUnlimited OCR 2をオープンソース化

Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

プレフィックスのキーと値は後から重要になる:ループ型言語モデルにおける自己推測デコード向けRIPEキャッシュ

arXiv:2610.34436v1 発表タイプ:新規 要旨:ループ型言語モデルは、各トークンに対して層のブロックを$R$回実行するため、そのキーバリューキャッシュ(KVキャッシュ)には各再帰層ごとに$R$個の平面が格納され、自己予測的デコーディング(一部のループで予備的に推論し、残りの$R$すべてで検証する手法)ではそれらすべてが読み込まれる。我々は、プレフィックスのキーとバリューが影響を及ぼすのは後半に集中していることを発見した。同程度の摂動サイズにおいて、ループ25〜32はループ2〜9に比べてそれぞれ$e^{15.0}$倍(Huginn-0125)および$e^{12.8}$倍(Raven-Llama)も敏感であり、各ループごとの平面数は0.88および0.81という比率で最終的な平面へと幾何級数的に近づいていく。そして、最も深い平面単独で十分かどうかは、後半の平面がどれほど成熟しているかに依存する。Ravenでは、それを保存するだけでbf16からfp32への変更と区別できない一方、Huginnでは、全体の誤差の74%をわずか1%の位置が占めている。これをRIPEに展開すると、最も深い…

経緯と関連報道