本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

シーケンシングプロトコル理解におけるAIエージェントの評価と改善

arXiv:2610.37851v1 発表タイプ:新規 要旨:既存の科学系エージェントベンチマークでは、カスタマイズされたシーケンシングアッセイの解析に不可欠な、シーケンシングプロトコルで指定された正確な分子構造および生成ワークフローを再構築できるかどうかを評価するケースはほとんどありません。そこで私たちは、シーケンシングライブラリの構造と分子ワークフローの再構築を目的とした文書ベースのベンチマークであるLibStructBenchを提案します。実験結果から、最先端のエージェントは概ね正しい再構築を行えるものの、特に分子状態の表現やワークフローの接続性において、正確な再構築には依然として信頼性が不足していることが明らかになりました。また、基盤となる言語モデルを切り替えた場合の方が、エージェントハーネスを変更した場合よりも平均的な性能差が大きく、統計的に有意な差が認められました。
経緯と関連報道

解説を読まずにスコアリングを行う:自動解釈可能性評価における構造的ショートカット

arXiv:2610.37676v1 公表タイプ:新規 要旨:自動解釈可能性は、スパースオートエンコーダー(SAE)の特徴について、評価例に対してその特徴がどの位置で活性化するかをトークンごとに予測させたり、マークされたトークンがその特徴に適合しているかどうかを判定させたりすることで、解説を評価します。我々は、評価データの標準的な処理パイプラインのみを用いても、解説を読まないままスコアリングが可能であることを示しました。Neuronpediaに保存されているGPT-2 smallモデルのランダムな500個の特徴に対するファジング実行において、活性化した例の91.3%が中心トークン上でピークを持つように切り取られており、さらに中心トークンがマークされていれば「はい」と判定するルールは、パイプラインのコードから再構築されたマークに基づいて計算した結果、保存済みのLLMスコアラーの0.838に対し、バランスのとれた精度0.979を達成しています。一方、マーク数のみを参照するルールでは0.969を記録しました。T

経緯と関連報道

Mirendilが、1,000万トークンのコンテキストを備えた初のモデルであるFern 0.1をリリース

Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

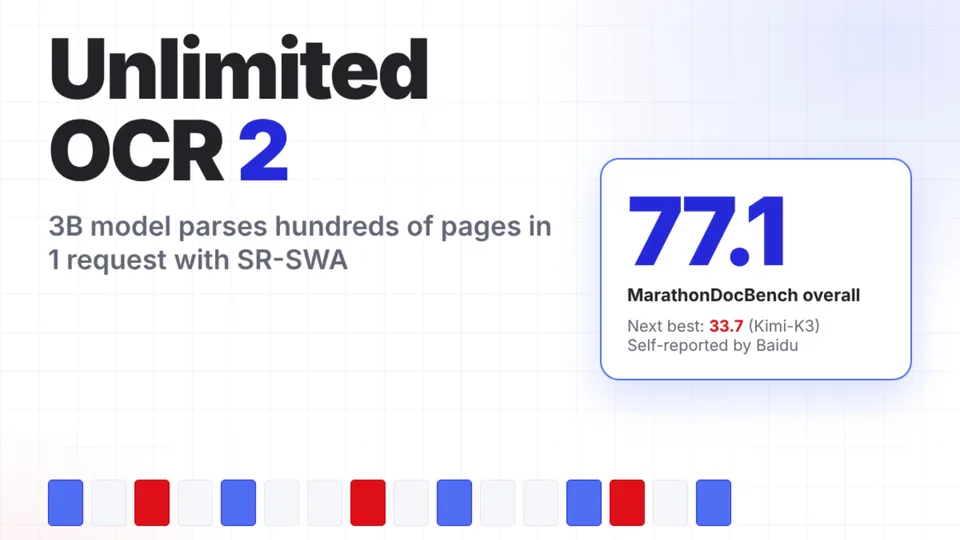
百度が、数百ページに及ぶ文書の解析向けのUnlimited OCR 2をオープンソース化

Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

ソーシャルワールドモデル評価のギャップ

arXiv:2610.33014v1 発表タイプ:新規 要旨:交渉支援システムは、相手の反応を正確に予測しなくても良好な取引を成立させることができる。そこで、社会的世界モデルに対する評価がその予測を直接検証しているのかという疑問を提起する。1999年から2026年にかけて発表された113件の研究を調査したところ、9件の主要な評価では、システムまたは実験者が選択した行動に対する実際の人の反応が測定されていた。そのうち、明示的な反応予測と実際の反応を比較しているのはわずか2件であり、しかもそれらの予測手法は行動選択時に利用可能な情報を用いており、評価対象の反応は適合過程から除外されていた上、介入手法もランダム化されていた。さらに、言語モデルに関する25件の研究について全文を個別に確認した結果、これらの条件を満たす実験は見当たらなかった。他の評価は、現状推論やタスク成功、あるいは予測機能の評価を行っているにすぎない。

経緯と関連報道

改ざんされた機械学習:大規模言語モデルによる機械学習研究の評価

arXiv:2610.32114v1 公表タイプ:新規 要旨:AIアライメントの進展を加速する一つの手法は、アライメント研究そのものの一部を自動化することである。そのためには、研究提案における欠陥の特定や、提案された実験が意図した主張を支持するかどうかの評価といった、監督が困難な研究課題に対しても信頼性高く機能するシステムが必要となる。この能力を評価するため、我々はTampered MLを導入する。これは、公開されている機械学習論文から再構成された実験提案と、目的とした方法論的欠陥を導入した最小限に編集された対照案からなる、1,858組の項目ペアからなるベンチマークである。モデルは、提示順序に関わらず、より方法論的に妥当な提案を識別しなければならない。層化抽出サンプルに基づく人間による検証研究では、全体の86%が…

経緯と関連報道