本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

llama.cpp · b12038

ggml:AVX512 BF16 を使用した clang-cl ビルドを修正(#31276)* clang-cl および avx512bf16 でビルドする際に immintrin.h のインクルードを正しく制御 * ggml:clang-cl 用に明示的なベクトルキャストを追加 **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12038/llama-b12038-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI 有効)[無効化](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12038/llama-b12038-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12038/llama-b12038-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12038/lla

経緯と関連報道

qwenGPUにようこそ:45層のコンパイル済みGPUレイヤーを備えたQwen3.5-2B、CUDAで動作

qwenGPUは、4レーンのSIMT GPUをQwen3.5-2Bに45層の未学習レイヤーとしてコンパイルします。このモデルは、Gated DeltaNet状態をレジスタやメモリとして利用し、実際のCUDA起動の各ステップを自ら書き出します。記事「qwenGPUにようこそ:45層のコンパイル済みGPUレイヤーを備えたQwen3.5-2B、CUDAで動作」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

llama.cpp · b12032

sycl:LevelZeroのインクルード/ライブラリについてはPkgConfigを試してみてください(#31076) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12032/llama-b12032-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効化済み](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12032/llama-b12032-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12032/llama-b12032-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12032/llama-b12032-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12032/

経緯と関連報道

llama.cpp · b12029

mtmd:InternVLのCLSトークン順序を修正(#30886) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12029/llama-b12029-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効化](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12029/llama-b12029-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12029/llama-b12029-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12029/llama-b12029-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12029/llama-b12029-b

経緯と関連報道

llama.cpp · b12028

テスト:`test-llama-archs`でGemma 4を有効化(#31401)* テスト:`test-llama-archs`でGemma 4を有効化* テスト:`test-llama-archs`でGemma 4にGQAを使用**ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12028/llama-b12028-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI対応)[無効化](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12028/llama-b12028-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12028/llama-b12028-xcframework.zip)**Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12028/llama-b12028-bin-ubuntu-x64.

経緯と関連報道

llama.cpp · b12027

llama:LFM3向けにテンソル分割を有効化(#31431) 補助者:Claude Opus 5.5 **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12027/llama-b12027-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12027/llama-b12027-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12027/llama-b12027-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12027/llama-b12027-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/

経緯と関連報道

llama.cpp · b12024

2Dテンソルを3Dテンソルではなく2Dとしてリシェイプする、lfm sc向け(#30831) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12024/llama-b12024-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12024/llama-b12024-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12024/llama-b12024-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12024/llama-b12024-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12

経緯と関連報道

llama.cpp · b12022

サーバー:/v1/responses エンドポイントが extra_params を受け付けるように修正(#30959) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12022/llama-b12022-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI 有効)[無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12022/llama-b12022-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12022/llama-b12022-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12022/llama-b12022-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/downloa

経緯と関連報道

llama.cpp · b12020

opencl: fwht を追加(#31434) 共同著者:Li He **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12020/llama-b12020-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI 有効)[無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12020/llama-b12020-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12020/llama-b12020-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12020/llama-b12020-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12020/llama-b1202

経緯と関連報道

llama.cpp · b12018

sycl:CPYにおけるf32からq2_0/q4_0/q5_0への丸め処理を修正(#31120) **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12018/llama-b12018-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/download/b12018/llama-b12018-bin-macos-x64.tar.gz) - [iOS XCFramework](https://github.com/ggml-org/llama.cpp/releases/download/b12018/llama-b12018-xcframework.zip) **Linux:** - [Ubuntu x64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12018/llama-b12018-bin-ubuntu-x64.tar.gz) - [Ubuntu arm64(CPU)](https://github.com/ggml-org/llama.cpp/releases/download/b12018/ll

経緯と関連報道

AIに支配されるのを拒む!アップル新トップ、テルヌス氏の“硬派”な製品宣言

IT之家 10月31日付の報道によると、『Wired』は昨日(10月30日)、アップルの現最高経営責任者ジョン・テルヌス氏へのインタビュー記事を掲載し、同社の製品の今後の方向性やAI分野の発展などについて議論を交わしました。製品面では、テルヌス氏はインタビューの中で自らを「プロダクト志向のCEO」だと繰り返し強調しています。彼は製品を愛し、ハードウェアと細部へのこだわりを重視しており、アップルが引き続き「人々に心から好かれる…」という魅力で勝負していくことを望んでいます。

拒绝被AI绑架!苹果新掌门特努斯的“硬核”产品宣言
経緯と関連報道

b12007

kv-cache:GPU上で回転定数を保持する(#31073) * kv-cache:GPU上で回転定数を保持する 補助者:Codex * tests:常駐KV回転バッファを検証する 補助者:Codex * kv-cache:残るマルチデバイス間の回転処理について文書化する 補助者:Codex * kv-cache:層ごとの回転バッファをサポートする 補助者:Codex * kv-cache:ハイブリッドSWAの回転入力と混合配置チェックを修正する 補助者:Codex * models:mistral-large4およびdflashで層ごとの回転を使用する * tests:回転バッファに関するテストを削除 --------- 共同執筆者:Pascal **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b12007/llama-b12007-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効](ht

経緯と関連報道

b11982

hexagon:UPSCALEオペレーションのサポート(#31331) * hex-upscale:基本的なアップスケール操作(完全なベクトル化はされていません) * hex-upscale:近隣2倍、4倍およびバイリニア4倍の最適化 * hex-upscale:連続していない行や次元の縮小に対応する機能を追加 * hex-upscale:スカラーによるステージングの代わりにvgatherを使用 * hex-upscale:カーネル選択ロジックをすべてホスト側に移動し、コメントの見直しとコードの整理を行います * テスト:qwen3-vlの画像→テキストシナリオをカバーするため、順列変換されたUPSCALEテストを追加 **ウェブサイト:** - **証明書:** - **macOS/iOS:** - [macOS Apple Silicon(arm64)](https://github.com/ggml-org/llama.cpp/releases/download/b11982/llama-b11982-bin-macos-arm64.tar.gz) - macOS Apple Silicon(arm64、KleidiAI有効)[無効](https://github.com/ggml-org/llama.cpp/pull/23780) - [macOS Intel(x64)](https://github.com/ggml-org/llama.cpp/releases/downloa

経緯と関連報道

Anthropicは、AIブームを支えるためにガスを燃やしている

上場準備を進めるなか、AnthropicのS-1届出書は、生成AIがメタンに依存している現状を露骨に示している。「電力供給へのアクセスや、十分な電力供給が確保できるデータセンターの立地を巡る競争は激化している。」米証券取引委員会に月曜日提出された文書において、Anthropicは、データセンターがますます「天然ガス」に依存するようになっていることを認めている[…]

Anthropic is burning gas to feed the AI boom
経緯と関連報道

llama.cpp がバージョン b11871 をリリース:サービスのクラッシュを防ぐため、JSON のネスト深度に制限を追加

llama.cpp のバージョン b11871 では、重要なセキュリティ修正が導入され、リクエスト内の JSON のネスト階層に対して 128 層のハード制限を設けることで、深い再帰的解析による HTTP スレッドスタックのオーバーフローおよびサービスのクラッシュ(macOS では SIGBUS、Linux では SIGSEGV をトリガー)を防止しています。この対策は、chat インターフェースの複数の入力シナリオに適用され、統一的に HTTP 400 エラーを返します。

経緯と関連報道

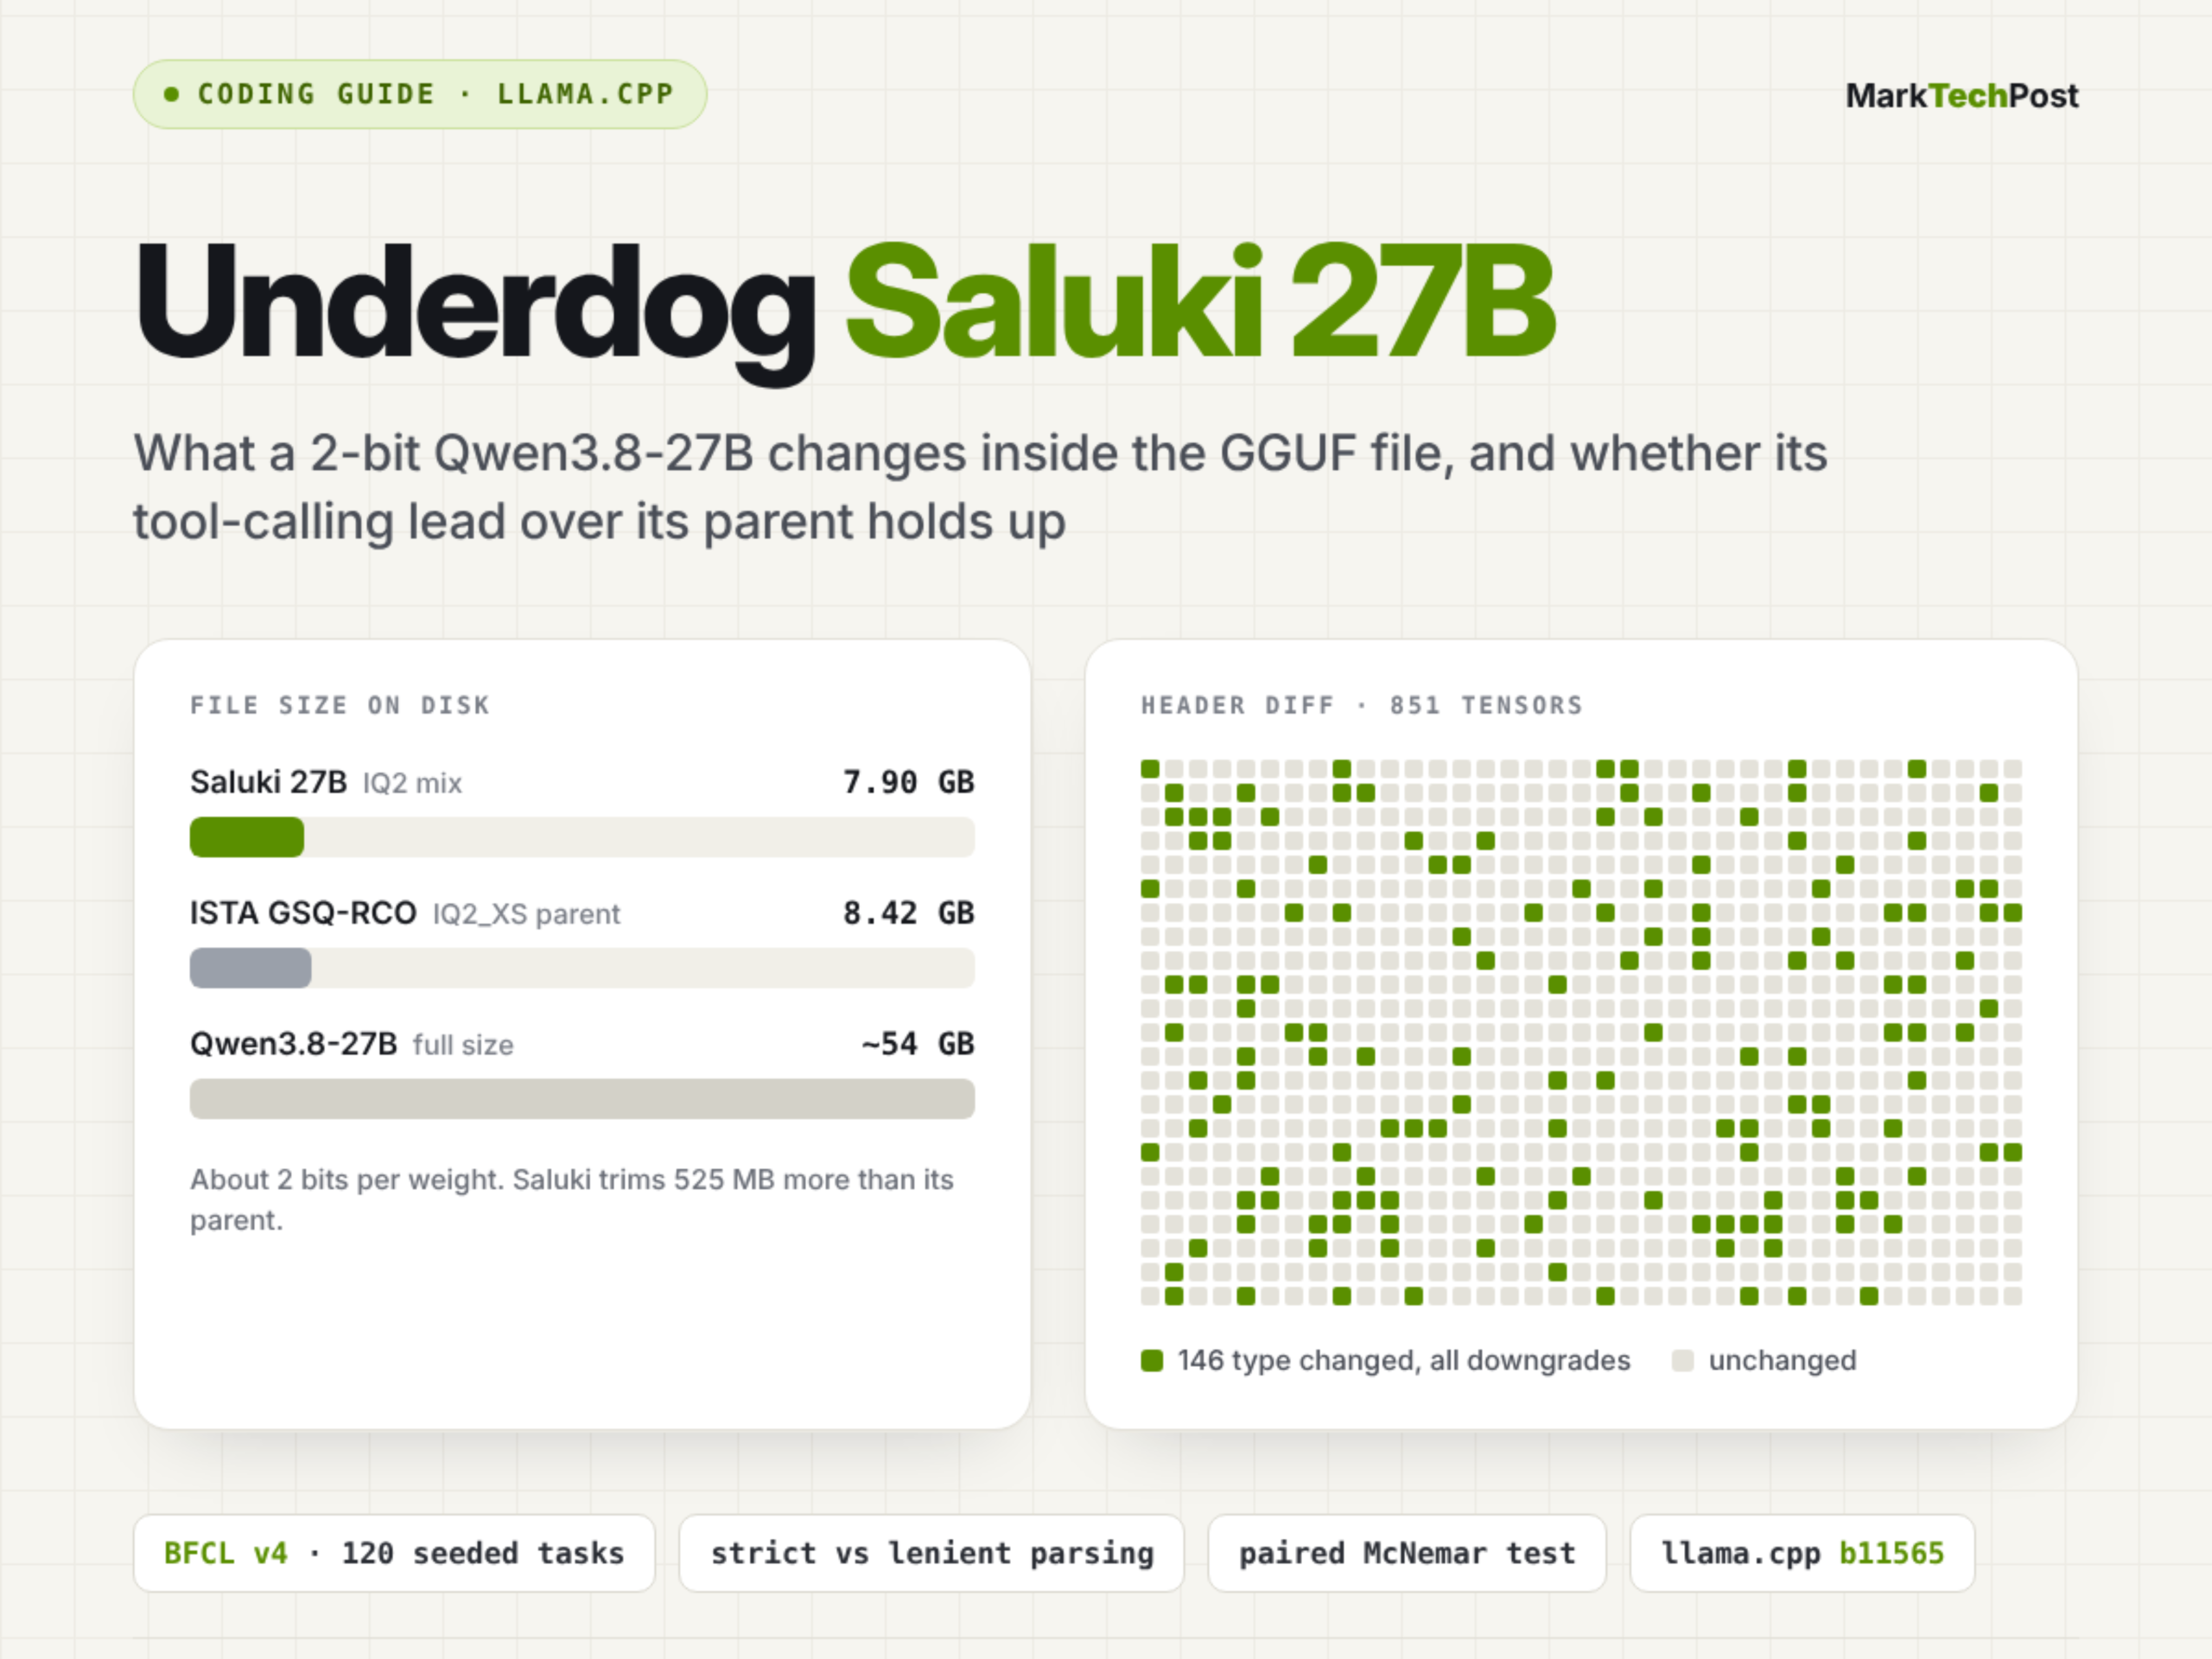
アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

llama.cpp が b11870 バージョンをリリースし、DeepSeek-V4.1-Flash モデルを正式にサポートしました

llama.cppはバージョンb11870において、DeepSeek-V4.1-Flash(deepseek41)モデルへの対応を追加し、そのEngramアーキテクチャに対してKVキャッシュ計算の簡略化、BF16精度によるMXFP8代替、in-graph行gatherなど、複数の低レベル最適化を施しました。同時に、macOS、Linux、Windows、Android、iOSおよびopenEulerを網羅するマルチプラットフォームのバイナリビルドも提供しています。

経緯と関連報道

llama.cpp がバージョン b11869 をリリース:Jinja テンプレート関数の引数処理を修正し、マルチプラットフォーム対応のバイナリを新たに追加

llama.cpp プロジェクトはビルドバージョン b11869 をリリースしました。主な修正点は、Jinja テンプレートにおける select 関数および selectattr 関数の引数解析ロジックであり、macOS、Linux、Windows、Android、iOS、および openEuler に対応した数十種類のハードウェアとバックエンドの組み合わせをカバーするプリコンパイル済みバイナリパッケージを提供しています。

経緯と関連報道

llama.cpp が b11868 バージョンをリリース:Hexagon NPU のマルチコア Flash Attention に対するサポートを強化し、全プラットフォームでのコンパイルとビルドを網羅

llama.cpp v2.45.0(タグ b11868)が正式にリリースされ、主要な更新点として、Hexagon バックエンドに KV-head のグループ分割メカニズムを導入してマルチコア HMX Flash Attention の性能を最適化し、FA の分割制御フラグを統一しました。同時に、macOS、Linux、Windows、Android、iOS、openEuler など、全プラットフォーム向けのバイナリパッケージを提供しており、CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)など、複数のバックエンドに対応しています。

経緯と関連報道

llama.cpp がバージョン b11867 をリリース:サーバーエンジンのエントリーポイントを再構築し、マルチプラットフォームと異種アクセラレーションバックエンドを全面的にサポート

llama.cpp が GitHub 上で正式にバージョン b11867 をリリースしました。主要な変更点として、サーバー側のエントリーポイントの再構築(PR #31113)と、server_role 機構の追加が挙げられます。また、macOS、Linux、Windows、Android、iOS、openEuler を対象とした 40 種類以上の事前ビルド済みバイナリパッケージを提供しており、CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)など、多様なハードウェアバックエンドをサポートしています。

経緯と関連報道